
모험심 넘치는 탐험가가 되어 광활하고 신비로운 아마존의 세계로 거침없이 뛰어드는 모습을 상상해 보세요. 열대우림이 아니라 온라인 소매업계의 거대 기업인 아마존 말입니다. 클릭할 때마다 값진 보물을 발견하고, 데이터라는 미지의 영역을 더 깊이 탐험하게 됩니다.
이 짜릿한 탐험을 위해 아마존 웹 스크래핑이라는 빽빽한 디지털 정글을 헤쳐 나가는 단계별 가이드를 소개합니다. 비교할 수 없는 정확도로 가치 있는 정보를 추출할 수 있도록 전문가의 팁과 요령을 갖추고, 그 어디에서도 경험할 수 없는 여정을 떠날 준비를 하세요.
목차
그러니 용기를 내고 가상 부츠를 단단히 신은 뒤, 데이터 중심의 모험을 함께 시작해 봅시다!
아마존에서 스크래핑할 데이터
아마존 상품과 관련된 데이터 항목은 다양하지만, 스크래핑할 때 중점적으로 살펴볼 주요 요소는 다음과 같습니다.
- 상품명
- 가격
- 할인액(해당하는 경우)
- 상품 요약
- 관련 기능 목록(있는 경우)
- 리뷰 평점
- 상품 이미지
아마존 상품을 스크래핑할 때 고려해야 할 주요 항목은 위와 같지만, 추출하는 정보는 구체적인 목표에 따라 달라질 수 있다는 점에 유의해야 합니다.
기본 요구 사항
수프를 만들려면 알맞은 재료가 필요합니다. 마찬가지로 새로운 웹 스크래퍼를 만들 때도 몇 가지 구성 요소가 필요합니다.
- Python — 사용하기 쉽고 라이브러리가 다양해 Python은 웹 스크래핑에 가장 적합한 선택입니다. 아직 설치하지 않았다면 이 가이드를 참고하세요.
- BeautifulSoup — Python에서 사용할 수 있는 여러 웹 스크래핑 라이브러리 중 하나입니다. 간단하고 깔끔하게 사용할 수 있어 웹 스크래핑에 널리 사용됩니다. Python을 성공적으로 설치한 후 다음 명령어를 실행해 Beautiful Soup을 설치할 수 있습니다: pip install bs4
- HTML 태그에 대한 기본 이해 — 이 튜토리얼을 참고해 HTML 태그에 필요한 지식을 익히세요.
- 웹 브라우저 — 웹사이트에서 관련 없는 정보를 많이 걸러내야 하므로 필터링을 위해 특정 id와 태그가 필요합니다. Google Chrome이나 Mozilla Firefox 같은 웹 브라우저를 사용하면 해당 태그를 식별할 수 있습니다.
스크래핑 설정하기
시작하려면 Python이 설치되어 있는지 확인하세요. Python 3.8 이상이 없다면 python.org를 방문해 최신 버전을 다운로드하고 설치하세요.
다음으로 Amazon 웹 스크래핑 코드 파일을 저장할 디렉터리를 만드세요. 일반적으로 프로젝트용 가상 환경을 설정하는 것이 좋습니다.
macOS 및 Linux에서 가상 환경을 만들고 활성화하려면 다음 명령어를 사용하세요:
$ python3 -m venv .env $ source .env/bin/activateWindows 사용자는 명령어가 약간 다릅니다:
d:amazon>python -m venv .env d:amazon>.envscriptsactivate이제 필요한 Python 패키지를 설치할 차례입니다.
두 가지 주요 작업, 즉 HTML을 가져오고 관련 데이터를 추출하도록 HTML을 파싱하는 데 필요한 패키지가 필요합니다.
Requests 라이브러리는 HTTP 요청을 보내는 데 널리 사용되는 타사 Python 라이브러리입니다. 웹 서버에 HTTP 요청을 보내고 응답을 받기 위한 간단하고 사용자 친화적인 인터페이스를 제공합니다. 웹 스크래핑에 가장 잘 알려진 라이브러리일 것입니다.
하지만 Requests 라이브러리에는 한계가 있습니다. HTML 응답을 문자열로 반환하기 때문에 웹 스크래핑 코드를 작성할 때 상품 가격과 같은 특정 요소를 검색하기 어려울 수 있습니다.
이때 Beautiful Soup이 유용합니다. Beautiful Soup은 HTML 및 XML 파일에서 데이터를 추출하도록 설계된 Python 웹 스크래핑 라이브러리입니다. 태그, 속성 또는 특정 텍스트를 검색해 웹 페이지에서 정보를 가져올 수 있습니다.
두 라이브러리를 모두 설치하려면 다음 명령어를 사용하세요:
$ python3 -m pip install requests beautifulsoup4Windows 사용자는 명령어의 나머지 부분은 그대로 두고 ‘python3’을 ‘python’으로 바꾸세요:
d:amazon>python -m pip install requests beautifulsoup4Beautiful Soup 라이브러리의 버전 4를 설치한다는 점에 유의하세요.
이제 Requests 스크래핑 라이브러리를 테스트해 보겠습니다. amazon.py라는 새 파일을 만들고 다음 코드를 입력하세요:
import requests url = ' https://www.amazon.com/Bose-QuietComfort-45-Bluetooth-Canceling-Headphones/dp/B098FKXT8L' response = requests.get(url) print(response.text)파일을 저장한 다음 터미널에서 실행하세요.
$ python3 amazon.py대부분의 경우 원하는 HTML을 확인할 수 없습니다. Amazon이 요청을 차단하고 다음 응답을 반환합니다:
Amazon 데이터에 대한 자동화된 액세스를 논의하려면 [email protected]으로 문의하세요.response.status_code를 출력하면 200 성공 코드 대신 503 오류가 반환된 것을 볼 수 있습니다.
Amazon은 이 요청이 브라우저에서 온 것이 아님을 파악하고 차단합니다. 이러한 방식은 많은 웹사이트에서 흔히 사용됩니다. Amazon은 요청을 차단하고 500으로 시작하는 오류 코드나 때로는 400으로 시작하는 오류 코드를 반환할 수 있습니다.
간단한 해결 방법은 브라우저가 보내는 것처럼 보이는 헤더를 요청에 포함하는 것입니다.
경우에 따라 user-agent만 보내도 충분합니다. 다른 경우에는 accept-language 헤더와 같은 추가 헤더를 보내야 할 수 있습니다.
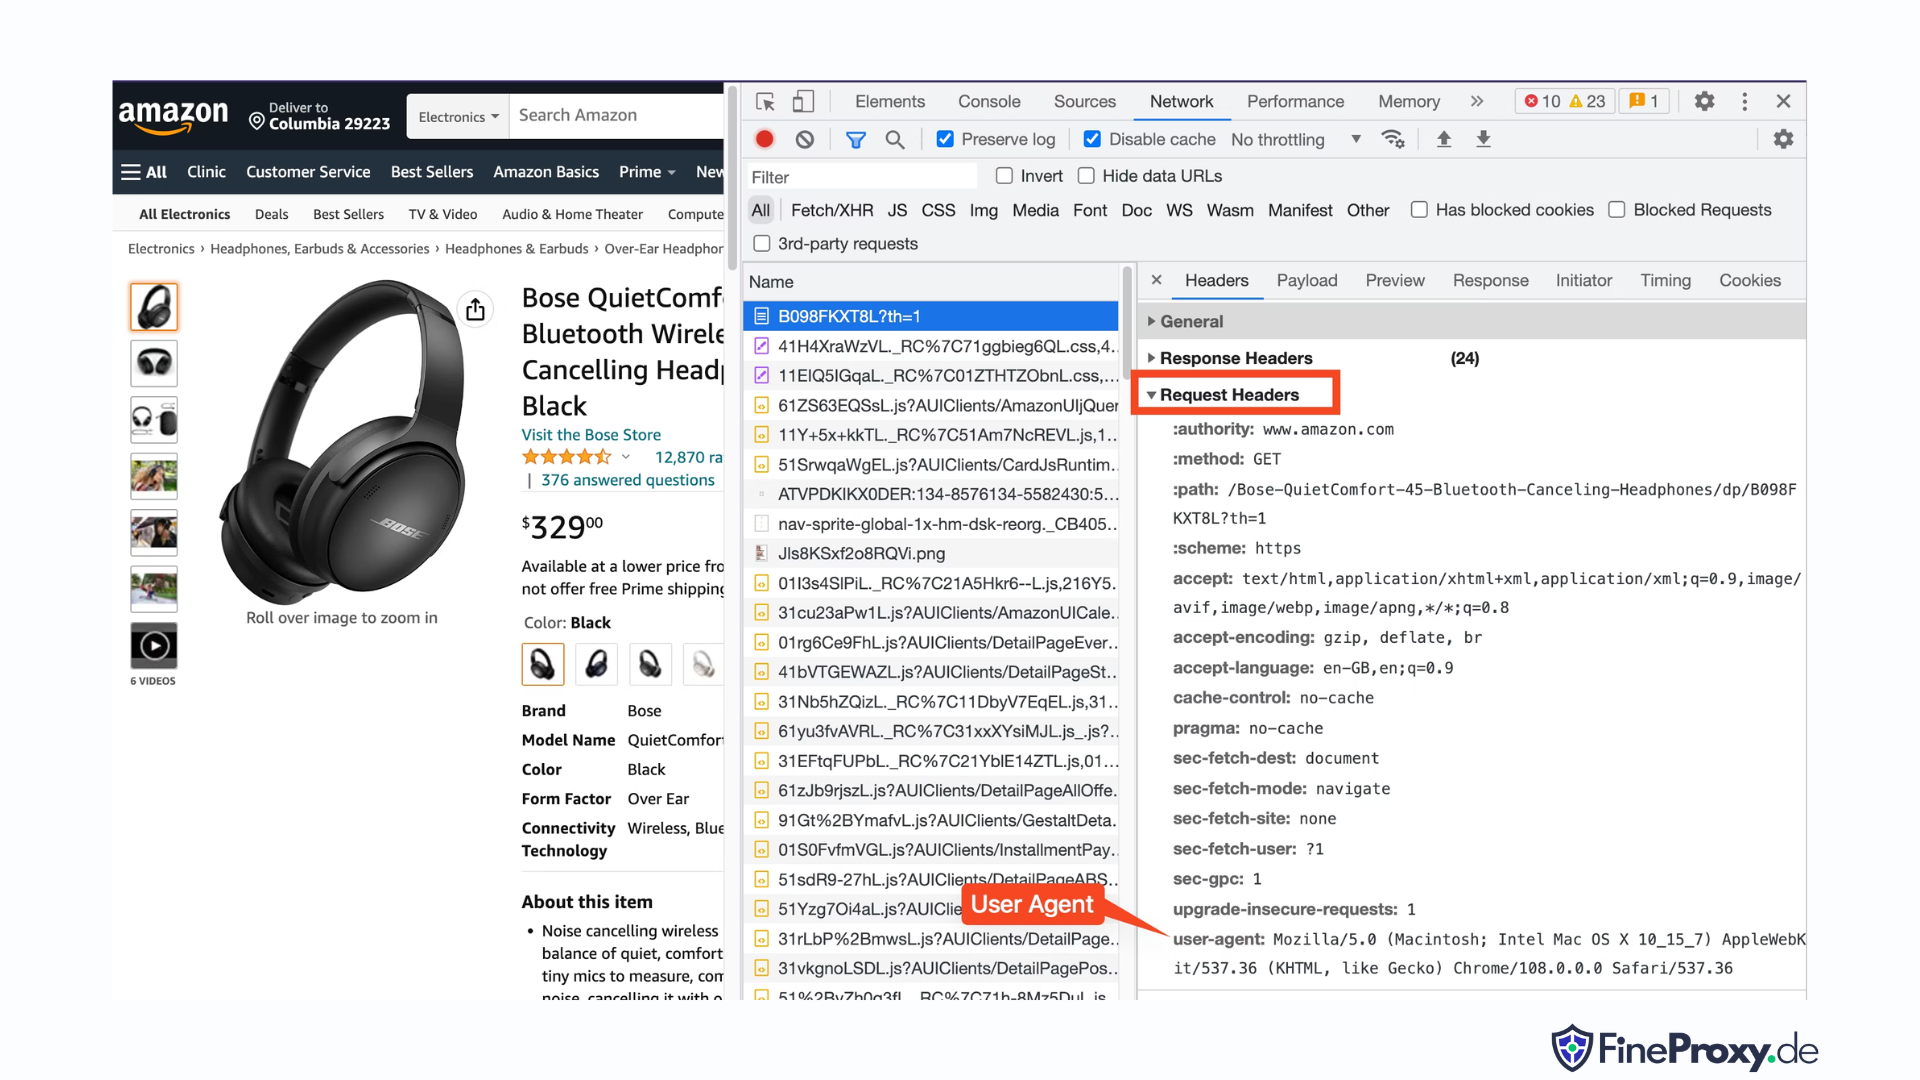
브라우저에서 보내는 user-agent를 찾으려면 F12 키를 누르고 Network 탭을 연 다음 페이지를 새로고침하세요. 첫 번째 요청을 선택하고 Request Headers를 살펴보세요.
이 user-agent를 복사한 다음, user-agent 및 accept-language 헤더를 포함하는 다음 예시처럼 헤더용 딕셔너리를 만드세요:
custom_headers = { ' user-agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/108.0.0.0 Safari/537.36', 'accept-language': 'en-GB,en;q=0.9', }그런 다음 이 딕셔너리를 get 메서드의 선택적 매개변수로 전달할 수 있습니다:
response = requests.get(url, headers=custom_headersAmazon 제품 정보 스크래핑
Amazon 제품을 웹 스크래핑할 때는 일반적으로 카테고리 페이지와 제품 상세 페이지, 두 가지 유형의 페이지를 다루게 됩니다.
예를 들어 https://www.amazon.com/b?node=12097479011를 방문하거나 Amazon에서 오버이어 헤드폰을 검색해 보세요. 검색 결과가 표시되는 페이지를 카테고리 페이지라고 합니다.
카테고리 페이지에는 제품명, 제품 이미지, 제품 평점, 제품 가격, 그리고 무엇보다 중요한 제품 URL 페이지가 표시됩니다. 제품 설명 등의 추가 정보를 확인하려면 제품 상세 페이지를 방문해야 합니다.
제품 상세 페이지의 구조를 살펴보겠습니다.
Chrome이나 다른 최신 브라우저에서 https://www.amazon.com/Bose-QuietComfort-45-Bluetooth-Canceling-Headphones/dp/B098FKXT8L와 같은 제품 URL을 엽니다. 제품명을 마우스 오른쪽 버튼으로 클릭하고 검사를 선택합니다. 제품명에 해당하는 HTML 마크업이 강조 표시됩니다.
id 속성이 “productTitle”로 설정된 span 태그임을 확인할 수 있습니다.
마찬가지로 가격을 마우스 오른쪽 버튼으로 클릭하고 검사를 선택하면 가격의 HTML 마크업을 볼 수 있습니다.
가격의 달러 부분은 클래스가 “a-price-whole”인 span 태그에 있고, 센트 부분은 클래스가 “a-price-fraction”인 다른 span 태그에 있습니다.
같은 방법으로 평점, 이미지, 설명도 찾을 수 있습니다.
이 정보를 수집한 후 기존 코드에 다음 줄을 추가합니다.
response = requests.get(url, headers=custom_headers) soup = BeautifulSoup(response.text, 'lxml')Beautiful Soup은 find 메서드를 사용해 태그를 선택하는 별도의 방법을 제공합니다. 대안으로 CSS 선택자도 지원합니다. 두 방법 중 어느 것을 사용해도 동일한 결과를 얻을 수 있습니다. 이 튜토리얼에서는 요소를 선택하는 범용적인 방법인 CSS 선택자를 사용합니다. CSS 선택자는 Amazon 제품 정보를 추출하는 거의 모든 웹 스크래핑 도구와 호환됩니다.
이제 Soup 객체를 사용해 특정 정보를 조회할 준비가 되었습니다.
제품명 추출
제품명 또는 제목은 id가 ‘productTitle’인 span 요소에 있습니다. 고유한 id를 사용하면 요소를 쉽게 선택할 수 있습니다.
다음 코드를 예로 살펴보세요.
title_element = soup.select_one('#productTitle')CSS 선택자를 select_one 메서드에 전달하면 요소 인스턴스가 반환됩니다.
텍스트에서 정보를 추출하려면 text 속성을 사용합니다.
title = title_element.text출력해 보면 공백이 몇 개 포함되어 있을 수 있습니다. 이를 해결하려면 다음과 같이 .strip() 함수 호출을 추가합니다.
title = title_element.text.strip()제품 평점 추출
Amazon 제품 평점을 가져오려면 약간의 추가 작업이 필요합니다.
먼저 평점 선택자를 지정합니다.
#acrPopover다음 문을 사용해 평점이 포함된 요소를 선택합니다.
rating_element = soup.select_one('#acrPopover')실제 평점 값은 title 속성에 있습니다.
rating_text = rating_element.attrs.get('title') print(rating_text) # prints '4.6 out of 5 stars'마지막으로 replace 메서드를 사용해 숫자 평점을 가져옵니다.
rating = rating_text.replace('out of 5 stars', '')제품 가격 추출
제품 가격은 제품 제목 아래와 지금 구매 상자 안, 두 곳에서 찾을 수 있습니다.
이 태그 중 하나를 사용해 Amazon 제품 가격을 스크래핑할 수 있습니다.
가격에 대한 CSS 선택자를 만듭니다.
#price_inside_buybox다음과 같이 이 CSS 선택자를 BeautifulSoup의 select_one 메서드에 전달합니다.
price_element = soup.select_one('#price_inside_buybox')이제 가격을 출력할 수 있습니다.
print(price_element.text)이미지 추출
기본 이미지를 스크래핑하려면 CSS 선택자 #landingImage를 사용합니다. 이 정보를 바탕으로 다음 코드 줄을 작성하면 src 속성에서 이미지 URL을 가져올 수 있습니다.
image_element = soup.select_one('#landingImage') image = image_element.attrs.get('src')제품 설명 추출
Amazon 제품 데이터를 추출하는 다음 단계는 제품 설명을 가져오는 것입니다.
과정은 동일합니다. CSS 선택자를 만들고 select_one 메서드를 사용합니다.
설명에 대한 CSS 선택자는 다음과 같습니다.
#productDescription이를 사용하면 다음과 같이 요소를 추출할 수 있습니다.
description_element = soup.select_one('#productDescription') print(description_element.text)제품 목록 처리
제품 정보를 스크래핑하는 방법을 살펴보았지만, 제품 데이터에 접근하려면 제품 목록 또는 카테고리 페이지에서 시작해야 합니다.
예를 들어 https://www.amazon.com/b?node=12097479011는 오버이어 헤드폰의 카테고리 페이지입니다.
이 페이지를 살펴보면 모든 제품이 고유한 속성 [data-asin]을 가진 div 안에 들어 있는 것을 볼 수 있습니다. 이 div 안에는 모든 제품 링크가 h2 태그에 있습니다.
이 정보를 바탕으로 한 CSS 선택자는 다음과 같습니다.
[data-asin] h2 a이 선택자의 href 속성을 읽고 반복문을 실행할 수 있습니다. 단, 링크가 상대 경로라는 점에 유의하세요. 이러한 링크를 분석하려면 urljoin 메서드를 사용해야 합니다.
from urllib.parse import urljoin ... def parse_listing(listing_url): … link_elements = soup_search.select("[data-asin] h2 a") page_data = [] for link in link_elements: full_url = urljoin(search_url, link.attrs.get("href")) product_info = get_product_info(full_url) page_data.append(product_info)페이지네이션 처리
다음 페이지로 연결되는 링크에는 “Next”라는 텍스트가 있습니다. 다음과 같이 CSS의 contains 연산자를 사용해 이 링크를 검색할 수 있습니다.
next_page_el = soup.select_one('a:contains("Next")') if next_page_el: next_page_url = next_page_el.attrs.get('href') next_page_url = urljoin(listing_url, next_page_url)Amazon 데이터 내보내기
스크래핑한 데이터는 의도적으로 사전 형식으로 반환됩니다. 스크래핑한 모든 제품을 담을 목록을 만들 수 있습니다.
def parse_listing(listing_url): ... page_data = [] for link in link_elements: ... product_info = get_product_info(full_url) page_data.append(product_info)그런 다음 이 page_data를 사용해 Pandas DataFrame 객체를 만들 수 있습니다.
df = pd.DataFrame(page_data) df.to_csv('headphones.csv', index = False)Amazon에서 여러 페이지 스크래핑하는 방법
Amazon에서 여러 페이지를 스크래핑하면 분석할 데이터 세트의 범위를 넓혀 웹 스크래핑 프로젝트의 효과를 높일 수 있습니다. 여러 페이지를 대상으로 할 때는 콘텐츠를 여러 페이지에 나누는 과정인 페이지네이션을 고려해야 합니다.
Amazon에서 여러 페이지를 스크래핑할 때 유념해야 할 6가지 핵심 사항은 다음과 같습니다.
- 페이지네이션 패턴 파악: 먼저 카테고리 또는 검색 결과 페이지의 URL 구조를 분석하여 Amazon이 콘텐츠를 어떻게 페이지별로 나누는지 파악합니다. 쿼리 매개변수(예: “?page=2”)일 수도 있고 URL에 포함된 고유 식별자일 수도 있습니다.
- “다음” 페이지 링크 추출: 다음 페이지로 연결되는 링크가 포함된 요소(대개 앵커 태그)를 찾습니다. 적절한 CSS 선택자나 Beautiful Soup 메서드를 사용해 해당 요소의 href 속성을 추출합니다. 이 속성이 다음 페이지의 URL입니다.
- 상대 URL을 절대 URL로 변환: 추출한 URL은 상대 URL일 수 있으므로
urllib.parse라이브러리의urljoin함수를 사용해 절대 URL로 변환합니다. - 반복문 만들기: 각 페이지를 순회하며 원하는 데이터를 스크래핑하는 반복문을 구현합니다. 현재 페이지에 “다음” 페이지 링크가 있는지 확인하여 더 이상 페이지가 없을 때 반복문이 종료되도록 합니다.
- 요청 사이에 지연 시간 추가: Amazon 서버에 과부하를 주거나 봇 방지 조치를 유발하지 않도록
time라이브러리의time.sleep()함수를 사용해 요청 사이에 지연 시간을 둡니다. 사람이 탐색하는 것처럼 보이도록 지연 시간을 조정합니다. - CAPTCHA 및 차단 처리: 여러 페이지를 스크래핑하는 도중 CAPTCHA가 나타나거나 IP가 차단되면 프록시를 사용해 IP 주소를 순환시키거나 이러한 문제를 자동으로 처리할 수 있는 전용 스크래핑 도구와 서비스를 고려합니다.
아래에서 Amazon 웹사이트의 여러 페이지에서 데이터를 추출하는 과정을 안내하는 포괄적인 YouTube 동영상 튜토리얼을 확인할 수 있습니다. 이 튜토리얼은 웹 스크래핑을 심층적으로 다루며, 수많은 Amazon 페이지에서 유용한 정보를 효율적이고 효과적으로 수집할 수 있는 기법에 초점을 맞춥니다.
튜토리얼 전반에서 진행자는 Python, BeautifulSoup, requests와 같은 필수 도구와 라이브러리의 사용법을 시연하고, Amazon의 봇 방지 메커니즘에 차단되거나 탐지되지 않기 위한 모범 사례를 소개합니다. 동영상에서는 페이지네이션 처리, 요청 속도 제한 관리, 사람처럼 보이는 탐색 동작 모방 등 핵심 주제를 다룹니다.
동영상에서 단계별 지침을 제공하는 것 외에도, 이 튜토리얼은 웹 스크래핑 경험을 최적화하는 데 유용한 팁과 요령을 공유합니다. 여기에는 프록시를 사용해 IP 제한을 우회하고, User-Agent와 요청 헤더를 무작위화하며, 스크래핑 과정이 원활하게 중단 없이 진행되도록 적절한 오류 처리를 구현하는 방법이 포함됩니다.
Amazon 스크래핑: 자주 묻는 질문
인기 전자상거래 플랫폼인 Amazon에서 데이터를 추출할 때는 유념해야 할 몇 가지 사항이 있습니다. Amazon 데이터 스크래핑과 관련해 자주 묻는 질문을 살펴보겠습니다.
1. Amazon을 스크래핑하는 것은 합법인가요?
인터넷에서 공개적으로 이용할 수 있는 데이터를 스크래핑하는 것은 합법이며, 여기에는 Amazon 스크래핑도 포함됩니다. 상품 세부 정보, 설명, 평점, 가격과 같은 정보는 합법적으로 스크래핑할 수 있습니다. 하지만 상품 리뷰를 스크래핑할 때는 개인정보와 저작권 보호에 유의해야 합니다. 예를 들어 리뷰 작성자의 이름과 아바타는 개인정보에 해당할 수 있고, 리뷰 텍스트는 저작권으로 보호될 수 있습니다. 이러한 데이터를 스크래핑할 때는 항상 주의를 기울이고 법률 자문을 구하세요.
2. Amazon은 스크래핑을 허용하나요?
공개적으로 이용할 수 있는 데이터를 스크래핑하는 것은 합법이지만, Amazon은 때때로 스크래핑을 방지하기 위한 조치를 취합니다. 이러한 조치에는 요청 속도 제한, IP 주소 차단, 브라우저 핑거프린팅을 통한 스크래핑 봇 탐지가 포함됩니다. Amazon은 보통 200 OK 성공 상태 응답 코드를 반환하며 웹 스크래핑을 차단하고, CAPTCHA를 통과하도록 요구하거나 유료 API에 대해 영업팀에 문의하라는 HTTP Error 503 Service Unavailable 메시지를 표시합니다.
이러한 조치를 우회하는 방법도 있지만, 윤리적인 웹 스크래핑을 하면 애초에 이러한 조치가 발동되는 것을 방지할 수 있습니다. 윤리적인 웹 스크래핑이란 요청 빈도를 제한하고, 적절한 사용자 에이전트를 사용하며, 웹사이트 성능에 영향을 줄 수 있는 과도한 스크래핑을 피하는 것을 의미합니다. 윤리적으로 스크래핑하면 Amazon에서 유용한 데이터를 추출하면서도 차단되거나 법적 처벌을 받을 위험을 줄일 수 있습니다.
3. Amazon 데이터를 스크래핑하는 것은 윤리적인가요?
윤리적인 스크래핑은 대상 웹사이트를 존중하는 방식으로 이루어집니다. 너무 많은 요청으로 Amazon 웹사이트에 과부하를 일으킬 가능성은 낮지만, 그래도 윤리적인 스크래핑 지침을 따라야 합니다. 윤리적인 스크래핑은 법적 문제에 직면하거나 스크래핑 방지 조치에 대응해야 할 위험을 최소화할 수 있습니다.
4. Amazon을 스크래핑할 때 차단을 피하려면 어떻게 해야 하나요?
Amazon을 스크래핑할 때 차단을 피하려면 요청 속도를 제한하고, 트래픽이 가장 많은 시간대에는 스크래핑을 피하며, 스마트 프록시 로테이션을 사용하고, 탐지를 피할 수 있도록 적절한 사용자 에이전트와 헤더를 사용해야 합니다. 또한 필요한 데이터만 추출하고 타사 스크래핑 도구나 스크래핑 라이브러리를 사용하세요.
5. Amazon 스크래핑의 위험은 무엇인가요?
Amazon 데이터 스크래핑에는 법적 조치나 계정 정지와 같은 잠재적 위험이 따릅니다. Amazon은 IP 주소 차단, 요청 속도 제한, 브라우저 핑거프린팅 등의 봇 방지 조치를 사용해 스크래핑을 탐지하고 차단합니다. 하지만 윤리적으로 스크래핑하면 이러한 위험을 완화할 수 있습니다.
결론
Amazon 웹 스크래핑이라는 매혹적인 미로에서 빠져나온 지금, 이 짜릿한 여정에서 얻은 소중한 지식과 기술을 되새겨볼 시간입니다. 믿음직한 안내자 ProxyCompass와 함께 거대 소매업체에서 귀중한 데이터를 추출하는 복잡한 과정을 성공적으로 헤쳐 나왔습니다. 새롭게 익힌 전문성을 능숙하게 활용하며 앞으로 나아갈 때, 디지털 정글은 끊임없이 변화한다는 사실을 기억하세요.
호기심을 잃지 말고, 웹 스크래핑 마체테를 계속 갈고닦으며, 끊임없이 변하는 데이터 추출의 지형을 정복해 나가세요. 다음 대담한 탐험에서 다시 만날 때까지, 용감한 탐험가여, 데이터에 기반한 여정이 결실을 맺고 보람차기를 바랍니다!