
Kendinizi maceracı bir kâşif olarak hayal edin; Amazon’un uçsuz bucaksız ve gizemli dünyasına, yani yağmur ormanlarına değil, çevrimiçi perakende devine balıklama dalıyorsunuz. Her tıklamayla paha biçilmez hazineleri keşfediyor, verilerin keşfedilmemiş topraklarının derinliklerine iniyorsunuz.
Bu heyecan verici keşif gezisinde, Amazon’un sık ve dijital ormanında gezinmeniz için adım adım bir rehber sunuyoruz. Değerli bilgileri benzersiz bir hassasiyetle çıkarmak için uzman ipuçları ve püf noktalarıyla donanmış olarak eşi benzeri olmayan bir yolculuğa çıkmaya hazırlanın.
İçindekiler
- Amazon’dan Hangi Veriler Çekilmeli
- Bazı Temel Gereksinimler
- Veri Çekme İçin Kurulum
- Amazon Ürün Bilgilerini Çekme
- Amazon’da Birden Fazla Sayfadan Veri Nasıl Çekilir
- Amazon’dan Veri Çekme: SSS
- Sonuç
Haydi, cesaretinizi toplayın, sanal botlarınızı giyin ve veriye dayalı maceramıza birlikte başlayalım!
Amazon’dan Hangi Veriler Çekilmeli
Bir Amazon ürünüyle ilişkili çok sayıda veri noktası vardır, ancak veri çekerken odaklanmanız gereken temel unsurlar şunlardır:
- Ürün Başlığı
- Fiyat
- Tasarruf (uygulanabilir olduğunda)
- Ürün Özeti
- İlgili özellik listesi (varsa)
- Değerlendirme puanı
- Ürün görselleri
Bir Amazon ürününden veri çekerken dikkate alınması gereken başlıca unsurlar bunlar olsa da, çıkaracağınız bilgilerin belirli hedeflerinize bağlı olarak değişebileceğini unutmamak önemlidir.
Bazı Temel Gereksinimler
Çorba hazırlamak için doğru malzemelere ihtiyacımız var. Benzer şekilde, yeni web veri çekicimiz de belirli bileşenlere ihtiyaç duyuyor.
- Python — Kullanım kolaylığı ve kapsamlı kütüphane koleksiyonu, Python’ı web’den veri çekme için en iyi seçenek hâline getiriyor. Henüz yüklü değilse bu kılavuza başvurun.
- BeautifulSoup — Bu, Python için kullanılabilen birçok web’den veri çekme kütüphanesinden biridir. Sadelığı ve temiz kullanımı, onu web’den veri çekme için popüler bir seçenek hâline getiriyor. Python’ı başarıyla yükledikten sonra şu komutu çalıştırarak Beautiful Soup’u yükleyebilirsiniz: pip install bs4
- HTML Etiketleri Hakkında Temel Bilgi — HTML etiketleri hakkında gerekli bilgileri edinmek için bu eğitime başvurun.
- Web Tarayıcısı — Bir web sitesindeki çok sayıda alakasız bilgiyi filtrelememiz gerektiğinden, filtreleme için belirli kimlikler ve etiketler gerekir. Google Chrome veya Mozilla Firefox gibi bir web tarayıcısı, bu etiketleri belirlemenize yardımcı olur.
Kazıma için Kurulum
Başlamak için Python'un yüklü olduğundan emin olun. Python 3.8 veya üzeri yüklü değilse, en son sürümü indirip yüklemek için python.org adresini ziyaret edin.
Ardından, Amazon için web kazıma kodu dosyalarınızı depolayacağınız bir dizin oluşturun. Projeniz için sanal bir ortam kurmak genellikle iyi bir fikirdir.
macOS ve Linux'ta sanal ortam oluşturmak ve etkinleştirmek için aşağıdaki komutları kullanın:
$ python3 -m venv .env $ source .env/bin/activateWindows kullanıcıları için komutlar biraz farklı olacaktır:
d:amazon>python -m venv .env d:amazon>.envscriptsactivateŞimdi gerekli Python paketlerini yükleme zamanı.
İki temel görev için paketlere ihtiyacınız olacak: HTML'yi edinmek ve ilgili verileri çıkarmak için ayrıştırmak.
Requests kütüphanesi, HTTP istekleri göndermek için yaygın olarak kullanılan üçüncü taraf bir Python kütüphanesidir. Web sunucularına HTTP istekleri göndermek ve yanıtları almak için anlaşılır ve kullanıcı dostu bir arayüz sunar. Web kazıma için belki de en bilinen kütüphanedir.
Ancak Requests kütüphanesinin bir sınırlaması vardır: HTML yanıtını bir dize olarak döndürür; bu da web kazıma kodu yazarken listeleme fiyatları gibi belirli öğeleri bulmayı zorlaştırabilir.
Beautiful Soup burada devreye girer. Beautiful Soup, HTML ve XML dosyalarından veri çıkaran, web kazıma için tasarlanmış bir Python kütüphanesidir. Etiketleri, öznitelikleri veya belirli metinleri arayarak bir web sayfasından bilgi almanızı sağlar.
Her iki kütüphaneyi de yüklemek için aşağıdaki komutu kullanın:
$ python3 -m pip install requests beautifulsoup4Windows kullanıcıları, komutun geri kalanını değiştirmeden ‘python3’ yerine ‘python’ yazın:
d:amazon>python -m pip install requests beautifulsoup4Beautiful Soup kütüphanesinin 4. sürümünü yüklediğimizi unutmayın.
Şimdi Requests kazıma kütüphanesini test edelim. amazon.py adlı yeni bir dosya oluşturun ve aşağıdaki kodu girin:
import requests url = ' https://www.amazon.com/Bose-QuietComfort-45-Bluetooth-Canceling-Headphones/dp/B098FKXT8L' response = requests.get(url) print(response.text)Dosyayı kaydedin ve terminalden çalıştırın.
$ python3 amazon.pyÇoğu durumda, istediğiniz HTML'yi görüntüleyemezsiniz. Amazon isteği engeller ve aşağıdaki yanıtı alırsınız:
Amazon verilerine otomatik erişimi görüşmek için lütfen [email protected] adresiyle iletişime geçin.response.status_code değerini yazdırırsanız, 200 başarı kodu yerine 503 hatası aldığınızı görürsünüz.
Amazon, bu isteğin bir tarayıcıdan gelmediğini anlar ve isteği engeller. Bu uygulama birçok web sitesinde yaygındır. Amazon isteklerinizi engelleyebilir ve 500 ile başlayan, hatta bazen 400 ile başlayan bir hata kodu döndürebilir.
Basit bir çözüm, isteğinize tarayıcı tarafından gönderilenleri taklit eden başlıklar eklemektir.
Bazen yalnızca user-agent göndermek yeterlidir. Diğer zamanlarda accept-language başlığı gibi ek başlıklar göndermeniz gerekebilir.
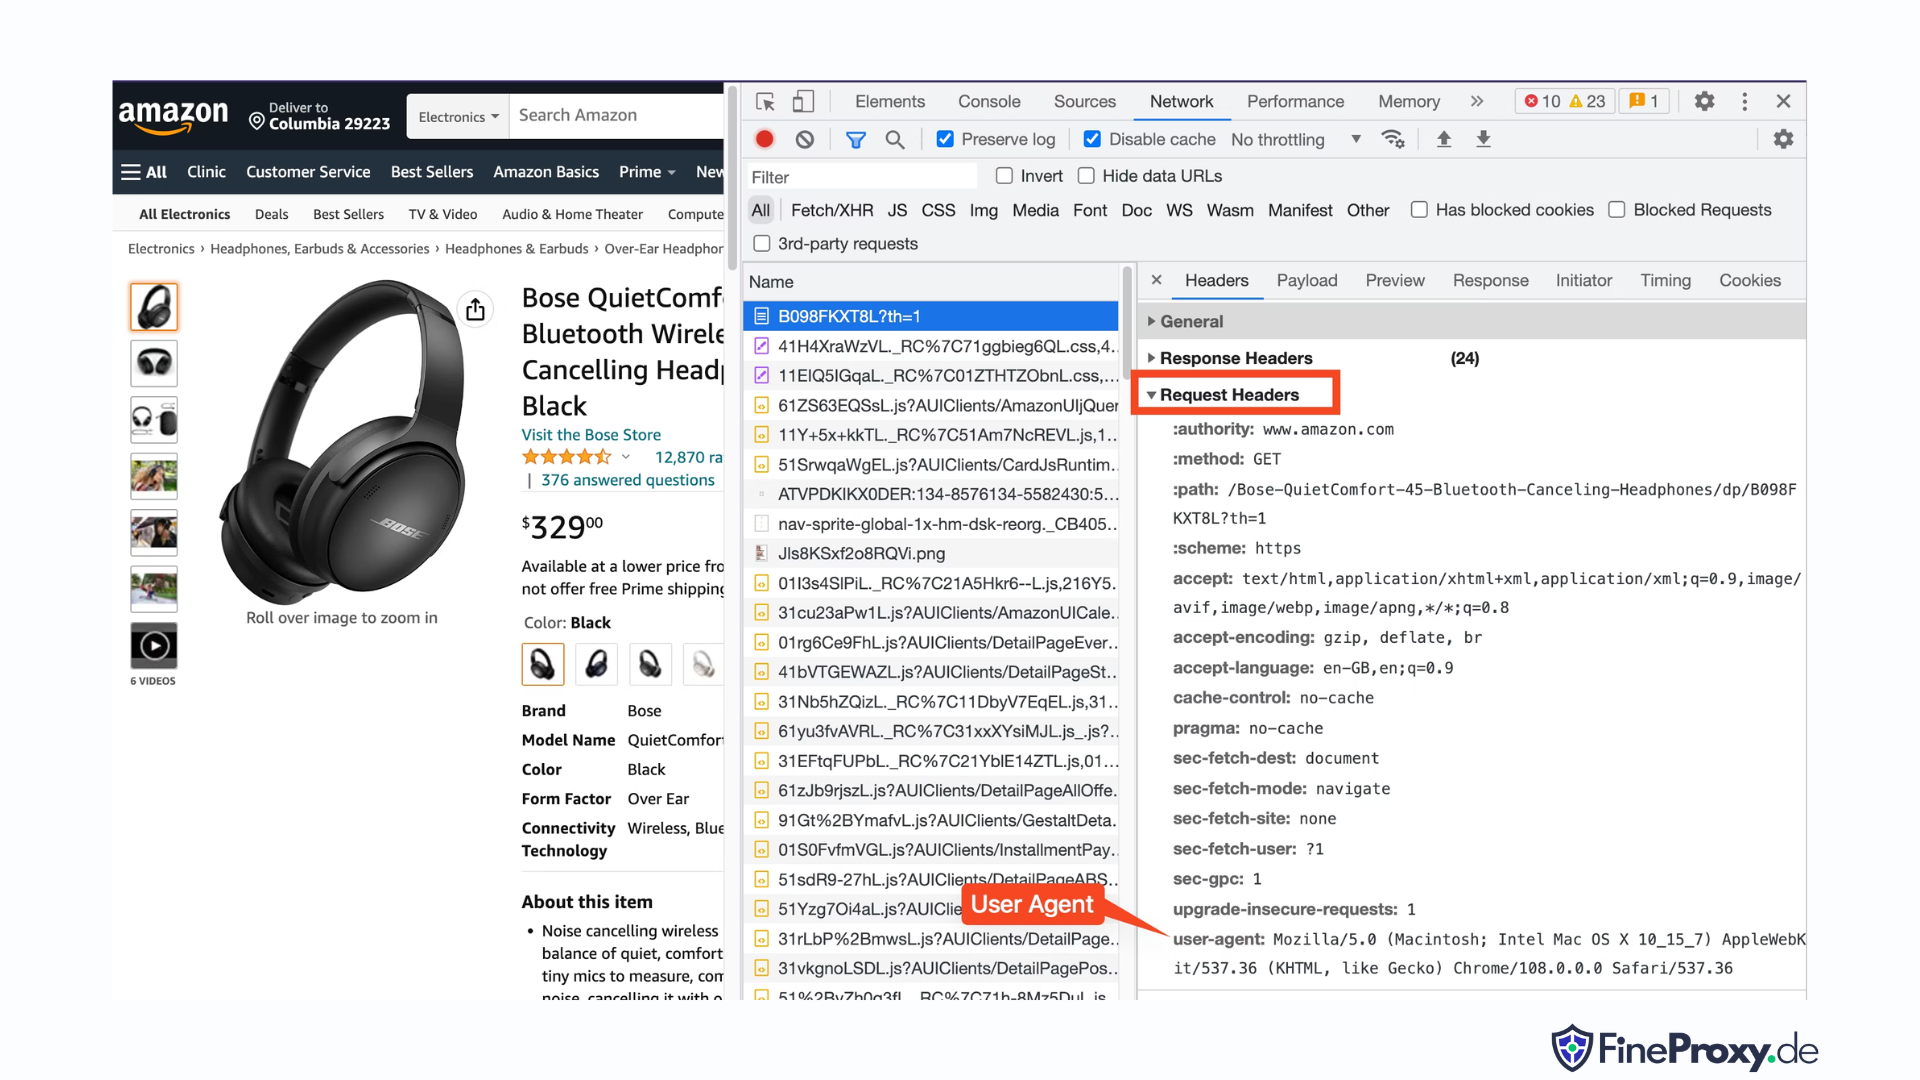
Tarayıcınızın gönderdiği user-agent değerini bulmak için F12 tuşuna basın, Network sekmesini açın ve sayfayı yeniden yükleyin. İlk isteği seçin ve Request Headers bölümünü inceleyin.
Bu user-agent değerini kopyalayın ve user-agent ile accept-language başlıklarını içeren bu örnekteki gibi başlıklar için bir sözlük oluşturun:
custom_headers = { ' user-agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/108.0.0.0 Safari/537.36', 'accept-language': 'en-GB,en;q=0.9', }Ardından bu sözlüğü get metoduna isteğe bağlı bir parametre olarak gönderebilirsiniz:
response = requests.get(url, headers=custom_headersAmazon Ürün Bilgilerini Kazıma
Amazon ürünlerini web kazıma sürecinde genellikle iki tür sayfayla karşılaşırsınız: kategori sayfası ve ürün ayrıntıları sayfası.
Örneğin, https://www.amazon.com/b?node=12097479011 adresini ziyaret edin veya Amazon'da Over-Ear Headphones araması yapın. Arama sonuçlarının görüntülendiği sayfa kategori sayfası olarak bilinir.
Kategori sayfasında ürün başlığı, ürün görseli, ürün puanı, ürün fiyatı ve en önemlisi ürün URL'leri yer alır. Ürün açıklamaları gibi daha fazla bilgiye erişmek için ürün ayrıntıları sayfasını ziyaret etmeniz gerekir.
Ürün ayrıntıları sayfasının yapısını inceleyelim.
https://www.amazon.com/Bose-QuietComfort-45-Bluetooth-Canceling-Headphones/dp/B098FKXT8L gibi bir ürün URL'sini Chrome veya başka bir modern tarayıcıda açın. Ürün başlığına sağ tıklayın ve İncele'yi seçin. Ürün başlığının HTML işaretlemesi vurgulanır.
id niteliği “productTitle” olarak ayarlanmış bir span etiketi olduğunu fark edeceksiniz.
Benzer şekilde, fiyata sağ tıklayın ve fiyatın HTML işaretlemesini görüntülemek için İncele'yi seçin.
Fiyatın dolar kısmı, sınıfı “a-price-whole” olan bir span etiketinde; sent kısmı ise sınıfı “a-price-fraction” olan başka bir span etiketinde yer alır.
Puanı, görseli ve açıklamayı da aynı şekilde bulabilirsiniz.
Bu bilgileri topladıktan sonra mevcut koda aşağıdaki satırları ekleyin:
response = requests.get(url, headers=custom_headers) soup = BeautifulSoup(response.text, 'lxml')Beautiful Soup, find yöntemlerini kullanarak etiketleri seçmek için farklı bir yöntem sunar. Alternatif olarak CSS seçicilerini de destekler. Aynı sonucu elde etmek için iki yaklaşımdan birini kullanabilirsiniz. Bu eğitimde, öğeleri seçmek için evrensel bir yöntem olan CSS seçicilerini kullanacağız. CSS seçicileri, Amazon ürün bilgilerini ayıklamak için kullanılan neredeyse tüm web kazıma araçlarıyla uyumludur.
Artık belirli bilgileri sorgulamak için Soup nesnesini kullanmaya hazırsınız.
Ürün Adını Ayıklama
Ürün adı veya başlığı, id değeri ‘productTitle’ olan bir span öğesinde bulunur. Benzersiz id'lere sahip öğeleri seçmek kolaydır.
Aşağıdaki kodu örnek olarak ele alalım:
title_element = soup.select_one('#productTitle')CSS seçicisini select_one yöntemine geçiririz; bu yöntem bir öğe örneği döndürür.
Metinden bilgi ayıklamak için text niteliğini kullanın.
title = title_element.textYazdırıldığında birkaç boşluk olduğunu fark edebilirsiniz. Bunu gidermek için aşağıdaki gibi bir .strip() işlev çağrısı ekleyin:
title = title_element.text.strip()Ürün Puanlarını Ayıklama
Amazon ürün puanlarını elde etmek için biraz daha çaba gerekir.
Öncelikle puan için bir seçici belirleyin:
#acrPopoverArdından puanı içeren öğeyi seçmek için aşağıdaki ifadeyi kullanın:
rating_element = soup.select_one('#acrPopover')Gerçek puan değerinin title niteliğinde bulunduğunu unutmayın:
rating_text = rating_element.attrs.get('title') print(rating_text) # prints '4.6 out of 5 stars'Son olarak, sayısal puanı elde etmek için replace yöntemini kullanın:
rating = rating_text.replace('out of 5 stars', '')Ürün Fiyatını Ayıklama
Ürün fiyatı iki yerde bulunabilir — ürün başlığının altında ve Buy Now kutusunda.
Amazon ürün fiyatlarını kazımak için bu etiketlerden herhangi birini kullanabilirsiniz.
Fiyat için bir CSS seçicisi oluşturun:
#price_inside_buyboxBu CSS seçicisini BeautifulSoup'un select_one yöntemine şu şekilde geçirin:
price_element = soup.select_one('#price_inside_buybox')Artık fiyatı yazdırabilirsiniz:
print(price_element.text)Görseli Ayıklama
Varsayılan görseli kazımak için #landingImage CSS seçicisini kullanın. Bu bilgilerle, src niteliğinden görsel URL'sini almak için aşağıdaki kod satırlarını yazabilirsiniz:
image_element = soup.select_one('#landingImage') image = image_element.attrs.get('src')Ürün Açıklamasını Ayıklama
Amazon ürün verilerini ayıklamanın sonraki adımı ürün açıklamasını almaktır.
İşlem aynı şekilde devam eder — bir CSS seçicisi oluşturun ve select_one yöntemini kullanın.
Açıklama için CSS seçicisi şöyledir:
#productDescriptionBu sayede öğeyi aşağıdaki gibi ayıklayabiliriz:
description_element = soup.select_one('#productDescription') print(description_element.text)Ürün Listeleme Sayfasını İşleme
Ürün bilgilerini kazımayı inceledik, ancak ürün verilerine erişmek için ürün listeleme veya kategori sayfalarından başlamanız gerekir.
Örneğin, https://www.amazon.com/b?node=12097479011 kulak üstü kulaklıkların kategori sayfasıdır.
Bu sayfayı incelerseniz tüm ürünlerin benzersiz [data-asin] niteliğine sahip bir div içinde bulunduğunu görürsünüz. Bu div'in içinde tüm ürün bağlantıları bir h2 etiketindedir.
Bu bilgilerle CSS seçicisi şöyledir:
[data-asin] h2 aBu seçicinin href niteliğini okuyabilir ve bir döngü çalıştırabilirsiniz. Ancak bağlantıların göreli olacağını unutmayın. Bu bağlantıları ayrıştırmak için urljoin yöntemini kullanmanız gerekir.
from urllib.parse import urljoin ... def parse_listing(listing_url): … link_elements = soup_search.select("[data-asin] h2 a") page_data = [] for link in link_elements: full_url = urljoin(search_url, link.attrs.get("href")) product_info = get_product_info(full_url) page_data.append(product_info)Sayfalandırmayı İşleme
Sonraki sayfanın bağlantısı, metni “Next” olan bir bağlantı etiketindedir. Bu bağlantıyı CSS'nin contains operatörünü kullanarak aşağıdaki gibi arayabilirsiniz:
next_page_el = soup.select_one('a:contains("Next")') if next_page_el: next_page_url = next_page_el.attrs.get('href') next_page_url = urljoin(listing_url, next_page_url)Amazon Verilerini Dışa Aktarma
Kazınan veriler bilerek sözlük olarak döndürülür. Kazınan tüm ürünleri içeren bir liste oluşturabilirsiniz.
def parse_listing(listing_url): ... page_data = [] for link in link_elements: ... product_info = get_product_info(full_url) page_data.append(product_info)Daha sonra bu page_data'yı kullanarak bir Pandas DataFrame nesnesi oluşturabilirsiniz:
df = pd.DataFrame(page_data) df.to_csv('headphones.csv', index = False)Amazon'da Birden Fazla Sayfa Nasıl Kazınır
Amazon'da birden fazla sayfayı kazımak, analiz etmek için daha geniş bir veri kümesi sağlayarak web kazıma projenizin etkinliğini artırabilir. Birden fazla sayfayı hedeflerken, içeriğin birkaç sayfaya bölünmesi işlemi olan sayfalandırmayı göz önünde bulundurmanız gerekir.
Amazon'da birden fazla sayfayı kazırken aklınızda bulundurmanız gereken 6 önemli nokta şunlardır:
- Sayfalandırma düzenini belirleyin: Öncelikle Amazon'un içeriğini nasıl sayfalandırdığını anlamak için kategori veya arama sonuçları sayfalarının URL yapısını inceleyin. Bu bir sorgu parametresi (ör. “?page=2”) ya da URL'nin içine yerleştirilmiş benzersiz bir tanımlayıcı olabilir.
- “Sonraki” sayfanın bağlantısını çıkarın: Sonraki sayfaya giden bağlantıyı içeren öğeyi (genellikle bir bağlantı etiketi) bulun. Bu öğenin href niteliğini, yani sonraki sayfanın URL'sini çıkarmak için uygun CSS seçicisini veya Beautiful Soup yöntemini kullanın.
- Göreli URL'leri mutlak URL'lere dönüştürün: Çıkarılan URL'ler göreli olabileceğinden, bunları mutlak URL'lere dönüştürmek için
urllib.parsekitaplığındakiurljoinişlevini kullanın. - Bir döngü oluşturun: Her sayfadan istediğiniz verileri kazıyarak sayfalar arasında ilerleyen bir döngü uygulayın. Geçerli sayfada “Sonraki” sayfa bağlantısının bulunup bulunmadığını kontrol ederek belirleyebileceğiniz üzere, döngü başka sayfa kalmayana kadar devam etmelidir.
- İstekler arasında gecikme ekleyin: Amazon'un sunucusunu aşırı yüklememek veya bot önleme önlemlerini tetiklememek için
timekitaplığındakitime.sleep()işlevini kullanarak istekler arasına gecikmeler ekleyin. İnsanların gezinme davranışını taklit etmek için gecikme süresini ayarlayın. - CAPTCHA'ları ve engellemeleri ele alın: Birden fazla sayfayı kazarken CAPTCHA'larla veya IP engellemeleriyle karşılaşırsanız IP adreslerini dönüşümlü kullanmak için proxy'lerden ya da bu zorlukları otomatik olarak aşabilen özel kazıma araçlarından ve hizmetlerinden yararlanmayı düşünün.
Aşağıda, Amazon'un web sitesindeki birden fazla sayfadan veri çıkarma sürecinde size rehberlik eden kapsamlı bir YouTube video eğitimi bulabilirsiniz. Eğitim, çok sayıda Amazon sayfasından değerli bilgileri verimli ve etkili bir şekilde toplamanızı sağlayacak tekniklere odaklanarak web kazıma dünyasını derinlemesine ele alıyor.
Eğitim boyunca sunucu; Python, BeautifulSoup ve requests gibi temel araç ve kitaplıkların kullanımını gösterirken Amazon'un bot önleme mekanizmaları tarafından engellenmekten veya tespit edilmekten kaçınmaya yönelik en iyi uygulamaları da vurguluyor. Video; sayfalandırmayı ele alma, istek hız sınırlarını yönetme ve insan benzeri gezinme davranışını taklit etme gibi temel konuları kapsıyor.
Videoda sunulan adım adım talimatlara ek olarak eğitim, web kazıma deneyiminizi iyileştirmek için yararlı ipuçları ve püf noktaları da paylaşıyor. Bunlar arasında IP kısıtlamalarını aşmak için proxy kullanmak, User-Agent ve istek başlıklarını rastgeleleştirmek ve sorunsuz, kesintisiz bir kazıma süreci sağlamak için uygun hata yönetimini uygulamak yer alıyor.
Amazon'dan Veri Kazıma: SSS
Popüler bir e-ticaret platformu olan Amazon'dan veri çıkarma söz konusu olduğunda dikkat edilmesi gereken bazı noktalar vardır. Amazon'dan veri kazımayla ilgili sık sorulan sorulara göz atalım.
1. Amazon'dan Veri Kazımak Yasal mı?
İnternette herkese açık verileri kazımak yasaldır ve buna Amazon'dan veri kazımak da dahildir. Ürün bilgileri, açıklamalar, puanlar ve fiyatlar gibi bilgileri yasal olarak kazıyabilirsiniz. Ancak ürün yorumlarını kazırken kişisel verilere ve telif hakkı korumasına dikkat etmelisiniz. Örneğin, yorumu yapan kişinin adı ve avatarı kişisel veri sayılabilirken yorum metni telif hakkıyla korunuyor olabilir. Bu tür verileri kazarken her zaman dikkatli olun ve hukuki danışmanlık alın.
2. Amazon Veri Kazımaya İzin Veriyor mu?
Herkese açık verileri kazımak yasal olsa da Amazon bazen veri kazımayı önlemek için önlemler alır. Bu önlemler arasında istekleri hız sınırlamasına tabi tutmak, IP adreslerini yasaklamak ve veri kazıma botlarını tespit etmek için tarayıcı parmak izi kullanmak yer alır. Amazon genellikle web kazımayı 200 OK başarı durum koduyla engeller ve bir CAPTCHA'yı geçmenizi ister ya da ücretli bir API için satış ekibiyle iletişime geçmenizi isteyen bir HTTP Error 503 Service Unavailable mesajı gösterir.
Bu önlemleri aşmanın yolları vardır, ancak etik web kazıma, en başta bunların tetiklenmesini önlemeye yardımcı olabilir. Etik web kazıma; istek sıklığını sınırlamayı, uygun user agent'lar kullanmayı ve web sitesinin performansını etkileyebilecek aşırı veri kazımadan kaçınmayı içerir. Etik biçimde veri kazıyarak Amazon'dan yararlı veriler çıkarmaya devam ederken yasaklanma veya hukuki sonuçlarla karşılaşma riskini azaltabilirsiniz.
3. Amazon Verilerini Kazımak Etik mi?
Etik veri kazıma, hedef web sitesine saygı göstermeyi gerektirir. Amazon web sitesini çok fazla istekle aşırı yüklemeniz pek olası olmasa da yine de etik veri kazıma yönergelerine uymalısınız. Etik veri kazıma, hukuki sorunlarla karşılaşma veya veri kazımayı önleyici tedbirlerle uğraşma riskini en aza indirebilir.
4. Amazon'dan Veri Kazarken Yasaklanmaktan Nasıl Kaçınabilirim?
Amazon'dan veri kazarken yasaklanmaktan kaçınmak için istek hızınızı sınırlamalı, yoğun saatlerde veri kazımaktan kaçınmalı, akıllı proxy rotasyonu kullanmalı ve tespit edilmemek için uygun user agent'lar ve başlıklar kullanmalısınız. Ayrıca yalnızca ihtiyacınız olan verileri çıkarın ve üçüncü taraf veri kazıma araçları veya veri kazıma kütüphaneleri kullanın.
5. Amazon'dan Veri Kazımanın Riskleri Nelerdir?
Amazon'dan veri kazımak, hukuki işlem ve hesabın askıya alınması gibi olası riskler taşır. Amazon, IP adreslerini yasaklama, hız sınırlaması ve tarayıcı parmak izi alma gibi veri kazımayı tespit edip önlemeye yönelik bot karşıtı tedbirler kullanır. Ancak etik biçimde veri kazıyarak bu riskleri azaltabilirsiniz.
Sonuç
Amazon web kazımanın büyüleyici labirentinden çıkarken, bu heyecan verici yolculukta edindiğimiz paha biçilmez bilgi ve becerileri takdir etmek için biraz durmanın zamanı geldi. Güvenilir rehberiniz ProxyCompass sayesinde, perakende devinden paha biçilmez veriler çıkarmanın dolambaçlı yollarında başarıyla ilerlediniz. Yeni kazandığınız uzmanlığı ustalıkla kullanarak yolunuza devam ederken dijital ormanın sürekli değiştiğini unutmayın.
Merakınızı koruyun, web kazıma palanızı keskinleştirmeye devam edin ve veri çıkarmanın sürekli değişen dünyasını fethetmeyi sürdürün. Bir sonraki cesur keşif gezimizde yeniden buluşana dek, korkusuz kâşif, veri odaklı görevlerin verimli ve ödüllendirici olsun!