Immaginati come un esploratore avventuroso, che si tuffa a capofitto nel vasto e misterioso regno di Amazon: non la foresta pluviale, ma il colosso della vendita al dettaglio online. A ogni clic scopri tesori inestimabili, addentrandoti sempre più in un territorio inesplorato di dati.
In questa emozionante spedizione, ti presentiamo una guida passo passo per orientarti nella fitta giungla digitale dello scraping web di Amazon. Preparati a intraprendere un viaggio senza eguali, munito di consigli e trucchi degli esperti per estrarre informazioni preziose con una precisione senza pari.
Indice
- Quali dati estrarre da Amazon
- Alcuni requisiti di base
- Prepararsi allo scraping
- Estrarre informazioni sui prodotti da Amazon
- Come fare scraping di più pagine su Amazon
- Scraping di Amazon: domande frequenti
- Conclusione
Quindi, fatti coraggio, allaccia i tuoi stivali virtuali e diamo inizio insieme alla nostra avventura all'insegna dei dati!
Quali dati estrarre da Amazon
Ci sono numerosi punti dati associati a un prodotto Amazon, ma gli elementi chiave su cui concentrarsi durante lo scraping includono:
- Titolo del prodotto
- Prezzo
- Risparmio (se applicabile)
- Riepilogo dell'articolo
- Elenco delle caratteristiche associate (se disponibile)
- Punteggio delle recensioni
- Immagini del prodotto
Sebbene questi siano gli aspetti principali da considerare quando si esegue lo scraping di un articolo Amazon, è importante notare che le informazioni estratte possono variare a seconda degli obiettivi specifici.
Alcuni requisiti di base
Per preparare una zuppa, servono gli ingredienti giusti. Allo stesso modo, il nostro nuovo scraper web richiede componenti specifici.
- Python — La sua facilità d'uso e la vasta raccolta di librerie lo rendono la scelta migliore per lo scraping web. Se non è già installato, consulta questa guida.
- BeautifulSoup — Questa è una delle numerose librerie di scraping web disponibili per Python. La sua semplicità e il suo utilizzo intuitivo la rendono una scelta popolare per lo scraping web. Dopo aver installato Python, puoi installare Beautiful Soup eseguendo: pip install bs4
- Conoscenze di base dei tag HTML — Consulta questo tutorial per acquisire le conoscenze necessarie sui tag HTML.
- Browser web — Poiché è necessario filtrare molte informazioni irrilevanti da un sito web, servono ID e tag specifici a tale scopo. Un browser web come Google Chrome o Mozilla Firefox è utile per individuarli.
Preparazione allo scraping
Per iniziare, assicurati di avere Python installato. Se non hai Python 3.8 o versioni successive, visita python.org per scaricare e installare la versione più recente.
Quindi, crea una directory in cui archiviare i file di codice per lo scraping web di Amazon. In genere è consigliabile configurare un ambiente virtuale per il progetto.
Usa i seguenti comandi per creare e attivare un ambiente virtuale su macOS e Linux:
$ python3 -m venv .env $ source .env/bin/activatePer gli utenti Windows, i comandi saranno leggermente diversi:
d:amazon>python -m venv .env d:amazon>.envscriptsactivateOra è il momento di installare i pacchetti Python necessari.
Ti serviranno pacchetti per due attività principali: ottenere l'HTML e analizzarlo per estrarre i dati pertinenti.
La libreria Requests è una libreria Python di terze parti molto diffusa per effettuare richieste HTTP. Offre un'interfaccia semplice e intuitiva per inviare richieste HTTP ai server web e ricevere risposte. È probabilmente la libreria più conosciuta per lo scraping web.
Tuttavia, la libreria Requests ha una limitazione: restituisce la risposta HTML come stringa, che può essere difficile da esaminare per individuare elementi specifici, come i prezzi delle inserzioni, durante la scrittura del codice per lo scraping web.
È qui che entra in gioco Beautiful Soup. Beautiful Soup è una libreria Python progettata per lo scraping web, che estrae dati da file HTML e XML. Ti permette di recuperare informazioni da una pagina web cercando tag, attributi o testo specifico.
Per installare entrambe le librerie, usa il seguente comando:
$ python3 -m pip install requests beautifulsoup4Gli utenti Windows devono sostituire ‘python3’ con ‘python’, lasciando invariato il resto del comando:
d:amazon>python -m pip install requests beautifulsoup4Nota che stiamo installando la versione 4 della libreria Beautiful Soup.
Ora testiamo la libreria Requests per lo scraping. Crea un nuovo file chiamato amazon.py e inserisci il seguente codice:
import requests url = ' https://www.amazon.com/Bose-QuietComfort-45-Bluetooth-Canceling-Headphones/dp/B098FKXT8L' response = requests.get(url) print(response.text)Salva il file ed eseguilo dal terminale.
$ python3 amazon.pyNella maggior parte dei casi, non riuscirai a visualizzare l'HTML desiderato. Amazon bloccherà la richiesta e riceverai la seguente risposta:
To discuss automated access to Amazon data please contact [email protected].Se stampi response.status_code, vedrai che ricevi un errore 503 invece di un codice di successo 200.
Amazon sa che questa richiesta non proviene da un browser e la blocca. Questa pratica è comune a molti siti web. Amazon potrebbe bloccare le tue richieste e restituire un codice di errore che inizia con 500 o, talvolta, persino con 400.
Una soluzione semplice consiste nell'inviare con la richiesta intestazioni che imitino quelle inviate da un browser.
A volte è sufficiente inviare solo lo user-agent. Altre volte potrebbe essere necessario inviare intestazioni aggiuntive, come l'intestazione accept-language.
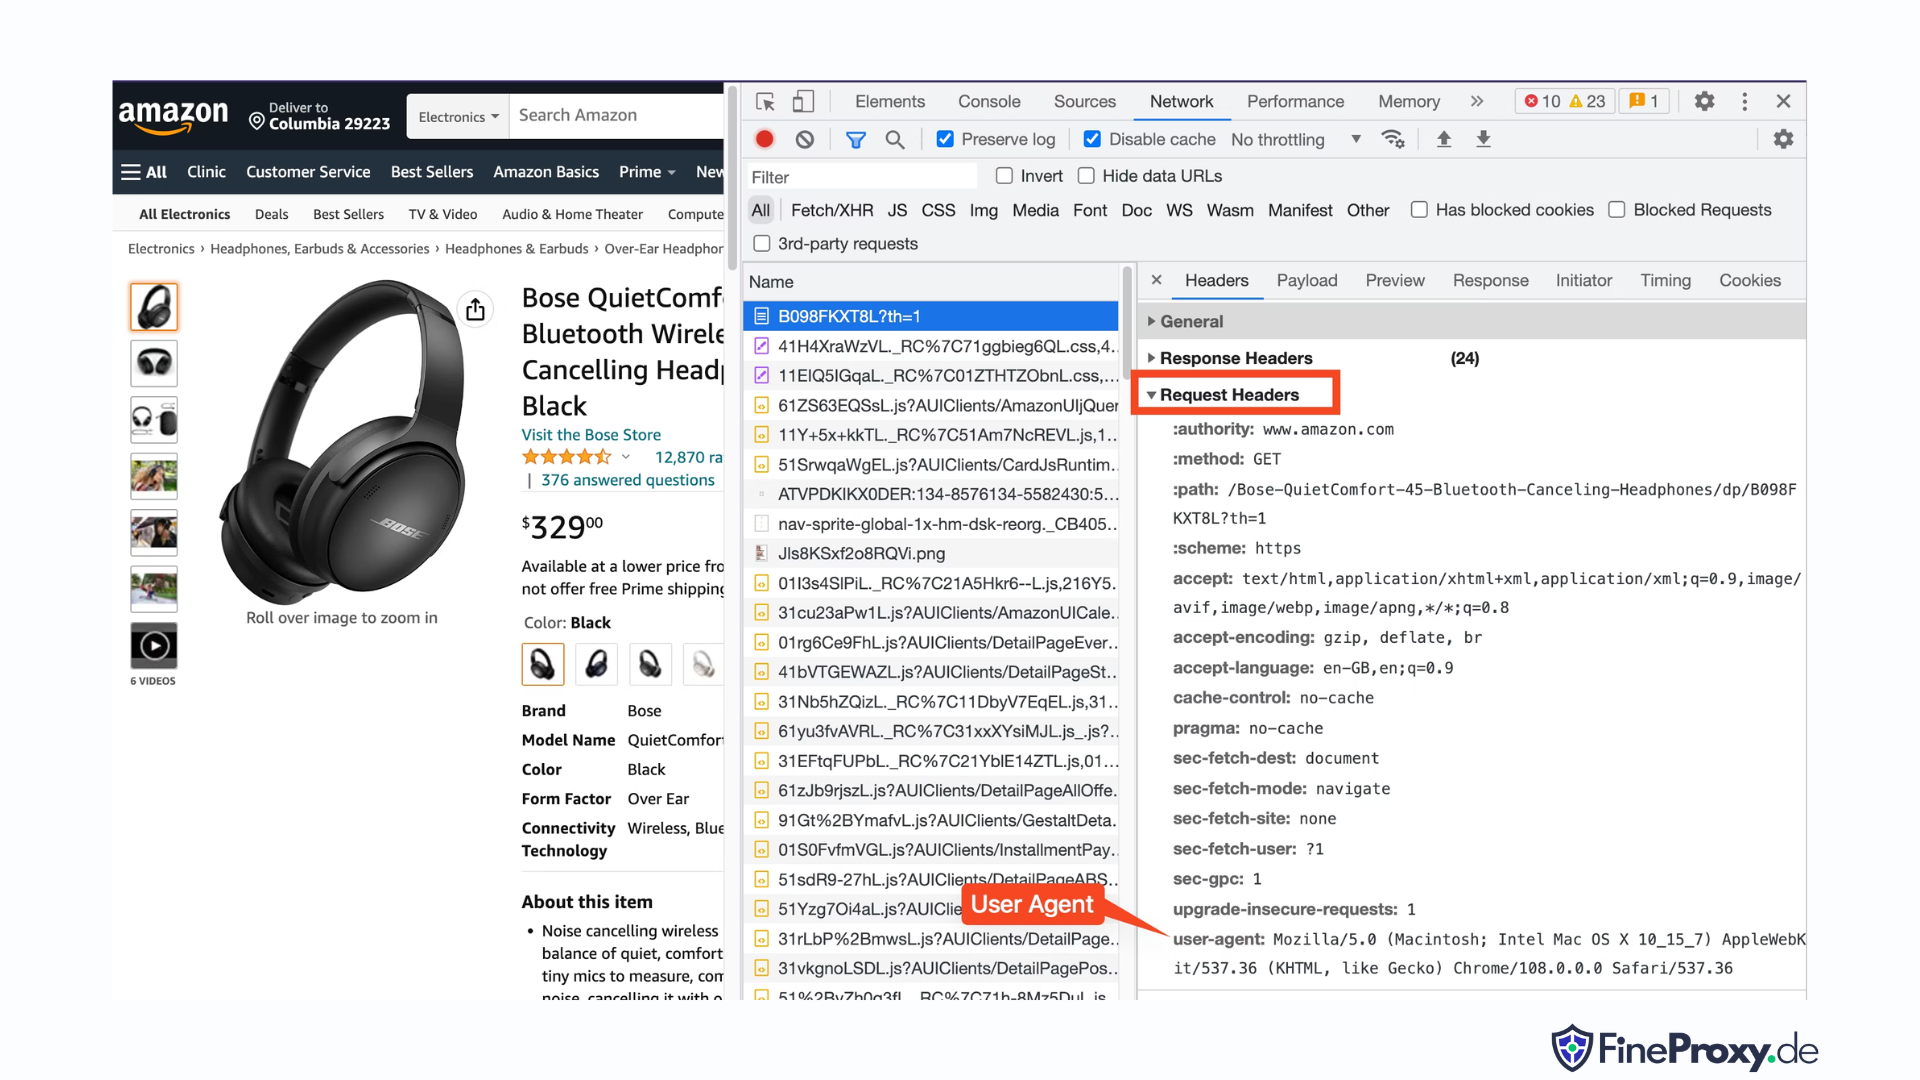
Per trovare lo user-agent inviato dal browser, premi F12, apri la scheda Network e ricarica la pagina. Seleziona la prima richiesta ed esamina le intestazioni Request Headers.
Copia questo user-agent e crea un dizionario per le intestazioni, come in questo esempio con le intestazioni user-agent e accept-language:
custom_headers = { ' user-agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/108.0.0.0 Safari/537.36', 'accept-language': 'en-GB,en;q=0.9', }Puoi quindi inviare questo dizionario come parametro facoltativo nel metodo get:
response = requests.get(url, headers=custom_headersEstrazione dei dati dei prodotti Amazon
Durante il processo di scraping dei prodotti Amazon, in genere si interagisce con due tipi di pagine: la pagina di categoria e la pagina dei dettagli del prodotto.
Ad esempio, visita https://www.amazon.com/b?node=12097479011 oppure cerca Cuffie over-ear su Amazon. La pagina che mostra i risultati di ricerca è nota come pagina di categoria.
La pagina di categoria mostra il titolo del prodotto, l’immagine del prodotto, la valutazione del prodotto, il prezzo del prodotto e, soprattutto, la pagina degli URL dei prodotti. Per accedere a ulteriori informazioni, come le descrizioni dei prodotti, devi visitare la pagina dei dettagli del prodotto.
Analizziamo la struttura della pagina dei dettagli del prodotto.
Apri un URL di un prodotto, come https://www.amazon.com/Bose-QuietComfort-45-Bluetooth-Canceling-Headphones/dp/B098FKXT8L, usando Chrome o un altro browser moderno. Fai clic con il tasto destro sul titolo del prodotto e scegli Ispeziona. Verrà evidenziato il markup HTML del titolo del prodotto.
Noterai che si tratta di un tag span con l’attributo id impostato su “productTitle”.
Allo stesso modo, fai clic con il tasto destro sul prezzo e seleziona Ispeziona per visualizzare il markup HTML del prezzo.
La parte in dollari del prezzo si trova in un tag span con la classe “a-price-whole”, mentre la parte dei centesimi si trova in un altro tag span con la classe “a-price-fraction”.
Puoi individuare anche la valutazione, l’immagine e la descrizione allo stesso modo.
Dopo aver raccolto queste informazioni, aggiungi le seguenti righe al codice esistente:
response = requests.get(url, headers=custom_headers) soup = BeautifulSoup(response.text, 'lxml')Beautiful Soup offre un metodo specifico per selezionare i tag tramite i metodi find. Supporta anche i selettori CSS come alternativa. Puoi usare entrambi gli approcci per ottenere lo stesso risultato. In questo tutorial utilizzeremo i selettori CSS, un metodo universale per selezionare gli elementi. I selettori CSS sono compatibili con quasi tutti gli strumenti di web scraping per estrarre i dati dei prodotti Amazon.
Ora sei pronto a usare l’oggetto Soup per cercare informazioni specifiche.
Estrazione del nome del prodotto
Il nome o titolo del prodotto si trova in un elemento span con id ‘productTitle’. Selezionare gli elementi tramite ID univoci è semplice.
Considera il codice seguente come esempio:
title_element = soup.select_one('#productTitle')Passiamo il selettore CSS al metodo select_one, che restituisce un’istanza dell’elemento.
Per estrarre informazioni dal testo, usa l’attributo text.
title = title_element.textQuando lo stampi, potresti notare alcuni spazi vuoti. Per risolvere il problema, aggiungi una chiamata alla funzione .strip() come segue:
title = title_element.text.strip()Estrazione delle valutazioni dei prodotti
Ottenere le valutazioni dei prodotti Amazon richiede qualche passaggio in più.
Per prima cosa, definisci un selettore per la valutazione:
#acrPopoverQuindi, usa la seguente istruzione per selezionare l’elemento che contiene la valutazione:
rating_element = soup.select_one('#acrPopover')Nota che il valore effettivo della valutazione si trova nell’attributo title:
rating_text = rating_element.attrs.get('title') print(rating_text) # prints '4.6 out of 5 stars'Infine, usa il metodo replace per ottenere la valutazione numerica:
rating = rating_text.replace('out of 5 stars', '')Estrazione del prezzo del prodotto
Il prezzo del prodotto si trova in due posizioni: sotto il titolo del prodotto e all’interno del riquadro Acquista ora.
È possibile utilizzare uno qualsiasi di questi tag per estrarre i prezzi dei prodotti Amazon.
Crea un selettore CSS per il prezzo:
#price_inside_buyboxPassa questo selettore CSS al metodo select_one di BeautifulSoup, come segue:
price_element = soup.select_one('#price_inside_buybox')Ora puoi stampare il prezzo:
print(price_element.text)Estrazione dell’immagine
Per estrarre l’immagine predefinita, usa il selettore CSS #landingImage. Con queste informazioni, puoi scrivere le seguenti righe di codice per ottenere l’URL dell’immagine dall’attributo src:
image_element = soup.select_one('#landingImage') image = image_element.attrs.get('src')Estrazione della descrizione del prodotto
Il passaggio successivo per estrarre i dati dei prodotti Amazon consiste nell’ottenere la descrizione del prodotto.
Il procedimento è lo stesso: crea un selettore CSS e usa il metodo select_one.
Il selettore CSS per la descrizione è:
#productDescriptionQuesto ci consente di estrarre l’elemento come segue:
description_element = soup.select_one('#productDescription') print(description_element.text)Gestione degli elenchi di prodotti
Abbiamo visto come estrarre le informazioni sui prodotti, ma per accedere ai dati dei prodotti dovrai iniziare dalle pagine degli elenchi di prodotti o di categoria.
Ad esempio, https://www.amazon.com/b?node=12097479011 è la pagina di categoria delle cuffie over-ear.
Esaminando questa pagina, noterai che tutti i prodotti sono contenuti in un div con un attributo univoco [data-asin]. All’interno di questo div, tutti i link dei prodotti si trovano in un tag h2.
Con queste informazioni, il selettore CSS è:
[data-asin] h2 aPuoi leggere l’attributo href di questo selettore ed eseguire un ciclo. Tuttavia, ricorda che i link saranno relativi. Dovrai usare il metodo urljoin per analizzare questi link.
from urllib.parse import urljoin ... def parse_listing(listing_url): … link_elements = soup_search.select("[data-asin] h2 a") page_data = [] for link in link_elements: full_url = urljoin(search_url, link.attrs.get("href")) product_info = get_product_info(full_url) page_data.append(product_info)Gestione della paginazione
Il link alla pagina successiva è contenuto in un link con il testo “Next”. Puoi cercare questo link usando l’operatore contains di CSS, come segue:
next_page_el = soup.select_one('a:contains("Next")') if next_page_el: next_page_url = next_page_el.attrs.get('href') next_page_url = urljoin(listing_url, next_page_url)Esportazione dei dati di Amazon
I dati estratti vengono restituiti intenzionalmente sotto forma di dizionario. Puoi creare un elenco contenente tutti i prodotti estratti.
def parse_listing(listing_url): ... page_data = [] for link in link_elements: ... product_info = get_product_info(full_url) page_data.append(product_info)Puoi quindi usare questo page_data per creare un oggetto Pandas DataFrame:
df = pd.DataFrame(page_data) df.to_csv('headphones.csv', index = False)Come estrarre dati da più pagine su Amazon
Estrarre dati da più pagine su Amazon può migliorare l’efficacia del tuo progetto di web scraping, fornendoti un insieme di dati più ampio da analizzare. Quando ti rivolgi a più pagine, dovrai considerare la paginazione, ovvero il processo di suddivisione dei contenuti su più pagine.
Ecco 6 punti chiave da tenere a mente quando estrai dati da più pagine su Amazon:
- Individua il modello di paginazione: Per prima cosa, analizza la struttura degli URL delle pagine delle categorie o dei risultati di ricerca per capire come Amazon suddivide i contenuti in pagine. Potrebbe trattarsi di un parametro di query (ad es. “?page=2”) o di un identificatore univoco incorporato nell’URL.
- Estrai il link alla pagina “Successiva”: Individua l’elemento (di solito un tag anchor) che contiene il link alla pagina successiva. Usa il selettore CSS appropriato o il metodo di Beautiful Soup per estrarre l’attributo href di questo elemento, che corrisponde all’URL della pagina successiva.
- Converti gli URL relativi in URL assoluti: Poiché gli URL estratti potrebbero essere relativi, usa la funzione
urljoindella libreriaurllib.parseper convertirli in URL assoluti. - Crea un ciclo: Implementa un ciclo che scorra le pagine, estraendo da ciascuna i dati desiderati. Il ciclo dovrebbe continuare finché non ci sono più pagine, condizione che puoi determinare verificando se nella pagina corrente è presente il link alla pagina “Successiva”.
- Aggiungi pause tra le richieste: Per evitare di sovraccaricare il server di Amazon o di attivare le misure anti-bot, inserisci delle pause tra le richieste usando la funzione
time.sleep()della libreriatime. Regola la durata della pausa per simulare il comportamento di navigazione di una persona. - Gestione di CAPTCHA e blocchi: Se durante l’estrazione di dati da più pagine incontri CAPTCHA o blocchi IP, valuta l’uso di proxy per ruotare gli indirizzi IP oppure di strumenti e servizi di scraping dedicati, in grado di gestire automaticamente queste difficoltà.
Qui sotto trovi un video tutorial completo su YouTube che ti guida attraverso il processo di estrazione dei dati da più pagine del sito web di Amazon. Il tutorial approfondisce il mondo del web scraping e si concentra sulle tecniche che ti consentiranno di raccogliere in modo efficiente ed efficace informazioni preziose da numerose pagine di Amazon.
Nel corso del tutorial, il relatore mostra come utilizzare strumenti e librerie essenziali, come Python, BeautifulSoup e requests, illustrando al contempo le best practice per evitare di essere bloccati o rilevati dai meccanismi anti-bot di Amazon. Il video tratta argomenti fondamentali come la gestione della paginazione, la gestione dei limiti di frequenza e la simulazione di un comportamento di navigazione simile a quello umano.
Oltre alle istruzioni dettagliate fornite nel video, il tutorial condivide anche suggerimenti e trucchi utili per ottimizzare la tua esperienza di web scraping. Tra questi, l’uso di proxy per aggirare le restrizioni IP, la randomizzazione dello User-Agent e delle intestazioni delle richieste e l’implementazione di una corretta gestione degli errori per garantire un processo di scraping fluido e ininterrotto.
Scraping di Amazon: domande frequenti
Quando si tratta di estrarre dati da Amazon, una popolare piattaforma di e-commerce, ci sono alcune cose di cui bisogna tenere conto. Vediamo le domande frequenti relative allo scraping dei dati di Amazon.
1. È legale fare scraping su Amazon?
Fare scraping di dati disponibili pubblicamente su Internet è legale, e questo include lo scraping di Amazon. È possibile raccogliere legalmente informazioni come dettagli dei prodotti, descrizioni, valutazioni e prezzi. Tuttavia, quando si raccolgono recensioni dei prodotti, è necessario prestare attenzione ai dati personali e alla tutela del copyright. Ad esempio, il nome e l'avatar di chi ha scritto la recensione possono costituire dati personali, mentre il testo della recensione potrebbe essere protetto da copyright. Presta sempre attenzione e chiedi una consulenza legale quando raccogli dati di questo tipo.
2. Amazon consente lo scraping?
Sebbene raccogliere dati disponibili pubblicamente sia legale, Amazon a volte adotta misure per impedire lo scraping. Queste misure includono la limitazione della frequenza delle richieste, il blocco degli indirizzi IP e l'uso del browser fingerprinting per rilevare i bot di scraping. In genere, Amazon blocca il web scraping restituendo un codice di risposta 200 OK, che indica un esito positivo, e richiede di superare un CAPTCHA oppure mostra un messaggio HTTP Error 503 Service Unavailable che invita a contattare l'ufficio vendite per ottenere un'API a pagamento.
Esistono modi per aggirare queste misure, ma un web scraping etico può aiutarti a evitare di attivarle fin da subito. Il web scraping etico consiste nel limitare la frequenza delle richieste, usare user agent appropriati ed evitare uno scraping eccessivo che potrebbe compromettere le prestazioni del sito web. Facendo scraping in modo etico, puoi ridurre il rischio di essere bloccato o di incorrere in conseguenze legali, continuando comunque a estrarre dati utili da Amazon.
3. È etico fare scraping dei dati di Amazon?
Fare scraping in modo etico significa rispettare il sito web di destinazione. Anche se è improbabile che tu sovraccarichi il sito web di Amazon con troppe richieste, dovresti comunque seguire le linee guida per uno scraping etico. Uno scraping etico può ridurre al minimo il rischio di affrontare problemi legali o di dover gestire misure anti-scraping.
4. Come posso evitare di essere bloccato mentre faccio scraping su Amazon?
Per evitare di essere bloccato mentre fai scraping su Amazon, dovresti limitare la frequenza delle richieste, evitare lo scraping nelle ore di punta, usare una rotazione intelligente dei proxy e utilizzare user agent e intestazioni appropriati per evitare il rilevamento. Inoltre, estrai solo i dati di cui hai bisogno e usa strumenti di scraping di terze parti o librerie per lo scraping.
5. Quali sono i rischi dello scraping di Amazon?
Fare scraping dei dati di Amazon comporta rischi potenziali, come azioni legali e la sospensione dell'account. Amazon usa misure anti-bot per rilevare e impedire lo scraping, tra cui il blocco degli indirizzi IP, la limitazione della frequenza delle richieste e il browser fingerprinting. Tuttavia, facendo scraping in modo etico, puoi mitigare questi rischi.
Conclusione
Ora che siamo emersi dall'avvincente labirinto dello scraping web di Amazon, è il momento di fermarci un attimo ad apprezzare le preziose conoscenze e competenze acquisite durante questo entusiasmante viaggio. Con ProxyCompass come fidata guida, hai superato con successo le insidie e le svolte dell'estrazione di dati inestimabili dal colosso della vendita al dettaglio. Mentre prosegui il tuo cammino, mettendo a frutto con disinvoltura le nuove competenze acquisite, ricorda che la giungla digitale non smette mai di evolversi.
Resta curioso, continua ad affilare il tuo machete per il web scraping e prosegui alla conquista del panorama in continua evoluzione dell'estrazione dei dati. Fino alla nostra prossima audace spedizione, intrepido esploratore, possano le tue avventure basate sui dati essere fruttuose e gratificanti!