
Представьте себя отважным исследователем, который с головой погружается в обширный и загадочный мир Amazon — не тропических лесов, а гиганта онлайн-торговли. С каждым щелчком мыши вы находите бесценные сокровища, всё глубже проникая на неизведанную территорию данных.
В этом захватывающем путешествии мы предлагаем пошаговое руководство по исследованию густых цифровых джунглей веб-скрейпинга Amazon. Приготовьтесь отправиться в необыкновенное приключение, вооружившись советами и хитростями экспертов, которые помогут извлечь ценную информацию с непревзойдённой точностью.
Содержание
- Какие данные собирать с Amazon
- Основные требования
- Подготовка к скрейпингу
- Сбор информации о товарах Amazon
- Как собирать данные с нескольких страниц Amazon
- Скрейпинг Amazon: часто задаваемые вопросы
- Заключение
Итак, наберитесь смелости, наденьте виртуальные ботинки — и давайте вместе отправимся в наше приключение в мире данных!
Какие данные собирать с Amazon
С товаром на Amazon связано множество данных, но при скрейпинге в первую очередь следует сосредоточиться на следующих элементах:
- Название товара
- Цена
- Экономия (если применимо)
- Краткое описание товара
- Список характеристик (если доступен)
- Оценка отзывов
- Изображения товара
Хотя это основные параметры, которые следует учитывать при сборе данных о товаре с Amazon, важно помнить, что набор извлекаемой информации может различаться в зависимости от ваших конкретных задач.
Основные требования
Чтобы приготовить суп, нужны подходящие ингредиенты. Точно так же нашему новому веб-скрейперу потребуются определённые компоненты.
- Python — благодаря простоте использования и обширной коллекции библиотек Python является лучшим выбором для веб-скрейпинга. Если он ещё не установлен, обратитесь к этому руководству.
- BeautifulSoup — одна из множества библиотек Python для веб-скрейпинга. Простота и удобство использования сделали её популярным выбором для веб-скрейпинга. После успешной установки Python установите Beautiful Soup, выполнив команду: pip install bs4
- Базовое понимание HTML-тегов — ознакомьтесь с этим руководством, чтобы получить необходимые знания об HTML-тегах.
- Веб-браузер — поскольку нам нужно отфильтровать с сайта много нерелевантной информации, для этого потребуются определённые идентификаторы и теги. Веб-браузер, например Google Chrome или Mozilla Firefox, пригодится для поиска этих тегов.
Подготовка к парсингу
Для начала убедитесь, что у вас установлен Python. Если у вас нет Python 3.8 или более поздней версии, зайдите на сайт python.org, чтобы скачать и установить последнюю версию.
Затем создайте каталог для хранения файлов с кодом парсинга веб-страниц Amazon. Обычно рекомендуется настроить для проекта виртуальное окружение.
Используйте следующие команды, чтобы создать и активировать виртуальное окружение в macOS и Linux:
$ python3 -m venv .env $ source .env/bin/activateДля пользователей Windows команды будут немного отличаться:
d:amazon>python -m venv .env d:amazon>.envscriptsactivateТеперь нужно установить необходимые пакеты Python.
Вам понадобятся пакеты для решения двух основных задач: получения HTML-кода и его разбора для извлечения нужных данных.
Библиотека Requests — широко используемая сторонняя библиотека Python для отправки HTTP-запросов. Она предлагает простой и удобный интерфейс для отправки HTTP-запросов веб-серверам и получения ответов. Это, пожалуй, самая известная библиотека для парсинга веб-страниц.
Однако у библиотеки Requests есть ограничение: она возвращает HTML-ответ в виде строки, в которой может быть сложно найти отдельные элементы, например цены товаров, при написании кода для парсинга веб-страниц.
Здесь на помощь приходит Beautiful Soup. Beautiful Soup — это библиотека Python, предназначенная для парсинга веб-страниц и извлечения данных из файлов HTML и XML. Она позволяет получать информацию с веб-страницы, выполняя поиск по тегам, атрибутам или конкретному тексту.
Чтобы установить обе библиотеки, используйте следующую команду:
$ python3 -m pip install requests beautifulsoup4Пользователям Windows нужно заменить «python3» на «python», оставив остальную часть команды без изменений:
d:amazon>python -m pip install requests beautifulsoup4Обратите внимание, что мы устанавливаем библиотеку Beautiful Soup версии 4.
Теперь проверим библиотеку Requests для парсинга. Создайте файл с именем amazon.py и введите следующий код:
import requests url = ' https://www.amazon.com/Bose-QuietComfort-45-Bluetooth-Canceling-Headphones/dp/B098FKXT8L' response = requests.get(url) print(response.text)Сохраните файл и запустите его из терминала.
$ python3 amazon.pyВ большинстве случаев вы не сможете увидеть нужный HTML-код. Amazon заблокирует запрос, и вы получите следующий ответ:
To discuss automated access to Amazon data please contact [email protected].Если вывести response.status_code, вы увидите, что вместо кода успешного ответа 200 получаете ошибку 503.
Amazon понимает, что запрос пришёл не из браузера, и блокирует его. Такая практика распространена на многих веб-сайтах. Amazon может блокировать ваши запросы и возвращать код ошибки, начинающийся с 500, а иногда и с 400.
Простое решение — отправлять вместе с запросом заголовки, имитирующие те, которые отправляет браузер.
Иногда достаточно отправить только user-agent. В других случаях может потребоваться отправить дополнительные заголовки, например accept-language.
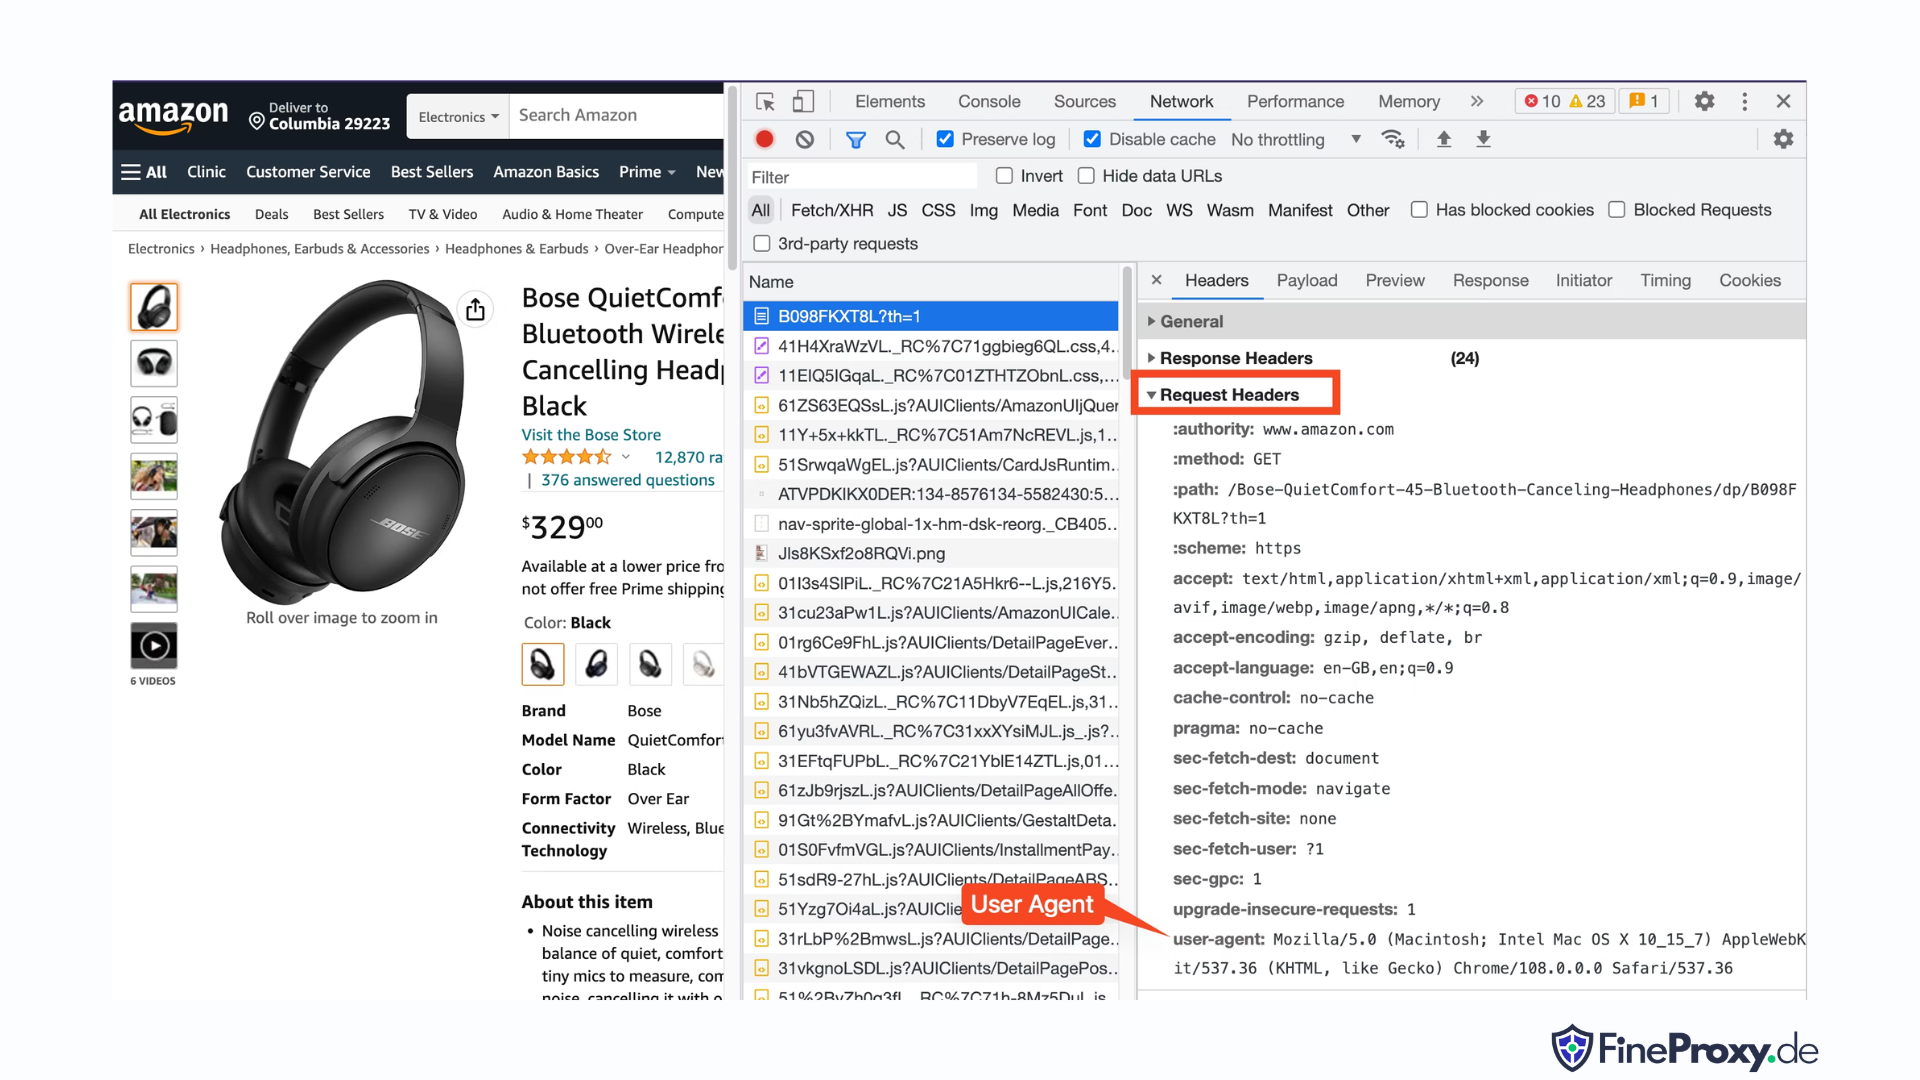
Чтобы узнать user-agent, отправляемый вашим браузером, нажмите F12, откройте вкладку Network и перезагрузите страницу. Выберите первый запрос и изучите Request Headers.
Скопируйте этот user-agent и создайте словарь заголовков, как в примере ниже с заголовками user-agent и accept-language:
custom_headers = { ' user-agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/108.0.0.0 Safari/537.36', 'accept-language': 'en-GB,en;q=0.9', }Затем можно передать этот словарь в качестве необязательного параметра методу get:
response = requests.get(url, headers=custom_headersСбор информации о товарах Amazon
При сборе данных о товарах Amazon обычно приходится работать с двумя типами страниц: страницей категории и страницей с подробной информацией о товаре.
Например, посетите страницу https://www.amazon.com/b?node=12097479011 или выполните поиск на Amazon по запросу «Полноразмерные наушники». Страница с результатами поиска называется страницей категории.
На странице категории указаны название товара, изображение товара, рейтинг товара, цена товара и, что особенно важно, URL-адреса страниц товаров. Чтобы получить дополнительную информацию, например описания товаров, необходимо перейти на страницу с подробной информацией о товаре.
Рассмотрим структуру страницы с подробной информацией о товаре.
Откройте URL-адрес товара, например https://www.amazon.com/Bose-QuietComfort-45-Bluetooth-Canceling-Headphones/dp/B098FKXT8L, в Chrome или другом современном браузере. Щёлкните правой кнопкой мыши название товара и выберите «Просмотреть код». Будет выделена HTML-разметка названия товара.
Вы увидите, что это тег span с атрибутом id, значение которого — «productTitle».
Аналогично щёлкните правой кнопкой мыши цену и выберите «Просмотреть код», чтобы увидеть HTML-разметку цены.
Целая часть цены в долларах находится в теге span с классом «a-price-whole», а часть с центами — в другом теге span с классом «a-price-fraction».
Таким же способом можно найти рейтинг, изображение и описание.
Собрав эту информацию, добавьте следующие строки в существующий код:
response = requests.get(url, headers=custom_headers) soup = BeautifulSoup(response.text, 'lxml')Beautiful Soup предлагает отдельный способ выбора тегов с помощью методов find. Кроме того, в качестве альтернативы поддерживаются CSS-селекторы. Для получения одинакового результата можно использовать любой из этих подходов. В этом руководстве мы воспользуемся CSS-селекторами — универсальным способом выбора элементов. CSS-селекторы совместимы практически со всеми инструментами веб-скрейпинга для извлечения информации о товарах Amazon.
Теперь можно использовать объект Soup для получения нужной информации.
Извлечение названия товара
Название товара находится в элементе span с идентификатором ‘productTitle’. Выбирать элементы по уникальным идентификаторам просто.
Рассмотрим следующий пример кода:
title_element = soup.select_one('#productTitle')Мы передаём CSS-селектор методу select_one, который возвращает экземпляр элемента.
Чтобы извлечь текстовую информацию, используйте атрибут text.
title = title_element.textПри выводе вы можете заметить несколько пробелов. Чтобы устранить их, добавьте вызов функции .strip(), как показано ниже:
title = title_element.text.strip()Извлечение рейтинга товара
Получение рейтинга товаров Amazon требует немного дополнительных усилий.
Сначала задайте селектор для рейтинга:
#acrPopoverЗатем используйте следующую инструкцию, чтобы выбрать элемент, содержащий рейтинг:
rating_element = soup.select_one('#acrPopover')Обратите внимание, что фактическое значение рейтинга находится в атрибуте title:
rating_text = rating_element.attrs.get('title') print(rating_text) # prints '4.6 out of 5 stars'Наконец, используйте метод replace, чтобы получить числовое значение рейтинга:
rating = rating_text.replace('out of 5 stars', '')Извлечение цены товара
Цену товара можно найти в двух местах — под названием товара и в блоке «Купить сейчас».
Для сбора цен товаров Amazon можно использовать любой из этих тегов.
Создайте CSS-селектор для цены:
#price_inside_buyboxПередайте этот CSS-селектор методу select_one библиотеки BeautifulSoup следующим образом:
price_element = soup.select_one('#price_inside_buybox')Теперь можно вывести цену:
print(price_element.text)Извлечение изображения
Чтобы собрать данные об изображении по умолчанию, используйте CSS-селектор #landingImage. С помощью этой информации можно написать следующие строки кода, чтобы получить URL-адрес изображения из атрибута src:
image_element = soup.select_one('#landingImage') image = image_element.attrs.get('src')Извлечение описания товара
Следующий шаг при извлечении данных о товарах Amazon — получение описания товара.
Процесс остаётся прежним: создайте CSS-селектор и используйте метод select_one.
CSS-селектор для описания:
#productDescriptionЭто позволяет извлечь элемент следующим образом:
description_element = soup.select_one('#productDescription') print(description_element.text)Обработка списка товаров
Мы рассмотрели сбор информации о товарах, но для получения данных о товарах сначала понадобится обработать список товаров или страницу категории.
Например, https://www.amazon.com/b?node=12097479011 — это страница категории полноразмерных наушников.
Если изучить эту страницу, можно увидеть, что все товары находятся внутри элемента div с уникальным атрибутом [data-asin]. Внутри этого элемента div все ссылки на товары расположены в теге h2.
На основании этой информации CSS-селектор будет таким:
[data-asin] h2 aМожно считывать атрибут href этого селектора и запускать цикл. Однако помните, что ссылки будут относительными. Для их обработки понадобится метод urljoin.
from urllib.parse import urljoin ... def parse_listing(listing_url): … link_elements = soup_search.select("[data-asin] h2 a") page_data = [] for link in link_elements: full_url = urljoin(search_url, link.attrs.get("href")) product_info = get_product_info(full_url) page_data.append(product_info)Обработка пагинации
Ссылка на следующую страницу находится в элементе link с текстом “Next”. Найти эту ссылку можно с помощью оператора contains в CSS:
next_page_el = soup.select_one('a:contains("Next")') if next_page_el: next_page_url = next_page_el.attrs.get('href') next_page_url = urljoin(listing_url, next_page_url)Экспорт данных Amazon
Собранные данные намеренно возвращаются в виде словаря. Можно создать список, содержащий все собранные товары.
def parse_listing(listing_url): ... page_data = [] for link in link_elements: ... product_info = get_product_info(full_url) page_data.append(product_info)Затем можно использовать page_data для создания объекта DataFrame библиотеки Pandas:
df = pd.DataFrame(page_data) df.to_csv('headphones.csv', index = False)Как парсить несколько страниц на Amazon
Парсинг нескольких страниц на Amazon может повысить эффективность вашего проекта по сбору данных из интернета, предоставляя более обширный набор данных для анализа. При работе с несколькими страницами необходимо учитывать пагинацию — процесс распределения контента по нескольким страницам.
Вот 6 ключевых моментов, которые следует учитывать при парсинге нескольких страниц на Amazon:
- Определите схему пагинации: Сначала проанализируйте структуру URL страниц категорий или результатов поиска, чтобы понять, как Amazon разбивает контент на страницы. Это может быть параметр запроса (например, «?page=2») или уникальный идентификатор, встроенный в URL.
- Извлеките ссылку на следующую страницу: Найдите элемент (обычно тег привязки), содержащий ссылку на следующую страницу. Используйте соответствующий CSS-селектор или метод Beautiful Soup, чтобы извлечь атрибут href этого элемента — URL следующей страницы.
- Преобразуйте относительные URL в абсолютные: Поскольку извлечённые URL могут быть относительными, используйте функцию
urljoinиз библиотекиurllib.parse, чтобы преобразовать их в абсолютные URL. - Создайте цикл: Реализуйте цикл, который будет проходить по страницам и собирать нужные данные с каждой из них. Цикл должен продолжаться, пока не останется страниц. Это можно определить, проверяя, есть ли на текущей странице ссылка на следующую.
- Добавляйте паузы между запросами: Чтобы не перегружать сервер Amazon и не запускать механизмы защиты от ботов, добавляйте паузы между запросами с помощью функции
time.sleep()из библиотекиtime. Настройте длительность паузы так, чтобы имитировать поведение человека при просмотре страниц. - Обработка CAPTCHA и блокировок: Если при парсинге нескольких страниц вы столкнётесь с CAPTCHA или блокировкой IP-адреса, рассмотрите возможность использования прокси для смены IP-адресов либо специальных инструментов и сервисов для парсинга, способных автоматически справляться с такими проблемами.
Ниже вы найдёте подробный видеоурок на YouTube, который расскажет, как извлекать данные с нескольких страниц сайта Amazon. В уроке подробно рассматривается парсинг веб-страниц и методы, которые помогут эффективно собирать полезную информацию с множества страниц Amazon.
В ходе урока ведущий демонстрирует использование необходимых инструментов и библиотек, таких как Python, BeautifulSoup и requests, а также рассказывает о лучших практиках, помогающих избежать блокировки или обнаружения механизмами защиты Amazon от ботов. В видео рассматриваются такие важные темы, как обработка пагинации, управление частотой запросов и имитация поведения человека при просмотре страниц.
Помимо пошаговых инструкций, представленных в видео, в уроке также приводятся полезные советы и рекомендации, которые помогут оптимизировать процесс парсинга. Например, можно использовать прокси для обхода ограничений по IP-адресам, менять User-Agent и заголовки запросов, а также правильно обрабатывать ошибки, чтобы процесс парсинга проходил плавно и без перебоев.
Парсинг Amazon: часто задаваемые вопросы
При извлечении данных с Amazon, популярной платформы электронной коммерции, необходимо учитывать некоторые важные моменты. Давайте рассмотрим часто задаваемые вопросы, связанные с парсингом данных Amazon.
1. Законно ли парсить Amazon?
Парсинг общедоступных данных в интернете законен, и это касается в том числе Amazon. Вы можете на законных основаниях собирать такую информацию, как сведения о товарах, описания, рейтинги и цены. Однако при сборе отзывов о товарах следует осторожно обращаться с персональными данными и учитывать защиту авторских прав. Например, имя и аватар автора отзыва могут считаться персональными данными, а текст отзыва может быть защищен авторским правом. Всегда соблюдайте осторожность и обращайтесь за юридической консультацией при сборе таких данных.
2. Разрешает ли Amazon парсинг?
Хотя сбор общедоступных данных законен, Amazon иногда принимает меры для предотвращения парсинга. К ним относятся ограничение частоты запросов, блокировка IP-адресов и использование отпечатков браузера для обнаружения ботов-парсеров. Обычно Amazon блокирует веб-парсинг, возвращая код успешного ответа 200 OK, и требует пройти CAPTCHA либо показывает сообщение HTTP Error 503 Service Unavailable с предложением связаться с отделом продаж и приобрести платный API.
Обойти эти меры возможно, но этичный веб-парсинг поможет изначально не вызывать их срабатывания. Этичный веб-парсинг предполагает ограничение частоты запросов, использование подходящих user agent и отказ от чрезмерного сбора данных, который может повлиять на работу сайта. Соблюдая этические принципы парсинга, вы можете снизить риск блокировки или юридических последствий и при этом извлекать полезные данные с Amazon.
3. Этично ли собирать данные с Amazon?
Этичный парсинг предполагает уважительное отношение к целевому сайту. Хотя маловероятно, что вы перегрузите сайт Amazon слишком большим количеством запросов, все же следует придерживаться этических рекомендаций по парсингу. Этичный сбор данных помогает снизить риск юридических проблем и столкновения с мерами против парсинга.
4. Как избежать блокировки при парсинге Amazon?
Чтобы избежать блокировки при парсинге Amazon, ограничивайте частоту запросов, не собирайте данные в часы пик, используйте интеллектуальную ротацию прокси, а также подходящие user agent и заголовки, чтобы не привлекать внимания. Кроме того, извлекайте только необходимые данные и используйте сторонние инструменты или библиотеки для парсинга.
5. Чем грозит парсинг Amazon?
Сбор данных с Amazon сопряжен с потенциальными рисками, такими как судебные иски и блокировка учетной записи. Amazon использует меры против ботов для обнаружения и предотвращения парсинга, включая блокировку IP-адресов, ограничение частоты запросов и снятие отпечатков браузера. Однако этичный парсинг позволяет снизить эти риски.
Заключение
Покидая захватывающий лабиринт веб-парсинга Amazon, давайте на мгновение остановимся и оценим бесценные знания и навыки, приобретенные в этом увлекательном путешествии. С ProxyCompass в роли надежного проводника вы успешно преодолели все повороты и препятствия на пути к извлечению бесценных данных из розничного гиганта. Отправляясь дальше и умело применяя новые знания, помните: цифровые джунгли не перестают меняться.
Сохраняйте любознательность, продолжайте оттачивать свое мачете для веб-парсинга и покорять постоянно меняющийся мир извлечения данных. До следующей смелой экспедиции, отважный исследователь, пусть ваши начинания, основанные на данных, будут плодотворными и успешными!