
想象一下自己是一位充满冒险精神的探险家,纵身跃入亚马逊广袤而神秘的领域——不是热带雨林,而是这家在线零售巨头。每一次点击,你都会发现珍贵的宝藏,在数据的未知疆域中不断深入探索。
在这场激动人心的探险中,我们将为你提供一份循序渐进的指南,带你穿越亚马逊网页抓取这片茂密的数字丛林。做好准备,开启一段别样的旅程,借助专家技巧,以无与伦比的精度提取有价值的信息。
目录
那么,鼓起勇气,穿上你的虚拟探险靴,让我们一起开启这场数据驱动的冒险吧!
从亚马逊抓取哪些数据
亚马逊商品包含许多数据点,但抓取时需要重点关注的关键要素包括:
- 商品标题
- 价格
- 优惠金额(如适用)
- 商品摘要
- 相关特性列表(如有)
- 评论评分
- 商品图片
尽管这些是抓取亚马逊商品时需要考虑的主要方面,但请注意,你提取的信息可能会根据你的具体目标而有所不同。
一些基本要求
煲汤需要合适的食材。同样,我们的新网页抓取工具也需要特定的组件。
- Python — Python 易于使用,且拥有丰富的库,因此是网页抓取的首选。如果尚未安装,请参阅本指南。
- BeautifulSoup — 这是众多 Python 网页抓取库之一。它简单易用,因此很受欢迎。成功安装 Python 后,可以运行以下命令来安装 Beautiful Soup:pip install bs4
- HTML 标签基础知识 — 请参阅本教程,了解 HTML 标签所需的知识。
- 网页浏览器 — 由于我们需要从网站中过滤掉大量无关信息,因此需要使用特定的 id 和标签进行筛选。Google Chrome 或 Mozilla Firefox 等网页浏览器有助于识别这些标签。
为抓取做好准备
首先,请确保已安装 Python。如果你没有安装 Python 3.8 或更高版本,请访问 python.org 下载并安装最新版本。
接下来,创建一个目录,用于存放 Amazon 网页抓取代码文件。通常,最好为项目设置一个虚拟环境。
在 macOS 和 Linux 上,使用以下命令创建并激活虚拟环境:
$ python3 -m venv .env $ source .env/bin/activateWindows 用户使用的命令略有不同:
d:amazon>python -m venv .env d:amazon>.envscriptsactivate现在该安装必需的 Python 软件包了。
你需要用于两项主要任务的软件包:获取 HTML,以及解析 HTML 以提取相关数据。
Requests 库是一个广泛使用的第三方 Python 库,可用于发送 HTTP 请求。它提供了简单易用的接口,用于向 Web 服务器发送 HTTP 请求并接收响应。它或许是最知名的网页抓取库。
不过,Requests 库有一个局限:它会将 HTML 响应作为字符串返回,因此在编写网页抓取代码时,很难搜索商品标价等特定元素。
这时就需要 Beautiful Soup。Beautiful Soup 是一个专为网页抓取设计的 Python 库,可从 HTML 和 XML 文件中提取数据。它支持通过搜索标签、属性或特定文本来获取网页中的信息。
要安装这两个库,请使用以下命令:
$ python3 -m pip install requests beautifulsoup4Windows 用户只需将 ‘python3’ 替换为 ‘python’,命令的其他部分保持不变:
d:amazon>python -m pip install requests beautifulsoup4请注意,我们安装的是 Beautiful Soup 库的第 4 版。
现在来测试 Requests 抓取库。创建一个名为 amazon.py 的新文件,并输入以下代码:
import requests url = ' https://www.amazon.com/Bose-QuietComfort-45-Bluetooth-Canceling-Headphones/dp/B098FKXT8L' response = requests.get(url) print(response.text)保存文件,并在终端中运行它。
$ python3 amazon.py在大多数情况下,你无法查看所需的 HTML。Amazon 会拦截请求,并返回以下响应:
如需讨论对 Amazon 数据的自动化访问,请联系 [email protected]。如果你打印 response.status_code,就会看到收到的是 503 错误,而不是表示成功的 200 状态码。
Amazon 知道该请求并非来自浏览器,因此会拦截它。许多网站都普遍采用这种做法。Amazon 可能会拦截你的请求,并返回以 500 开头,有时甚至以 400 开头的错误代码。
一个简单的解决办法是随请求发送标头,模拟浏览器发送的标头。
有时只发送 user-agent 就足够了;其他时候,你可能还需要发送其他标头,例如 accept-language 标头。
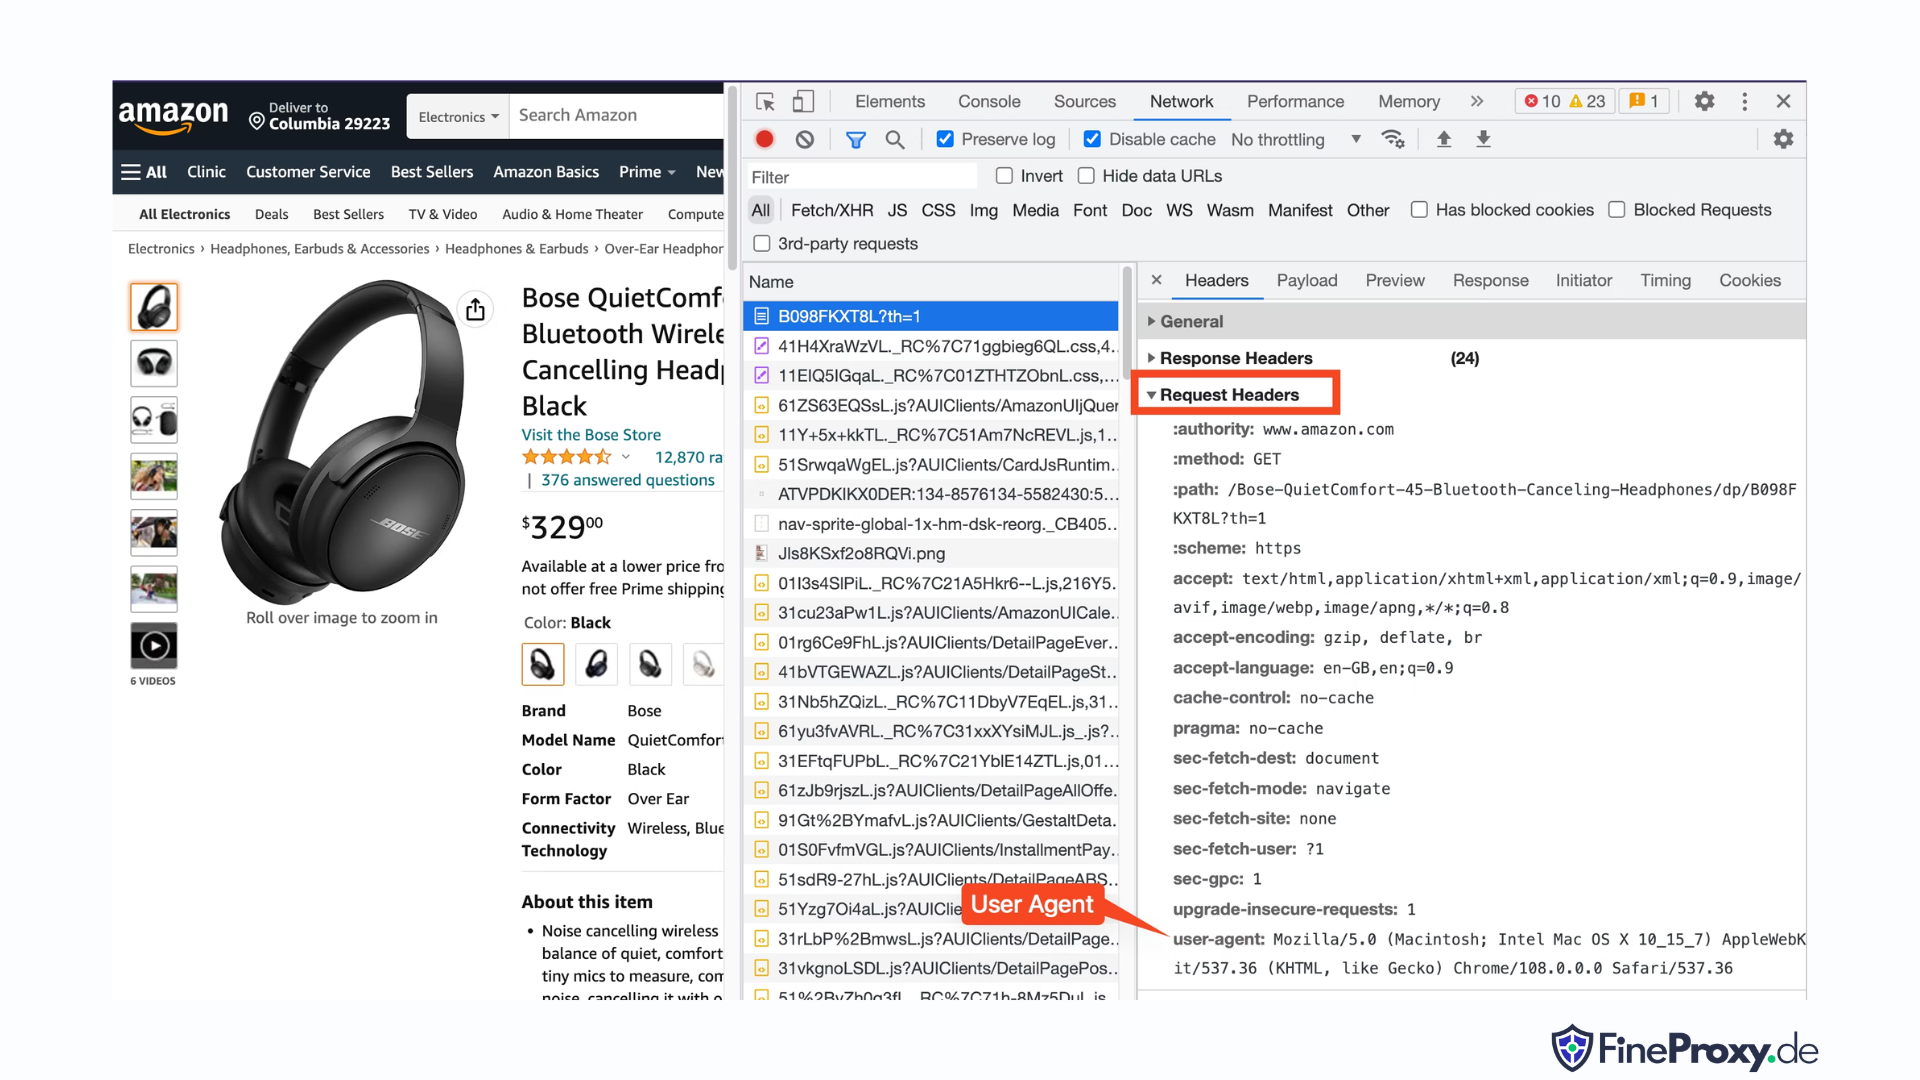
要查找浏览器发送的 user-agent,请按 F12,打开 Network 选项卡,然后重新加载页面。选择第一个请求并查看 Request Headers。
复制此 user-agent,并创建一个标头字典,例如包含 user-agent 和 accept-language 标头的字典:
custom_headers = { ' user-agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/108.0.0.0 Safari/537.36', 'accept-language': 'en-GB,en;q=0.9', }然后,你可以将此字典作为可选参数传入 get 方法:
response = requests.get(url, headers=custom_headers抓取 Amazon 产品信息
在抓取 Amazon 产品的过程中,通常会接触两类页面:类别页面和产品详情页面。
例如,访问 https://www.amazon.com/b?node=12097479011,或在 Amazon 上搜索头戴式耳机。显示搜索结果的页面称为类别页面。
类别页面会显示产品标题、产品图片、产品评分、产品价格,最重要的是产品链接页面。若要获取更多信息,例如产品描述,则必须访问产品详情页面。
我们来分析一下产品详情页面的结构。
使用 Chrome 或其他现代浏览器打开一个产品 URL,例如 https://www.amazon.com/Bose-QuietComfort-45-Bluetooth-Canceling-Headphones/dp/B098FKXT8L。右键单击产品标题并选择“检查”。产品标题的 HTML 标记就会高亮显示。
你会发现,它是一个 span 标签,其 id 属性设置为“productTitle”。
同样,右键单击价格并选择“检查”,即可查看价格的 HTML 标记。
价格中的美元部分位于 class 为“a-price-whole”的 span 标签中,而美分部分则位于另一个 class 为“a-price-fraction”的 span 标签中。
你也可以用同样的方法找到评分、图片和描述。
收集到这些信息后,将以下几行添加到现有代码中:
response = requests.get(url, headers=custom_headers) soup = BeautifulSoup(response.text, 'lxml')Beautiful Soup 提供了使用 find 方法选择标签的独特方式。它也支持将 CSS 选择器作为替代方案。你可以使用任一方法实现相同的结果。在本教程中,我们将使用 CSS 选择器,这是一种通用的元素选择方法。几乎所有网页抓取工具都支持 CSS 选择器,可用于提取 Amazon 产品信息。
现在,你可以使用 Soup 对象查询特定信息了。
提取产品名称
产品名称或标题位于 id 为‘productTitle’的 span 元素中。使用唯一 id 选择元素很简单。
以下代码为例:
title_element = soup.select_one('#productTitle')我们将 CSS 选择器传递给 select_one 方法,该方法会返回一个元素实例。
要从文本中提取信息,请使用 text 属性。
title = title_element.text打印时,你可能会注意到有一些空白字符。要解决这个问题,请按如下方式添加 .strip() 函数调用:
title = title_element.text.strip()提取产品评分
获取 Amazon 产品评分需要多做一些工作。
首先,为评分设置一个选择器:
#acrPopover接下来,使用以下语句选择包含评分的元素:
rating_element = soup.select_one('#acrPopover')请注意,实际评分值位于 title 属性中:
rating_text = rating_element.attrs.get('title') print(rating_text) # prints '4.6 out of 5 stars'最后,使用 replace 方法获取数值评分:
rating = rating_text.replace('out of 5 stars', '')提取产品价格
产品价格有两个位置——产品标题下方和“立即购买”框内。
可以使用这两个标签中的任意一个来抓取 Amazon 产品价格。
为价格创建一个 CSS 选择器:
#price_inside_buybox像这样将此 CSS 选择器传递给 BeautifulSoup 的 select_one 方法:
price_element = soup.select_one('#price_inside_buybox')现在,你可以打印价格:
print(price_element.text)提取图片
要抓取默认图片,请使用 CSS 选择器 #landingImage。有了这些信息,你可以编写以下代码行,从 src 属性中获取图片 URL:
image_element = soup.select_one('#landingImage') image = image_element.attrs.get('src')提取产品描述
提取 Amazon 产品数据的下一步是获取产品描述。
这个过程保持不变——创建一个 CSS 选择器并使用 select_one 方法。
描述对应的 CSS 选择器是:
#productDescription这样我们就可以按如下方式提取该元素:
description_element = soup.select_one('#productDescription') print(description_element.text)处理产品列表
我们已经了解了如何抓取产品信息,但要访问产品数据,你需要从产品列表或类别页面开始。
例如,https://www.amazon.com/b?node=12097479011 是头戴式耳机的类别页面。
检查此页面后,你会发现所有产品都包含在一个具有唯一属性 [data-asin] 的 div 中。在该 div 内,所有产品链接都位于 h2 标签中。
根据这些信息,CSS 选择器为:
[data-asin] h2 a你可以读取此选择器的 href 属性并运行循环。不过,请记住,这些链接是相对链接。你需要使用 urljoin 方法来解析这些链接。
from urllib.parse import urljoin ... def parse_listing(listing_url): … link_elements = soup_search.select("[data-asin] h2 a") page_data = [] for link in link_elements: full_url = urljoin(search_url, link.attrs.get("href")) product_info = get_product_info(full_url) page_data.append(product_info)处理分页
指向下一页的链接位于包含文本“Next”的链接中。你可以使用 CSS 的 contains 运算符搜索此链接,如下所示:
next_page_el = soup.select_one('a:contains("Next")') if next_page_el: next_page_url = next_page_el.attrs.get('href') next_page_url = urljoin(listing_url, next_page_url)导出 Amazon 数据
抓取的数据会有意以字典形式返回。你可以创建一个包含所有抓取产品的列表。
def parse_listing(listing_url): ... page_data = [] for link in link_elements: ... product_info = get_product_info(full_url) page_data.append(product_info)然后,你可以使用此 page_data 创建 Pandas DataFrame 对象:
df = pd.DataFrame(page_data) df.to_csv('headphones.csv', index = False)如何抓取亚马逊上的多个页面
抓取亚马逊上的多个页面,可以通过提供更广泛的数据集供分析,从而提升网页抓取项目的成效。抓取多个页面时,你需要考虑分页,也就是将内容分布在多个页面上的过程。
抓取亚马逊上的多个页面时,请牢记以下6 个要点:
- 识别分页模式:首先,分析类别页或搜索结果页的 URL 结构,了解亚马逊如何对内容进行分页。这可能是一个查询参数(例如“?page=2”),也可能是嵌入 URL 中的唯一标识符。
- 提取“下一页”链接:找到包含下一页链接的元素(通常是锚点标签)。使用适当的 CSS 选择器或 Beautiful Soup 方法提取该元素的 href 属性,该属性对应的 URL 就是下一页的网址。
- 将相对 URL 转换为绝对 URL:由于提取到的 URL 可能是相对 URL,请使用
urllib.parse库中的urljoin函数将它们转换为绝对 URL。 - 创建循环:编写一个循环,遍历各个页面并抓取每页所需的数据。当当前页面不存在“下一页”链接时,即可判断没有更多页面,循环也应随之结束。
- 在请求之间加入延迟:为避免给亚马逊服务器造成过大压力或触发反机器人措施,请使用
time库中的time.sleep()函数,在请求之间加入延迟。调整延迟时长,以模拟人类的浏览行为。 - 处理 CAPTCHA 和封锁:如果在抓取多个页面时遇到 CAPTCHA 或 IP 封锁,可以考虑使用代理轮换 IP 地址,或使用能够自动应对这些问题的专用抓取工具和服务。
下面是一段详尽的 YouTube 视频教程,带你了解如何从亚马逊网站的多个页面提取数据。教程深入讲解网页抓取,重点介绍能够帮助你高效、有效地从亚马逊众多页面收集有价值信息的技巧。
教程中,讲解者演示了 Python、BeautifulSoup 和 requests 等必要工具与库的使用方法,同时介绍了避免被亚马逊的反机器人机制封锁或检测到的最佳实践。视频涵盖了分页处理、速率限制管理以及模拟人类浏览行为等重要主题。
除了视频中提供的逐步说明外,教程还分享了优化网页抓取体验的实用技巧和窍门,包括使用代理绕过 IP 限制、随机设置 User-Agent 和请求标头,以及实现适当的错误处理,以确保抓取过程顺畅、不间断。
抓取 Amazon:常见问题
说到从 Amazon 这个热门电子商务平台提取数据,有一些事项需要注意。让我们来看看有关抓取 Amazon 数据的常见问题。
1. 抓取 Amazon 合法吗?
抓取互联网上公开可用的数据是合法的,其中也包括抓取 Amazon。你可以合法地抓取产品详情、描述、评分和价格等信息。不过,在抓取产品评论时,应谨慎处理个人数据和版权保护问题。例如,评论者的姓名和头像可能属于个人数据,而评论文本可能受版权保护。抓取此类数据时务必谨慎,并寻求法律建议。
2. Amazon 允许抓取吗?
尽管抓取公开可用的数据是合法的,但 Amazon 有时会采取措施阻止抓取。这些措施包括限制请求频率、封禁 IP 地址,以及使用浏览器指纹识别来检测抓取机器人。Amazon 通常会通过返回 200 OK 成功状态响应码来阻止网页抓取,并要求你通过 CAPTCHA,或者显示 HTTP Error 503 Service Unavailable 消息,引导你联系销售部门购买付费 API。
有一些方法可以绕过这些措施,但遵循道德规范进行网页抓取,有助于从一开始就避免触发这些措施。道德网页抓取包括限制请求频率、使用恰当的用户代理,以及避免过度抓取,以免影响网站性能。通过遵循道德规范进行抓取,你可以降低被封禁或面临法律后果的风险,同时仍然能够从 Amazon 提取有用数据。
3. 抓取 Amazon 数据符合道德规范吗?
道德抓取意味着尊重目标网站。虽然你不太可能因为请求过多而导致 Amazon 网站过载,但仍应遵循道德抓取准则。道德抓取可以降低面临法律问题或遭遇反抓取措施的风险。
4. 抓取 Amazon 时如何避免被封禁?
为了避免抓取 Amazon 时被封禁,你应限制请求频率,避免在高峰时段抓取,使用智能代理轮换,并使用恰当的用户代理和标头来避免被检测到。此外,只提取所需数据,并使用第三方抓取工具或抓取库。
5. 抓取 Amazon 有哪些风险?
抓取 Amazon 数据可能带来潜在风险,例如面临法律诉讼或账户被暂停。Amazon 会使用反机器人措施来检测并阻止抓取,包括封禁 IP 地址、限制请求频率和浏览器指纹识别。不过,通过遵循道德规范进行抓取,你可以降低这些风险。
结论
当我们走出 Amazon 网页抓取这座引人入胜的迷宫时,不妨停下来回顾一下,在这段令人振奋的旅程中积累的宝贵知识与技能。在 ProxyCompass 这位可信向导的帮助下,你已成功穿越重重曲折,从这个零售巨头那里提取珍贵数据。继续前行,娴熟运用新掌握的专业技能时,请记住,数字丛林始终在不断演变。
保持好奇,不断磨砺你的网页抓取开山刀,继续征服瞬息万变的数据提取领域。勇敢的探索者,在我们下一次大胆探险之前,愿你的数据驱动之旅硕果累累、收获丰厚!