
Imagine-se como um explorador aventureiro, mergulhando de cabeça no vasto e misterioso universo da Amazon — não a floresta tropical, mas a gigante do varejo online. A cada clique, você descobre tesouros inestimáveis, explorando cada vez mais esse território inexplorado de dados.
Nesta expedição emocionante, apresentamos um guia passo a passo para navegar pela densa selva digital do web scraping da Amazon. Prepare-se para embarcar em uma jornada como nenhuma outra, munido de dicas e truques especializados para extrair informações valiosas com precisão incomparável.
Sumário
- Quais dados extrair da Amazon
- Alguns requisitos básicos
- Preparação para o scraping
- Extração de informações de produtos da Amazon
- Como extrair dados de várias páginas da Amazon
- Extração de dados da Amazon: perguntas frequentes
- Conclusão
Então, reúna sua coragem, calce suas botas virtuais e vamos começar juntos esta aventura orientada por dados!
Quais dados extrair da Amazon
Há inúmeros pontos de dados associados a um produto da Amazon, mas os principais elementos a considerar ao fazer scraping incluem:
- Título do produto
- Preço
- Descontos (quando aplicável)
- Resumo do item
- Lista de características associadas (se disponível)
- Pontuação das avaliações
- Imagens do produto
Embora esses sejam os principais aspectos a considerar ao fazer scraping de um item da Amazon, é importante observar que as informações extraídas podem variar de acordo com seus objetivos específicos.
Alguns requisitos básicos
Para preparar uma sopa, precisamos dos ingredientes certos. Da mesma forma, nosso novo web scraper exige componentes específicos.
- Python — Sua facilidade de uso e extensa coleção de bibliotecas fazem do Python a principal escolha para web scraping. Se ainda não estiver instalado, consulte este guia.
- BeautifulSoup — Esta é uma das muitas bibliotecas de web scraping disponíveis para Python. Sua simplicidade e facilidade de uso fazem dela uma escolha popular para web scraping. Após instalar o Python com sucesso, você pode instalar o Beautiful Soup executando: pip install bs4
- Conhecimento básico de tags HTML — Consulte este tutorial para adquirir o conhecimento necessário sobre tags HTML.
- Navegador da web — Como precisamos filtrar muitas informações irrelevantes de um site, são necessários IDs e tags específicos para essa finalidade. Um navegador da web como Google Chrome ou Mozilla Firefox é útil para identificar essas tags.
Preparação para scraping
Para começar, certifique-se de que o Python esteja instalado. Se você não tiver o Python 3.8 ou posterior, acesse python.org para baixar e instalar a versão mais recente.
Em seguida, crie um diretório para armazenar os arquivos de código de web scraping para a Amazon. Geralmente, é uma boa ideia configurar um ambiente virtual para o seu projeto.
Use os seguintes comandos para criar e ativar um ambiente virtual no macOS e no Linux:
$ python3 -m venv .env $ source .env/bin/activatePara usuários do Windows, os comandos serão um pouco diferentes:
d:amazon>python -m venv .env d:amazon>.envscriptsactivateAgora é hora de instalar os pacotes Python necessários.
Você precisará de pacotes para duas tarefas principais: obter o HTML e analisá-lo para extrair dados relevantes.
A biblioteca Requests é uma biblioteca Python de terceiros muito usada para fazer solicitações HTTP. Ela oferece uma interface simples e fácil de usar para fazer solicitações HTTP a servidores web e receber respostas. Talvez seja a biblioteca mais conhecida para web scraping.
No entanto, a biblioteca Requests tem uma limitação: ela retorna a resposta HTML como uma string, que pode ser difícil de pesquisar para encontrar elementos específicos, como preços de anúncios, ao escrever código de web scraping.
É aí que entra o Beautiful Soup. O Beautiful Soup é uma biblioteca Python criada para web scraping que extrai dados de arquivos HTML e XML. Ela permite obter informações de uma página da web pesquisando tags, atributos ou textos específicos.
Para instalar ambas as bibliotecas, use o seguinte comando:
$ python3 -m pip install requests beautifulsoup4Para usuários do Windows, substitua ‘python3’ por ‘python’ e mantenha o restante do comando igual:
d:amazon>python -m pip install requests beautifulsoup4Observe que estamos instalando a versão 4 da biblioteca Beautiful Soup.
Agora vamos testar a biblioteca Requests para scraping. Crie um novo arquivo chamado amazon.py e insira o seguinte código:
import requests url = ' https://www.amazon.com/Bose-QuietComfort-45-Bluetooth-Canceling-Headphones/dp/B098FKXT8L' response = requests.get(url) print(response.text)Salve o arquivo e execute-o no terminal.
$ python3 amazon.pyNa maioria dos casos, você não conseguirá visualizar o HTML desejado. A Amazon bloqueará a solicitação e você receberá a seguinte resposta:
To discuss automated access to Amazon data please contact [email protected].Se você imprimir response.status_code, verá que recebe um erro 503 em vez de um código de sucesso 200.
A Amazon sabe que essa solicitação não veio de um navegador e a bloqueia. Essa prática é comum em muitos sites. A Amazon pode bloquear suas solicitações e retornar um código de erro que começa com 500 ou, às vezes, até com 400.
Uma solução simples é enviar cabeçalhos com sua solicitação que imitem os enviados por um navegador.
Às vezes, enviar apenas o agente do usuário é suficiente. Em outros casos, talvez seja necessário enviar cabeçalhos adicionais, como o cabeçalho accept-language.
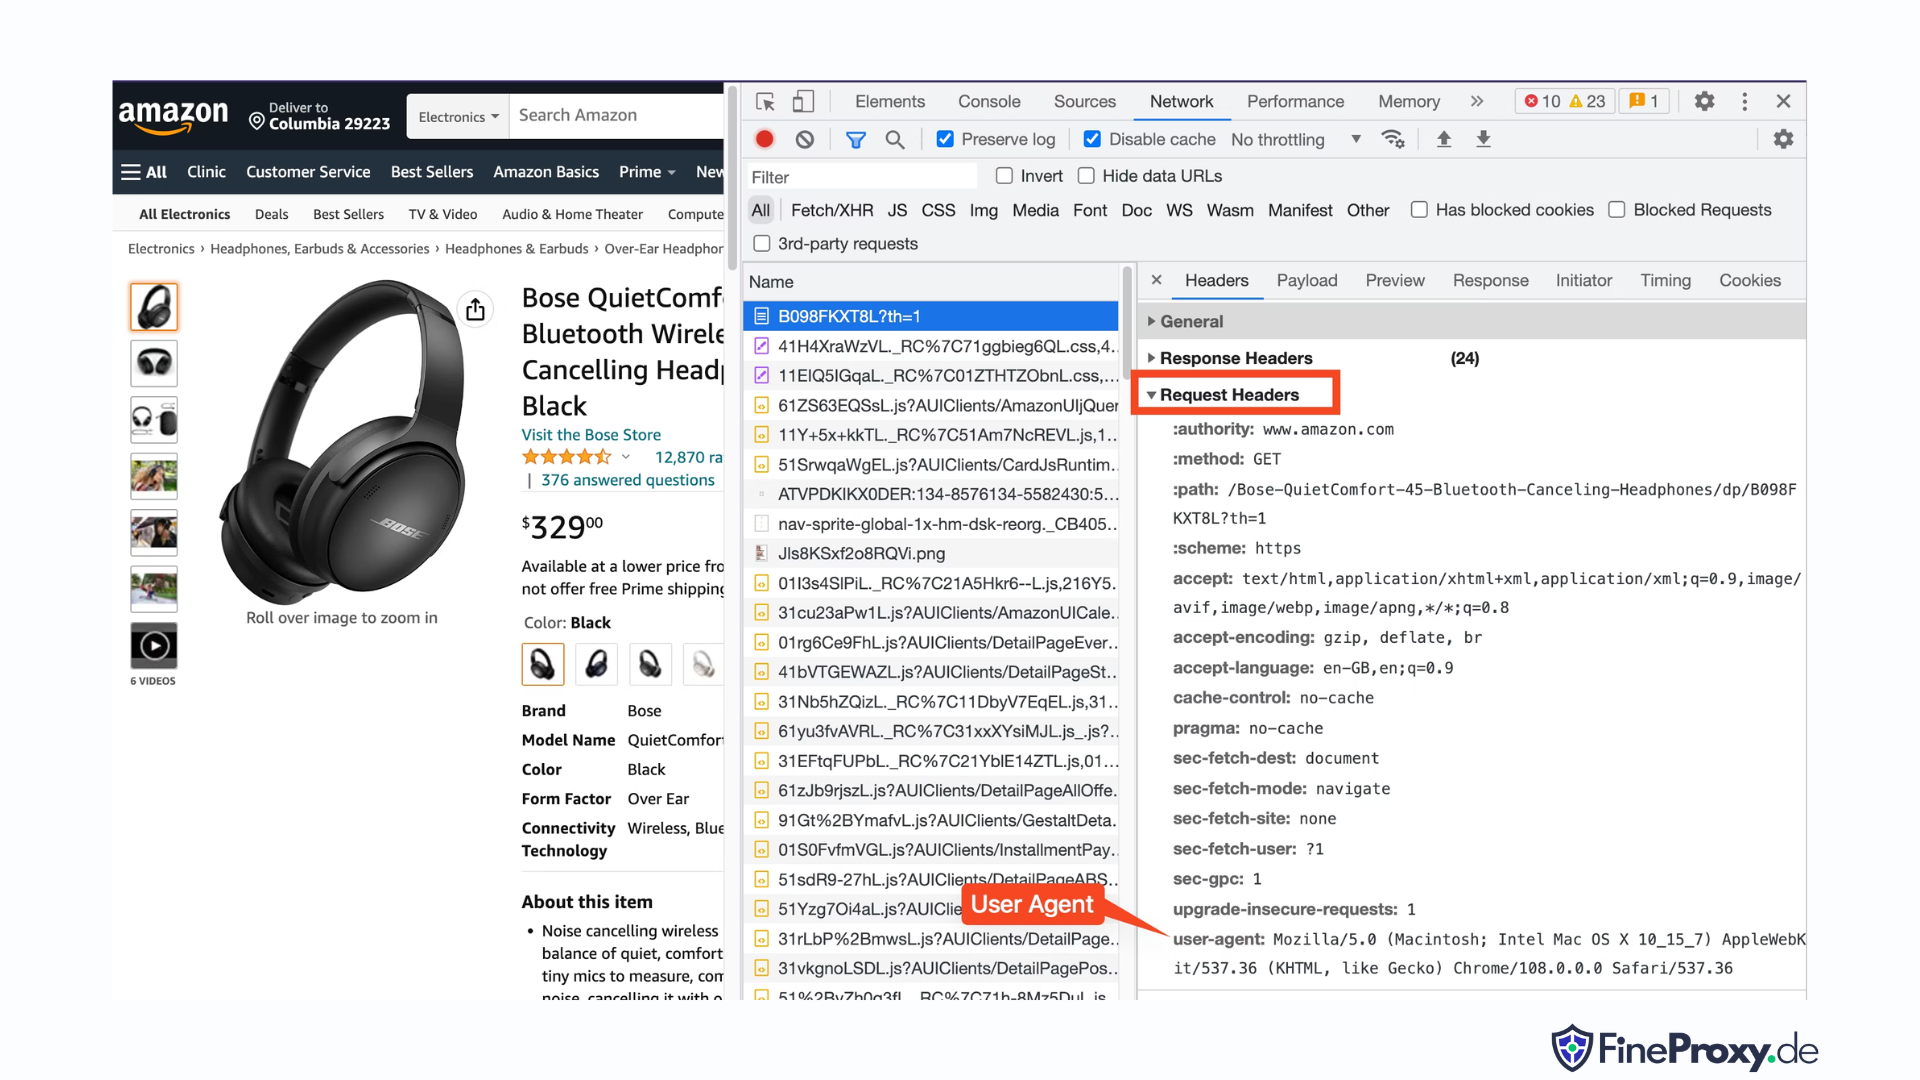
Para encontrar o agente do usuário enviado pelo seu navegador, pressione F12, abra a guia Network e recarregue a página. Selecione a primeira solicitação e examine os cabeçalhos da solicitação.
Copie esse agente do usuário e crie um dicionário para os cabeçalhos, como neste exemplo com os cabeçalhos user-agent e accept-language:
custom_headers = { ' user-agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/108.0.0.0 Safari/537.36', 'accept-language': 'en-GB,en;q=0.9', }Você pode então enviar esse dicionário como um parâmetro opcional no método get:
response = requests.get(url, headers=custom_headersRaspagem de informações de produtos da Amazon
Ao realizar a raspagem de produtos da Amazon na web, você normalmente interage com dois tipos de páginas: a página de categoria e a página de detalhes do produto.
Por exemplo, acesse https://www.amazon.com/b?node=12097479011 ou pesquise por fones de ouvido over-ear na Amazon. A página que exibe os resultados da pesquisa é conhecida como página de categoria.
A página de categoria apresenta o título do produto, a imagem do produto, a avaliação do produto, o preço do produto e, o mais importante, os URLs das páginas dos produtos. Para acessar mais informações, como descrições dos produtos, é necessário visitar a página de detalhes do produto.
Vamos analisar a estrutura da página de detalhes do produto.
Abra um URL de produto, como https://www.amazon.com/Bose-QuietComfort-45-Bluetooth-Canceling-Headphones/dp/B098FKXT8L, usando o Chrome ou outro navegador moderno. Clique com o botão direito do mouse no título do produto e escolha Inspecionar. A marcação HTML do título do produto será destacada.
Você perceberá que é uma tag span cujo atributo id está definido como “productTitle”.
Da mesma forma, clique com o botão direito do mouse no preço e selecione Inspecionar para visualizar a marcação HTML do preço.
A parte em dólares do preço está em uma tag span com a classe “a-price-whole”, enquanto a parte dos centavos está em outra tag span com a classe “a-price-fraction”.
Você também pode localizar a avaliação, a imagem e a descrição da mesma maneira.
Depois de reunir essas informações, adicione as seguintes linhas ao código existente:
response = requests.get(url, headers=custom_headers) soup = BeautifulSoup(response.text, 'lxml')O Beautiful Soup oferece um método específico para selecionar tags usando os métodos find. Ele também aceita seletores CSS como alternativa. Você pode usar qualquer uma das abordagens para obter o mesmo resultado. Neste tutorial, utilizaremos seletores CSS, um método universal para selecionar elementos. Os seletores CSS são compatíveis com quase todas as ferramentas de raspagem da web para extrair informações de produtos da Amazon.
Agora você está pronto para usar o objeto Soup para consultar informações específicas.
Extraindo o nome do produto
O nome ou título do produto está em um elemento span com o id ‘productTitle’. Selecionar elementos usando ids exclusivos é simples.
Considere o seguinte código como exemplo:
title_element = soup.select_one('#productTitle')Passamos o seletor CSS para o método select_one, que retorna uma instância do elemento.
Para extrair informações do texto, use o atributo text.
title = title_element.textAo imprimir, você poderá notar alguns espaços em branco. Para resolver isso, adicione uma chamada à função .strip() da seguinte forma:
title = title_element.text.strip()Extraindo as avaliações dos produtos
Obter avaliações de produtos da Amazon exige um esforço adicional.
Primeiro, defina um seletor para a avaliação:
#acrPopoverEm seguida, use a seguinte instrução para selecionar o elemento que contém a avaliação:
rating_element = soup.select_one('#acrPopover')Observe que o valor real da avaliação está no atributo title:
rating_text = rating_element.attrs.get('title') print(rating_text) # prints '4.6 out of 5 stars'Por fim, use o método replace para obter a avaliação numérica:
rating = rating_text.replace('out of 5 stars', '')Extraindo o preço do produto
O preço do produto pode ser encontrado em dois locais — abaixo do título do produto e dentro da caixa Comprar agora.
Qualquer uma dessas tags pode ser usada para raspar os preços dos produtos da Amazon.
Crie um seletor CSS para o preço:
#price_inside_buyboxPasse esse seletor CSS para o método select_one do BeautifulSoup, assim:
price_element = soup.select_one('#price_inside_buybox')Agora, você pode imprimir o preço:
print(price_element.text)Extraindo a imagem
Para raspar a imagem padrão, use o seletor CSS #landingImage. Com essas informações, você pode escrever as seguintes linhas de código para obter o URL da imagem a partir do atributo src:
image_element = soup.select_one('#landingImage') image = image_element.attrs.get('src')Extraindo a descrição do produto
A próxima etapa na extração de dados de produtos da Amazon é obter a descrição do produto.
O processo continua o mesmo — crie um seletor CSS e use o método select_one.
O seletor CSS para a descrição é:
#productDescriptionIsso nos permite extrair o elemento da seguinte forma:
description_element = soup.select_one('#productDescription') print(description_element.text)Processando listagens de produtos
Exploramos como raspar informações de produtos, mas você precisará começar pelas listagens de produtos ou páginas de categoria para acessar os dados dos produtos.
Por exemplo, https://www.amazon.com/b?node=12097479011 é a página de categoria de fones de ouvido over-ear.
Se você examinar essa página, verá que todos os produtos estão dentro de uma div que tem um atributo exclusivo [data-asin]. Dentro dessa div, todos os links dos produtos estão em uma tag h2.
Com essas informações, o seletor CSS é:
[data-asin] h2 aVocê pode ler o atributo href desse seletor e executar um loop. No entanto, lembre-se de que os links serão relativos. Será necessário usar o método urljoin para analisá-los.
from urllib.parse import urljoin ... def parse_listing(listing_url): … link_elements = soup_search.select("[data-asin] h2 a") page_data = [] for link in link_elements: full_url = urljoin(search_url, link.attrs.get("href")) product_info = get_product_info(full_url) page_data.append(product_info)Processando a paginação
O link para a próxima página está em um link que contém o texto “Próxima”. Você pode pesquisar esse link usando o operador contains do CSS da seguinte forma:
next_page_el = soup.select_one('a:contains("Next")') if next_page_el: next_page_url = next_page_el.attrs.get('href') next_page_url = urljoin(listing_url, next_page_url)Exportando dados da Amazon
Os dados raspados são retornados intencionalmente como um dicionário. Você pode criar uma lista contendo todos os produtos raspados.
def parse_listing(listing_url): ... page_data = [] for link in link_elements: ... product_info = get_product_info(full_url) page_data.append(product_info)Em seguida, você pode usar esse page_data para criar um objeto DataFrame do Pandas:
df = pd.DataFrame(page_data) df.to_csv('headphones.csv', index = False)Como extrair dados de várias páginas da Amazon
Extrair dados de várias páginas da Amazon pode aumentar a eficácia do seu projeto de web scraping, fornecendo um conjunto de dados mais amplo para análise. Ao direcionar várias páginas, você precisará considerar a paginação, que é o processo de dividir o conteúdo em várias páginas.
Aqui estão 6 pontos principais que você deve ter em mente ao extrair dados de várias páginas da Amazon:
- Identifique o padrão de paginação: Primeiro, analise a estrutura dos URLs das páginas de categoria ou de resultados de pesquisa para entender como a Amazon divide o conteúdo em páginas. Isso pode ser um parâmetro de consulta (por exemplo, “?page=2”) ou um identificador exclusivo incorporado ao URL.
- Extraia o link da página “Seguinte”: Localize o elemento (geralmente uma tag âncora) que contém o link para a próxima página. Use o seletor CSS apropriado ou o método do Beautiful Soup para extrair o atributo href desse elemento, que corresponde ao URL da próxima página.
- Converta URLs relativos em URLs absolutos: Como os URLs extraídos podem ser relativos, use a função
urljoinda bibliotecaurllib.parsepara convertê-los em URLs absolutos. - Crie um loop: Implemente um loop que percorra as páginas, extraindo os dados desejados de cada uma delas. O loop deve continuar até não haver mais páginas, o que pode ser determinado verificando se o link da página “Seguinte” existe na página atual.
- Adicione intervalos entre as solicitações: Para evitar sobrecarregar o servidor da Amazon ou acionar medidas antibot, introduza intervalos entre as solicitações usando a função
time.sleep()da bibliotecatime. Ajuste a duração do intervalo para imitar o comportamento de navegação de uma pessoa. - Como lidar com CAPTCHAs e bloqueios: Se você encontrar CAPTCHAs ou bloqueios de IP ao extrair dados de várias páginas, considere usar proxies para alternar os endereços IP ou ferramentas e serviços dedicados de extração de dados que possam lidar com esses desafios automaticamente.
Abaixo, você encontrará um tutorial abrangente em vídeo do YouTube que orienta você pelo processo de extração de dados de várias páginas do site da Amazon. O tutorial explora em profundidade o mundo do web scraping, com foco em técnicas que permitirão reunir informações valiosas de diversas páginas da Amazon de maneira eficiente e eficaz.
Ao longo do tutorial, o apresentador demonstra o uso de ferramentas e bibliotecas essenciais, como Python, BeautifulSoup e requests, além de destacar as práticas recomendadas para evitar ser bloqueado ou detectado pelos mecanismos antibot da Amazon. O vídeo aborda tópicos essenciais, como lidar com a paginação, gerenciar limites de taxa e imitar um comportamento de navegação semelhante ao humano.
Além das instruções passo a passo apresentadas no vídeo, o tutorial também compartilha dicas e truques úteis para otimizar sua experiência de web scraping. Entre eles estão o uso de proxies para contornar restrições de IP, a aleatorização do User-Agent e dos cabeçalhos das solicitações e a implementação de um tratamento adequado de erros para garantir um processo de extração de dados tranquilo e ininterrupto.
Scraping da Amazon: Perguntas frequentes
Quando se trata de extrair dados da Amazon, uma plataforma popular de comércio eletrônico, há certas coisas que é preciso ter em mente. Vamos conferir as perguntas frequentes relacionadas à extração de dados da Amazon.
1. É legal fazer scraping da Amazon?
Fazer scraping de dados disponíveis publicamente na internet é legal, e isso inclui fazer scraping da Amazon. Você pode extrair legalmente informações como detalhes de produtos, descrições, avaliações e preços. No entanto, ao fazer scraping de avaliações de produtos, é preciso ter cuidado com dados pessoais e direitos autorais. Por exemplo, o nome e o avatar de quem fez a avaliação podem constituir dados pessoais, enquanto o texto da avaliação pode estar protegido por direitos autorais. Sempre tenha cautela e procure aconselhamento jurídico ao extrair esse tipo de dado.
2. A Amazon permite scraping?
Embora seja legal fazer scraping de dados disponíveis publicamente, a Amazon às vezes toma medidas para impedir essa prática. Essas medidas incluem limitar a taxa de solicitações, banir endereços IP e usar a impressão digital do navegador para detectar bots de scraping. A Amazon geralmente bloqueia o web scraping com um código de resposta de sucesso 200 OK e exige que você resolva um CAPTCHA ou exibe uma mensagem HTTP Error 503 Service Unavailable, orientando você a entrar em contato com a equipe de vendas para obter uma API paga.
Há maneiras de contornar essas medidas, mas fazer web scraping de forma ética pode ajudar a evitar acioná-las desde o início. O web scraping ético envolve limitar a frequência das solicitações, usar agentes de usuário adequados e evitar scraping excessivo que possa afetar o desempenho do site. Ao fazer scraping de forma ética, você pode reduzir o risco de ser banido ou enfrentar consequências legais, enquanto ainda extrai dados úteis da Amazon.
3. É ético fazer scraping dos dados da Amazon?
Fazer scraping de forma ética envolve respeitar o site de destino. Embora seja improvável que você sobrecarregue o site da Amazon com solicitações demais, ainda assim deve seguir as diretrizes de scraping ético. O scraping ético pode minimizar o risco de enfrentar problemas legais ou medidas anti-scraping.
4. Como posso evitar ser banido ao fazer scraping da Amazon?
Para evitar ser banido ao fazer scraping da Amazon, limite a taxa de solicitações, evite fazer scraping nos horários de pico, use rotação inteligente de proxies e utilize agentes de usuário e cabeçalhos adequados para não ser detectado. Além disso, extraia apenas os dados necessários e use ferramentas ou bibliotecas de scraping de terceiros.
5. Quais são os riscos de fazer scraping da Amazon?
Fazer scraping dos dados da Amazon envolve riscos potenciais, como ações judiciais e suspensão da conta. A Amazon usa medidas anti-bot para detectar e impedir o scraping, incluindo banimentos de endereços IP, limitação de taxa e impressão digital do navegador. No entanto, ao fazer scraping de forma ética, você pode atenuar esses riscos.
Conclusão
Ao emergirmos do fascinante labirinto do web scraping da Amazon, é hora de parar um momento para apreciar o conhecimento e as habilidades inestimáveis que adquirimos nesta jornada empolgante. Com a ProxyCompass como seu guia de confiança, você percorreu com sucesso as reviravoltas da extração de dados valiosos desse gigante do varejo. Ao seguir em frente, usando com maestria os conhecimentos recém-adquiridos, lembre-se de que a selva digital nunca para de evoluir.
Mantenha a curiosidade, continue afiando seu facão de web scraping e siga conquistando o cenário em constante transformação da extração de dados. Até nossa próxima expedição ousada, explorador intrépido, que suas jornadas orientadas por dados sejam frutíferas e gratificantes!