ลองจินตนาการว่าคุณเป็นนักสำรวจผู้รักการผจญภัย กำลังมุ่งหน้าสู่ดินแดนอันกว้างใหญ่และลึกลับของ Amazon ไม่ใช่ป่าฝน แต่เป็นยักษ์ใหญ่แห่งวงการค้าปลีกออนไลน์ ทุกครั้งที่คลิก คุณจะค้นพบขุมทรัพย์ล้ำค่า และดำดิ่งลึกลงไปในดินแดนแห่งข้อมูลที่ยังไม่มีใครสำรวจ
ในการเดินทางสำรวจอันน่าตื่นเต้นนี้ เราจะนำเสนอคู่มือทีละขั้นตอนเพื่อช่วยคุณสำรวจป่าดิจิทัลอันหนาทึบของการดึงข้อมูลจากเว็บไซต์ Amazon เตรียมตัวออกเดินทางที่ไม่เหมือนใคร พร้อมเคล็ดลับและเทคนิคจากผู้เชี่ยวชาญเพื่อดึงข้อมูลอันมีค่าได้อย่างแม่นยำไร้ที่เปรียบ
สารบัญ
- ข้อมูลใดบ้างที่ควรดึงจาก Amazon
- ข้อกำหนดพื้นฐานบางประการ
- การเตรียมการดึงข้อมูล
- การดึงข้อมูลสินค้าจาก Amazon
- วิธีดึงข้อมูลจากหลายหน้าบน Amazon
- การดึงข้อมูลจาก Amazon: คำถามที่พบบ่อย
- สรุป
เอาละ รวบรวมความกล้า สวมรองเท้าบูตเสมือนจริง แล้วมาเริ่มการผจญภัยที่ขับเคลื่อนด้วยข้อมูลไปด้วยกัน!
ข้อมูลใดบ้างที่ควรดึงจาก Amazon
สินค้าบน Amazon มีจุดข้อมูลมากมาย แต่สิ่งสำคัญที่ควรให้ความสำคัญเมื่อดึงข้อมูล ได้แก่:
- ชื่อสินค้า
- ราคา
- ส่วนลด (ถ้ามี)
- สรุปสินค้า
- รายการคุณสมบัติที่เกี่ยวข้อง (ถ้ามี)
- คะแนนรีวิว
- รูปภาพสินค้า
แม้ว่าสิ่งเหล่านี้จะเป็นประเด็นหลักที่ควรพิจารณาเมื่อดึงข้อมูลสินค้าจาก Amazon แต่สิ่งสำคัญคือต้องทราบว่าข้อมูลที่คุณดึงออกมาอาจแตกต่างกันไปตามวัตถุประสงค์เฉพาะของคุณ
ข้อกำหนดพื้นฐานบางประการ
การทำซุปต้องใช้ส่วนผสมที่เหมาะสม เช่นเดียวกัน เครื่องมือดึงข้อมูลเว็บตัวใหม่ของเราก็ต้องใช้ส่วนประกอบเฉพาะเช่นกัน
- Python — ใช้งานง่ายและมีคลังไลบรารีมากมาย จึงทำให้ Python เป็นตัวเลือกอันดับต้น ๆ สำหรับการดึงข้อมูลเว็บ หากยังไม่ได้ติดตั้ง โปรดดูคู่มือนี้
- BeautifulSoup — นี่เป็นหนึ่งในไลบรารีดึงข้อมูลเว็บมากมายที่มีให้ใช้กับ Python ด้วยความเรียบง่ายและวิธีใช้งานที่ไม่ซับซ้อน จึงเป็นตัวเลือกยอดนิยมสำหรับการดึงข้อมูลเว็บ หลังจากติดตั้ง Python สำเร็จแล้ว คุณสามารถติดตั้ง Beautiful Soup ได้โดยเรียกใช้: pip install bs4
- ความเข้าใจพื้นฐานเกี่ยวกับแท็ก HTML — ดูบทช่วยสอนนี้เพื่อเรียนรู้ความรู้ที่จำเป็นเกี่ยวกับแท็ก HTML
- เว็บเบราว์เซอร์ — เนื่องจากเราต้องกรองข้อมูลที่ไม่เกี่ยวข้องจำนวนมากออกจากเว็บไซต์ จึงจำเป็นต้องใช้ id และแท็กเฉพาะสำหรับการกรอง เว็บเบราว์เซอร์อย่าง Google Chrome หรือ Mozilla Firefox มีประโยชน์ในการระบุแท็กเหล่านั้น
การเตรียมพร้อมสำหรับการดึงข้อมูล
ก่อนอื่น ตรวจสอบให้แน่ใจว่าคุณติดตั้ง Python แล้ว หากคุณยังไม่มี Python 3.8 หรือใหม่กว่า ให้ไปที่ python.org เพื่อดาวน์โหลดและติดตั้งเวอร์ชันล่าสุด
จากนั้นสร้างไดเรกทอรีสำหรับจัดเก็บไฟล์โค้ดดึงข้อมูลจากเว็บของ Amazon โดยทั่วไปแล้ว การตั้งค่าสภาพแวดล้อมเสมือนสำหรับโปรเจกต์ของคุณเป็นแนวทางที่ดี
ใช้คำสั่งต่อไปนี้เพื่อสร้างและเปิดใช้งานสภาพแวดล้อมเสมือนบน macOS และ Linux:
$ python3 -m venv .env $ source .env/bin/activateสำหรับผู้ใช้ Windows คำสั่งจะแตกต่างออกไปเล็กน้อย:
d:amazon>python -m venv .env d:amazon>.envscriptsactivateตอนนี้ได้เวลาติดตั้งแพ็กเกจ Python ที่จำเป็นแล้ว
คุณจะต้องใช้แพ็กเกจสำหรับงานหลักสองอย่าง ได้แก่ การดึง HTML และการแยกวิเคราะห์เพื่อดึงข้อมูลที่เกี่ยวข้องออกมา
Requests เป็นไลบรารี Python ของบุคคลที่สามที่มีผู้ใช้กันอย่างแพร่หลาย สำหรับส่งคำขอ HTTP โดยมีอินเทอร์เฟซที่ตรงไปตรงมาและใช้งานง่ายสำหรับส่งคำขอ HTTP ไปยังเว็บเซิร์ฟเวอร์และรับการตอบกลับ นับเป็นไลบรารีสำหรับดึงข้อมูลจากเว็บที่รู้จักกันดีที่สุด
อย่างไรก็ตาม ไลบรารี Requests มีข้อจำกัดอย่างหนึ่ง คือส่งคืนการตอบกลับ HTML ในรูปแบบสตริง ซึ่งอาจทำให้ค้นหาองค์ประกอบเฉพาะ เช่น ราคาสินค้าในรายการ ได้ยากเมื่อเขียนโค้ดดึงข้อมูลจากเว็บ
นี่คือจุดที่ Beautiful Soup เข้ามาช่วย Beautiful Soup เป็นไลบรารี Python ที่ออกแบบมาสำหรับดึงข้อมูลจากเว็บ โดยดึงข้อมูลจากไฟล์ HTML และ XML ช่วยให้คุณค้นหาข้อมูลจากหน้าเว็บได้ด้วยการค้นหาแท็ก แอตทริบิวต์ หรือข้อความที่ระบุ
ติดตั้งไลบรารีทั้งสองรายการได้ด้วยคำสั่งต่อไปนี้:
$ python3 -m pip install requests beautifulsoup4สำหรับผู้ใช้ Windows ให้เปลี่ยน ‘python3’ เป็น ‘python’ โดยคงส่วนที่เหลือของคำสั่งไว้เหมือนเดิม:
d:amazon>python -m pip install requests beautifulsoup4โปรดทราบว่าเรากำลังติดตั้งไลบรารี Beautiful Soup เวอร์ชัน 4
ต่อไป มาทดสอบไลบรารี Requests สำหรับดึงข้อมูลกัน สร้างไฟล์ใหม่ชื่อ amazon.py แล้วป้อนโค้ดต่อไปนี้:
import requests url = ' https://www.amazon.com/Bose-QuietComfort-45-Bluetooth-Canceling-Headphones/dp/B098FKXT8L' response = requests.get(url) print(response.text)บันทึกไฟล์แล้วเรียกใช้จากเทอร์มินัล
$ python3 amazon.pyในกรณีส่วนใหญ่ คุณจะไม่สามารถดู HTML ที่ต้องการได้ Amazon จะบล็อกคำขอ และคุณจะได้รับการตอบกลับดังต่อไปนี้:
หากต้องการสอบถามเกี่ยวกับการเข้าถึงข้อมูล Amazon โดยอัตโนมัติ โปรดติดต่อ [email protected].หากคุณพิมพ์ response.status_code จะเห็นว่าได้รับข้อผิดพลาด 503 แทนรหัสสำเร็จ 200
Amazon ทราบว่าคำขอนี้ไม่ได้มาจากเบราว์เซอร์ จึงบล็อกคำขอ แนวทางนี้พบได้ทั่วไปในเว็บไซต์หลายแห่ง Amazon อาจบล็อกคำขอของคุณและส่งคืนรหัสข้อผิดพลาดที่ขึ้นต้นด้วย 500 หรือบางครั้งก็ขึ้นต้นด้วย 400
วิธีแก้ปัญหาอย่างง่ายคือส่งส่วนหัวไปพร้อมกับคำขอ โดยเลียนแบบส่วนหัวที่เบราว์เซอร์ส่ง
บางครั้ง การส่งเพียง user-agent ก็เพียงพอแล้ว แต่บางครั้งคุณอาจต้องส่งส่วนหัวเพิ่มเติม เช่น accept-language
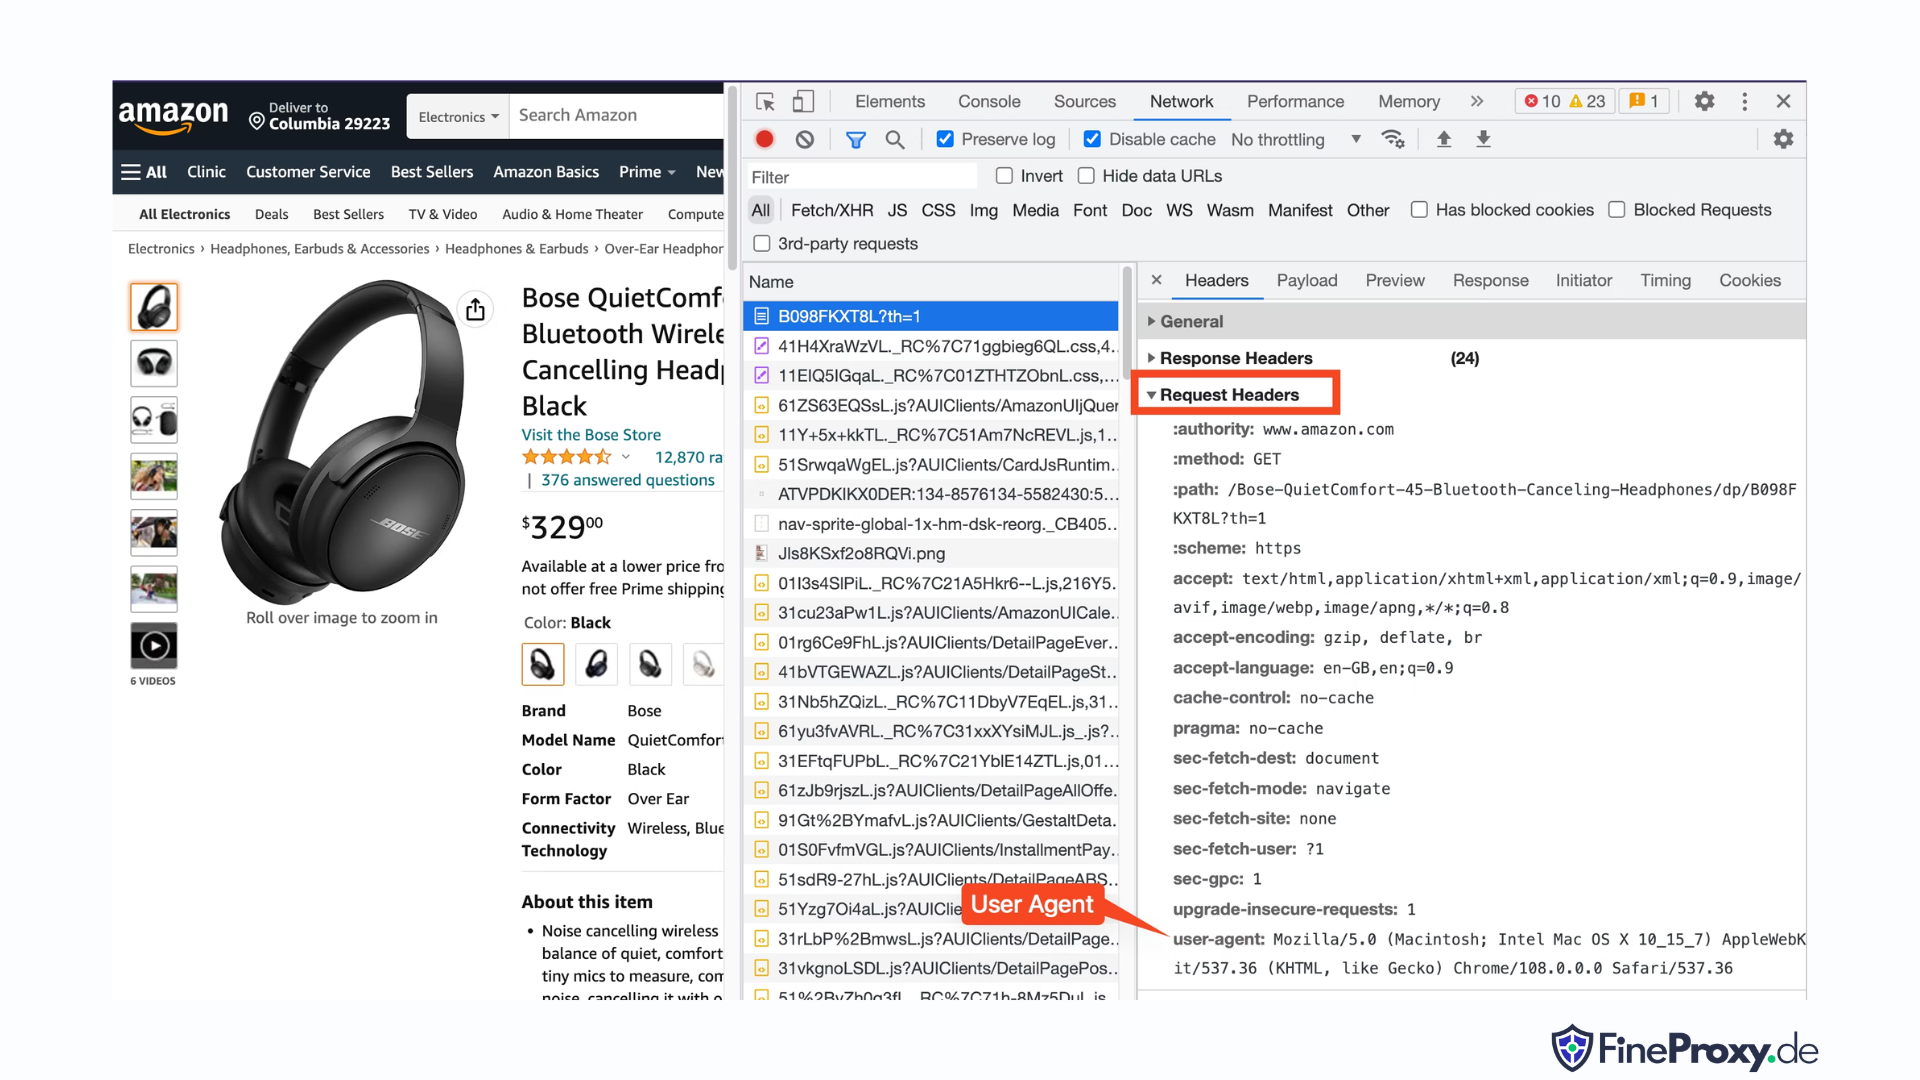
หากต้องการค้นหา user-agent ที่เบราว์เซอร์ของคุณส่ง ให้กด F12 เปิดแท็บ Network แล้วโหลดหน้าเว็บอีกครั้ง เลือกคำขอแรกและตรวจสอบ Request Headers
คัดลอก user-agent นี้แล้วสร้างพจนานุกรมสำหรับส่วนหัว เช่น ตัวอย่างนี้ที่มีส่วนหัว user-agent และ accept-language:
custom_headers = { ' user-agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/108.0.0.0 Safari/537.36', 'accept-language': 'en-GB,en;q=0.9', }จากนั้นคุณสามารถส่งพจนานุกรมนี้เป็นพารามิเตอร์เสริมในเมธอด get ได้:
response = requests.get(url, headers=custom_headersการดึงข้อมูลผลิตภัณฑ์จาก Amazon
ในกระบวนการดึงข้อมูลผลิตภัณฑ์จาก Amazon ผ่านเว็บ โดยทั่วไปคุณจะต้องใช้งานหน้าสองประเภท ได้แก่ หน้าหมวดหมู่และหน้ารายละเอียดผลิตภัณฑ์
ตัวอย่างเช่น ไปที่ https://www.amazon.com/b?node=12097479011 หรือค้นหาหูฟังแบบครอบหูบน Amazon หน้าที่แสดงผลการค้นหาเรียกว่าหน้าหมวดหมู่
หน้าหมวดหมู่จะแสดงชื่อผลิตภัณฑ์ รูปภาพผลิตภัณฑ์ คะแนนผลิตภัณฑ์ ราคา และที่สำคัญที่สุดคือ URL ของผลิตภัณฑ์ หากต้องการเข้าถึงข้อมูลเพิ่มเติม เช่น คำอธิบายผลิตภัณฑ์ คุณต้องไปที่หน้ารายละเอียดผลิตภัณฑ์
มาวิเคราะห์โครงสร้างของหน้ารายละเอียดผลิตภัณฑ์กัน
เปิด URL ของผลิตภัณฑ์ เช่น https://www.amazon.com/Bose-QuietComfort-45-Bluetooth-Canceling-Headphones/dp/B098FKXT8L ด้วย Chrome หรือเบราว์เซอร์สมัยใหม่อื่นๆ คลิกขวาที่ชื่อผลิตภัณฑ์แล้วเลือก Inspect มาร์กอัป HTML ของชื่อผลิตภัณฑ์จะถูกไฮไลต์
คุณจะเห็นว่าเป็นแท็ก span ซึ่งมีแอตทริบิวต์ id ตั้งค่าเป็น “productTitle”
เช่นเดียวกัน คลิกขวาที่ราคาแล้วเลือก Inspect เพื่อดูมาร์กอัป HTML ของราคา
ส่วนดอลลาร์ของราคาอยู่ในแท็ก span ที่มีคลาส “a-price-whole” ส่วนเซนต์อยู่ในแท็ก span อีกอันที่มีคลาส “a-price-fraction”
คุณสามารถค้นหาคะแนน รูปภาพ และคำอธิบายได้ด้วยวิธีเดียวกัน
เมื่อรวบรวมข้อมูลเหล่านี้แล้ว ให้เพิ่มบรรทัดต่อไปนี้ลงในโค้ดที่มีอยู่:
response = requests.get(url, headers=custom_headers) soup = BeautifulSoup(response.text, 'lxml')Beautiful Soup มีวิธีเลือกแท็กโดยใช้เมธอด find โดยเฉพาะ และยังรองรับ CSS selector เป็นอีกทางเลือกหนึ่งด้วย คุณสามารถใช้วิธีใดก็ได้เพื่อให้ได้ผลลัพธ์เดียวกัน ในบทช่วยสอนนี้ เราจะใช้ CSS selector ซึ่งเป็นวิธีทั่วไปสำหรับเลือกองค์ประกอบ CSS selector ใช้ได้กับเครื่องมือดึงข้อมูลเว็บเกือบทั้งหมดเพื่อดึงข้อมูลผลิตภัณฑ์จาก Amazon
ตอนนี้คุณก็พร้อมใช้วัตถุ Soup เพื่อค้นหาข้อมูลที่ต้องการแล้ว
การดึงชื่อผลิตภัณฑ์
ชื่อผลิตภัณฑ์หรือชื่อเรื่องอยู่ในองค์ประกอบ span ที่มี id เป็น ‘productTitle’ การเลือกองค์ประกอบโดยใช้ id ที่ไม่ซ้ำกันทำได้ง่าย
พิจารณาโค้ดต่อไปนี้เป็นตัวอย่าง:
title_element = soup.select_one('#productTitle')เราส่ง CSS selector ไปยังเมธอด select_one ซึ่งจะส่งคืนอินสแตนซ์ขององค์ประกอบ
หากต้องการดึงข้อมูลจากข้อความ ให้ใช้แอตทริบิวต์ text
title = title_element.textเมื่อพิมพ์ออกมา คุณอาจสังเกตเห็นช่องว่างหลายตำแหน่ง หากต้องการแก้ไข ให้เพิ่มการเรียกใช้ฟังก์ชัน .strip() ดังนี้:
title = title_element.text.strip()การดึงคะแนนผลิตภัณฑ์
การดึงคะแนนผลิตภัณฑ์จาก Amazon ต้องใช้ความพยายามเพิ่มเติมเล็กน้อย
ขั้นแรก กำหนด selector สำหรับคะแนน:
#acrPopoverจากนั้น ใช้คำสั่งต่อไปนี้เพื่อเลือกองค์ประกอบที่มีคะแนน:
rating_element = soup.select_one('#acrPopover')โปรดทราบว่าค่าคะแนนจริงอยู่ในแอตทริบิวต์ title:
rating_text = rating_element.attrs.get('title') print(rating_text) # prints '4.6 out of 5 stars'สุดท้าย ใช้เมธอด replace เพื่อรับคะแนนที่เป็นตัวเลข:
rating = rating_text.replace('out of 5 stars', '')การดึงราคาผลิตภัณฑ์
ราคาผลิตภัณฑ์พบได้สองตำแหน่ง ได้แก่ ด้านล่างชื่อผลิตภัณฑ์และในกล่อง Buy Now
คุณสามารถใช้แท็กใดแท็กหนึ่งเหล่านี้เพื่อดึงราคาผลิตภัณฑ์จาก Amazon
สร้าง CSS selector สำหรับราคา:
#price_inside_buyboxส่ง CSS selector นี้ไปยังเมธอด select_one ของ BeautifulSoup ดังนี้:
price_element = soup.select_one('#price_inside_buybox')ตอนนี้คุณสามารถพิมพ์ราคาได้:
print(price_element.text)การดึงรูปภาพ
หากต้องการดึงรูปภาพเริ่มต้น ให้ใช้ CSS selector #landingImage จากข้อมูลนี้ คุณสามารถเขียนบรรทัดโค้ดต่อไปนี้เพื่อรับ URL ของรูปภาพจากแอตทริบิวต์ src:
image_element = soup.select_one('#landingImage') image = image_element.attrs.get('src')การดึงคำอธิบายผลิตภัณฑ์
ขั้นตอนถัดไปในการดึงข้อมูลผลิตภัณฑ์จาก Amazon คือการดึงคำอธิบายผลิตภัณฑ์
ขั้นตอนยังคงเหมือนเดิม คือสร้าง CSS selector แล้วใช้เมธอด select_one
CSS selector สำหรับคำอธิบายคือ:
#productDescriptionวิธีนี้ช่วยให้เราดึงองค์ประกอบได้ดังนี้:
description_element = soup.select_one('#productDescription') print(description_element.text)การจัดการรายการผลิตภัณฑ์
เราได้สำรวจวิธีดึงข้อมูลผลิตภัณฑ์แล้ว แต่คุณจะต้องเริ่มจากหน้ารายการผลิตภัณฑ์หรือหน้าหมวดหมู่เพื่อเข้าถึงข้อมูลผลิตภัณฑ์
ตัวอย่างเช่น https://www.amazon.com/b?node=12097479011 คือหน้าหมวดหมู่สำหรับหูฟังแบบครอบหู
หากตรวจสอบหน้านี้ คุณจะเห็นว่าผลิตภัณฑ์ทั้งหมดอยู่ภายใน div ที่มีแอตทริบิวต์ [data-asin] ซึ่งไม่ซ้ำกัน ภายใน div นั้น ลิงก์ผลิตภัณฑ์ทั้งหมดอยู่ในแท็ก h2
จากข้อมูลนี้ CSS Selector คือ:
[data-asin] h2 aคุณสามารถอ่านแอตทริบิวต์ href ของ selector นี้แล้วเรียกใช้ลูป อย่างไรก็ตาม โปรดจำไว้ว่าลิงก์จะเป็นแบบสัมพัทธ์ คุณจะต้องใช้เมธอด urljoin เพื่อแยกวิเคราะห์ลิงก์เหล่านี้
from urllib.parse import urljoin ... def parse_listing(listing_url): … link_elements = soup_search.select("[data-asin] h2 a") page_data = [] for link in link_elements: full_url = urljoin(search_url, link.attrs.get("href")) product_info = get_product_info(full_url) page_data.append(product_info)การจัดการการแบ่งหน้า
ลิงก์ไปยังหน้าถัดไปอยู่ในลิงก์ที่มีข้อความ “Next” คุณสามารถค้นหาลิงก์นี้โดยใช้ตัวดำเนินการ contains ของ CSS ได้ดังนี้:
next_page_el = soup.select_one('a:contains("Next")') if next_page_el: next_page_url = next_page_el.attrs.get('href') next_page_url = urljoin(listing_url, next_page_url)การส่งออกข้อมูล Amazon
ข้อมูลที่ดึงมาจะถูกส่งคืนเป็นพจนานุกรมโดยตั้งใจ คุณสามารถสร้างรายการที่มีผลิตภัณฑ์ทั้งหมดที่ดึงมาได้
def parse_listing(listing_url): ... page_data = [] for link in link_elements: ... product_info = get_product_info(full_url) page_data.append(product_info)จากนั้นคุณสามารถใช้ page_data เพื่อสร้างออบเจ็กต์ Pandas DataFrame:
df = pd.DataFrame(page_data) df.to_csv('headphones.csv', index = False)วิธีดึงข้อมูลจากหลายหน้าบน Amazon
การดึงข้อมูลจากหลายหน้าบน Amazon ช่วยเพิ่มประสิทธิภาพให้กับโปรเจกต์การดึงข้อมูลจากเว็บไซต์ของคุณได้ ด้วยการมอบชุดข้อมูลที่ครอบคลุมยิ่งขึ้นสำหรับนำไปวิเคราะห์ เมื่อต้องดึงข้อมูลจากหลายหน้า คุณจะต้องพิจารณาการแบ่งหน้า ซึ่งเป็นกระบวนการแบ่งเนื้อหาออกเป็นหลายหน้า
ต่อไปนี้คือ 6 ประเด็นสำคัญที่ควรคำนึงถึง เมื่อต้องดึงข้อมูลจากหลายหน้าบน Amazon:
- ระบุรูปแบบการแบ่งหน้า: ขั้นแรก ให้วิเคราะห์โครงสร้าง URL ของหมวดหมู่หรือหน้าผลการค้นหา เพื่อทำความเข้าใจว่า Amazon แบ่งหน้าเนื้อหาอย่างไร ซึ่งอาจเป็นพารามิเตอร์การค้นหา (เช่น “?page=2”) หรือตัวระบุเฉพาะที่ฝังอยู่ใน URL
- ดึงลิงก์หน้า “ถัดไป”: ค้นหาองค์ประกอบ (โดยปกติคือแท็ก anchor) ที่มีลิงก์ไปยังหน้าถัดไป ใช้ CSS selector หรือเมธอดของ Beautiful Soup ที่เหมาะสมเพื่อดึงแอตทริบิวต์ href ขององค์ประกอบนี้ ซึ่งเป็น URL สำหรับหน้าถัดไป
- แปลง URL แบบสัมพัทธ์เป็น URL แบบสัมบูรณ์: เนื่องจาก URL ที่ดึงมาอาจเป็น URL แบบสัมพัทธ์ ให้ใช้ฟังก์ชัน
urljoinจากไลบรารีurllib.parseเพื่อแปลงเป็น URL แบบสัมบูรณ์ - สร้างลูป: เขียนลูปเพื่อวนผ่านแต่ละหน้าและดึงข้อมูลที่ต้องการจากหน้าเหล่านั้น ลูปควรทำงานต่อไปจนกว่าจะไม่มีหน้าเหลือ โดยตรวจสอบได้จากการดูว่ามีลิงก์หน้า “ถัดไป” อยู่ในหน้าปัจจุบันหรือไม่
- เพิ่มช่วงหน่วงระหว่างคำขอ: เพื่อไม่ให้เซิร์ฟเวอร์ของ Amazon ทำงานหนักเกินไปหรือกระตุ้นมาตรการป้องกันบอต ให้เพิ่มช่วงหน่วงระหว่างคำขอด้วยฟังก์ชัน
time.sleep()จากไลบรารีtimeปรับระยะเวลาหน่วงให้เลียนแบบพฤติกรรมการท่องเว็บของมนุษย์ - การจัดการ CAPTCHA และการบล็อก: หากพบ CAPTCHA หรือถูกบล็อก IP ขณะดึงข้อมูลจากหลายหน้า ให้พิจารณาใช้พร็อกซีเพื่อสลับที่อยู่ IP หรือใช้เครื่องมือและบริการดึงข้อมูลโดยเฉพาะที่จัดการปัญหาเหล่านี้ได้โดยอัตโนมัติ
ด้านล่างนี้ คุณจะพบวิดีโอสอนจาก YouTube ที่ครอบคลุมและแนะนำขั้นตอนการดึงข้อมูลจากหลายหน้าบนเว็บไซต์ของ Amazon บทช่วยสอนนี้เจาะลึกเรื่องการดึงข้อมูลจากเว็บไซต์ โดยมุ่งเน้นเทคนิคที่จะช่วยให้คุณรวบรวมข้อมูลที่มีประโยชน์จากหน้า Amazon จำนวนมากได้อย่างมีประสิทธิภาพและรวดเร็ว
ตลอดบทช่วยสอน ผู้บรรยายสาธิตการใช้เครื่องมือและไลบรารีที่จำเป็น เช่น Python, BeautifulSoup และ requests พร้อมเน้นแนวทางปฏิบัติที่ดีที่สุดเพื่อหลีกเลี่ยงการถูก Amazon บล็อกหรือตรวจจับโดยกลไกป้องกันบอต วิดีโอนี้ครอบคลุมหัวข้อสำคัญ เช่น การจัดการการแบ่งหน้า การควบคุมอัตราการส่งคำขอ และการเลียนแบบพฤติกรรมการท่องเว็บของมนุษย์
นอกจากคำแนะนำทีละขั้นตอนในวิดีโอแล้ว บทช่วยสอนยังแชร์เคล็ดลับที่เป็นประโยชน์เพื่อเพิ่มประสิทธิภาพประสบการณ์การดึงข้อมูลจากเว็บไซต์ของคุณอีกด้วย ซึ่งรวมถึงการใช้พร็อกซีเพื่อหลีกเลี่ยงข้อจำกัดด้าน IP การสุ่ม User-Agent และส่วนหัวของคำขอ รวมถึงการจัดการข้อผิดพลาดอย่างเหมาะสมเพื่อให้กระบวนการดึงข้อมูลดำเนินไปได้อย่างราบรื่นและไม่หยุดชะงัก
การดึงข้อมูลจาก Amazon: คำถามที่พบบ่อย
เมื่อพูดถึงการดึงข้อมูลจาก Amazon ซึ่งเป็นแพลตฟอร์มอีคอมเมิร์ซยอดนิยม มีบางสิ่งที่ควรคำนึงถึง มาดูคำถามที่พบบ่อยเกี่ยวกับการดึงข้อมูลจาก Amazon กัน
1. การดึงข้อมูลจาก Amazon ถูกกฎหมายหรือไม่?
การดึงข้อมูลที่เปิดเผยต่อสาธารณะจากอินเทอร์เน็ตเป็นสิ่งที่ถูกกฎหมาย ซึ่งรวมถึงการดึงข้อมูลจาก Amazon ด้วย คุณสามารถดึงข้อมูลต่าง ๆ เช่น รายละเอียดสินค้า คำอธิบาย คะแนน และราคาได้อย่างถูกกฎหมาย อย่างไรก็ตาม เมื่อต้องดึงรีวิวสินค้า คุณควรระมัดระวังเรื่องข้อมูลส่วนบุคคลและการคุ้มครองลิขสิทธิ์ ตัวอย่างเช่น ชื่อและรูปประจำตัวของผู้รีวิวอาจถือเป็นข้อมูลส่วนบุคคล ขณะที่ข้อความรีวิวอาจได้รับความคุ้มครองด้านลิขสิทธิ์ โปรดใช้ความระมัดระวังอยู่เสมอและขอคำแนะนำทางกฎหมายเมื่อดึงข้อมูลดังกล่าว
2. Amazon อนุญาตให้ดึงข้อมูลหรือไม่?
แม้ว่าการดึงข้อมูลที่เปิดเผยต่อสาธารณะจะถูกกฎหมาย แต่บางครั้ง Amazon ก็ใช้มาตรการป้องกันการดึงข้อมูล มาตรการเหล่านี้ได้แก่ การจำกัดอัตราการส่งคำขอ การแบนที่อยู่ IP และการใช้ลายนิ้วมือเบราว์เซอร์เพื่อตรวจจับบอตดึงข้อมูล โดยปกติแล้ว Amazon จะบล็อกการดึงข้อมูลจากเว็บด้วยรหัสสถานะการตอบกลับ 200 OK ซึ่งแสดงว่าดำเนินการสำเร็จ และกำหนดให้คุณต้องผ่าน CAPTCHA หรือแสดงข้อความ HTTP Error 503 Service Unavailable เพื่อให้ติดต่อฝ่ายขายเกี่ยวกับ API แบบชำระเงิน
มีวิธีหลีกเลี่ยงมาตรการเหล่านี้ แต่การดึงข้อมูลจากเว็บอย่างมีจริยธรรมจะช่วยป้องกันไม่ให้มาตรการดังกล่าวทำงานตั้งแต่แรก การดึงข้อมูลจากเว็บอย่างมีจริยธรรมเกี่ยวข้องกับการจำกัดความถี่ของคำขอ การใช้ user agent ที่เหมาะสม และการหลีกเลี่ยงการดึงข้อมูลมากเกินไปจนส่งผลต่อประสิทธิภาพของเว็บไซต์ การดึงข้อมูลอย่างมีจริยธรรมจะช่วยลดความเสี่ยงในการถูกแบนหรือเผชิญผลทางกฎหมาย ขณะเดียวกันก็ยังสามารถดึงข้อมูลที่เป็นประโยชน์จาก Amazon ได้
3. การดึงข้อมูลจาก Amazon อย่างมีจริยธรรมหรือไม่?
การดึงข้อมูลอย่างมีจริยธรรมหมายถึงการเคารพเว็บไซต์เป้าหมาย แม้คุณไม่น่าจะทำให้เว็บไซต์ Amazon ทำงานหนักเกินไปด้วยการส่งคำขอมากเกินไป แต่ก็ควรปฏิบัติตามแนวทางการดึงข้อมูลอย่างมีจริยธรรม การดึงข้อมูลอย่างมีจริยธรรมช่วยลดความเสี่ยงที่จะเผชิญปัญหาทางกฎหมายหรือต้องรับมือกับมาตรการป้องกันการดึงข้อมูล
4. ฉันจะหลีกเลี่ยงการถูกแบนขณะดึงข้อมูลจาก Amazon ได้อย่างไร?
หากต้องการหลีกเลี่ยงการถูกแบนขณะดึงข้อมูลจาก Amazon คุณควรจำกัดอัตราการส่งคำขอ หลีกเลี่ยงการดึงข้อมูลในช่วงเวลาที่มีผู้ใช้งานสูงสุด ใช้การหมุนเวียนพร็อกซีอัจฉริยะ และใช้ user agent กับเฮดเดอร์ที่เหมาะสมเพื่อหลีกเลี่ยงการตรวจจับ นอกจากนี้ ให้ดึงเฉพาะข้อมูลที่จำเป็น และใช้เครื่องมือหรือไลบรารีสำหรับการดึงข้อมูลจากบุคคลที่สาม
5. การดึงข้อมูลจาก Amazon มีความเสี่ยงอะไรบ้าง?
การดึงข้อมูลจาก Amazon มีความเสี่ยงที่อาจเกิดขึ้น เช่น การถูกดำเนินคดีทางกฎหมายและการระงับบัญชี Amazon ใช้มาตรการป้องกันบอตเพื่อตรวจจับและป้องกันการดึงข้อมูล ซึ่งรวมถึงการแบนที่อยู่ IP การจำกัดอัตราการส่งคำขอ และการตรวจสอบลายนิ้วมือเบราว์เซอร์ อย่างไรก็ตาม คุณสามารถลดความเสี่ยงเหล่านี้ได้ด้วยการดึงข้อมูลอย่างมีจริยธรรม
สรุป
เมื่อเราเดินทางออกจากเขาวงกตอันน่าตื่นตาตื่นใจของการดึงข้อมูลจากเว็บ Amazon ก็ถึงเวลาหยุดสักครู่เพื่อชื่นชมความรู้และทักษะอันล้ำค่าที่เราได้สั่งสมมาตลอดการเดินทางอันเร้าใจนี้ โดยมี ProxyCompass เป็นผู้นำทางที่คุณไว้วางใจ คุณได้ฝ่าฟันเส้นทางคดเคี้ยวเพื่อดึงข้อมูลล้ำค่าจากยักษ์ใหญ่แห่งวงการค้าปลีกได้สำเร็จ เมื่อออกเดินทางต่อไปพร้อมนำความเชี่ยวชาญใหม่ที่ได้มาไปใช้อย่างชำนาญ โปรดจำไว้ว่าป่าดิจิทัลยังคงเปลี่ยนแปลงอยู่เสมอ
จงอยากรู้อยากเห็นต่อไป ลับมีดพร้าสำหรับการดึงข้อมูลจากเว็บให้คมอยู่เสมอ และเดินหน้าพิชิตภูมิทัศน์การดึงข้อมูลที่เปลี่ยนแปลงอยู่ตลอดเวลา จนกว่าจะถึงการผจญภัยครั้งต่อไป นักสำรวจผู้กล้าหาญ ขอให้ภารกิจขับเคลื่อนด้วยข้อมูลของคุณประสบผลสำเร็จและคุ้มค่า!