
冒険好きな探検家になったつもりで、広大で謎に満ちたAmazonの世界へと飛び込んでみましょう。熱帯雨林ではなく、オンライン小売業界の巨大企業です。クリックするたびに貴重な宝物を見つけ、データという未踏の領域をさらに深く探っていきます。
このスリリングな探検に向けて、Amazonのウェブスクレイピングというデジタルの密林を進むためのステップごとのガイドをご紹介します。専門家ならではのヒントやコツを駆使し、比類のない精度で貴重な情報を抽出する、ほかでは味わえない旅に出かける準備をしましょう。
目次
- Amazonからスクレイピングするデータ
- 基本的な要件
- スクレイピングの準備
- Amazonの商品情報のスクレイピング
- Amazonで複数のページをスクレイピングする方法
- Amazonのスクレイピング:よくある質問
- まとめ
さあ、勇気を出して、仮想のブーツを履き、データ主導の冒険を一緒に始めましょう!
Amazonからスクレイピングするデータ
Amazonの商品にはさまざまなデータ項目がありますが、スクレイピングの際に注目すべき主な要素は次のとおりです。
- 商品タイトル
- 価格
- 割引額(該当する場合)
- 商品概要
- 関連する機能の一覧(利用可能な場合)
- レビュー評価
- 商品画像
これらはAmazonの商品をスクレイピングする際に考慮すべき主な項目ですが、抽出する情報は具体的な目的によって異なる場合があることに注意してください。
基本的な要件
スープを作るには、適切な材料が必要です。同様に、新しいウェブスクレイパーにも特定の要素が必要です。
- Python — 使いやすく、豊富なライブラリが揃っているPythonは、ウェブスクレイピングに最適な選択肢です。まだインストールしていない場合は、このガイドを参照してください。
- BeautifulSoup — これはPythonで利用できる数多くのウェブスクレイピング用ライブラリの1つです。シンプルで使いやすいため、ウェブスクレイピングで広く利用されています。Pythonのインストールが完了したら、次のコマンドを実行してBeautiful Soupをインストールできます。pip install bs4
- HTMLタグの基礎知識 — このチュートリアルを参照して、HTMLタグについて必要な知識を身につけましょう。
- ウェブブラウザー — ウェブサイトから無関係な情報を多数除外する必要があるため、フィルタリングには特定のIDやタグが必要です。Google ChromeやMozilla Firefoxなどのウェブブラウザーを使うと、それらのタグを特定できます。
スクレイピングの準備
まず、Pythonがインストールされていることを確認してください。Python 3.8以降がインストールされていない場合は、python.orgにアクセスして最新バージョンをダウンロードし、インストールしてください。
次に、Amazonのウェブスクレイピング用コードファイルを保存するディレクトリを作成します。プロジェクト用の仮想環境を設定しておくのがおすすめです。
macOSおよびLinuxで仮想環境を作成して有効化するには、次のコマンドを使用します。
$ python3 -m venv .env $ source .env/bin/activateWindowsの場合、コマンドは少し異なります。
d:amazon>python -m venv .env d:amazon>.envscriptsactivate次に、必要なPythonパッケージをインストールします。
必要なパッケージは、HTMLの取得と、関連データを抽出するための解析という2つの主な作業に使用します。
Requestsライブラリは、HTTPリクエストを行うために広く使われているサードパーティ製のPythonライブラリです。ウェブサーバーへのHTTPリクエストとレスポンスの受信を、シンプルで使いやすいインターフェースで実行できます。ウェブスクレイピング用ライブラリとして、おそらく最もよく知られています。
ただし、Requestsライブラリには制限があります。HTMLレスポンスを文字列として返すため、ウェブスクレイピングのコードを書く際に、掲載価格などの特定の要素を検索するのが難しい場合があります。
そこで役立つのがBeautiful Soupです。Beautiful Soupは、HTMLファイルやXMLファイルからデータを抽出するために設計されたPythonライブラリです。タグ、属性、または特定のテキストを検索して、ウェブページから情報を取得できます。
両方のライブラリをインストールするには、次のコマンドを使用します。
$ python3 -m pip install requests beautifulsoup4Windowsの場合は、「python3」を「python」に置き換え、コマンドの残りの部分はそのままにします。
d:amazon>python -m pip install requests beautifulsoup4Beautiful Soupライブラリのバージョン4をインストールしている点に注意してください。
では、Requestsスクレイピングライブラリをテストしてみましょう。amazon.pyという新しいファイルを作成し、次のコードを入力してください。
import requests url = ' https://www.amazon.com/Bose-QuietComfort-45-Bluetooth-Canceling-Headphones/dp/B098FKXT8L' response = requests.get(url) print(response.text)ファイルを保存し、ターミナルから実行します。
$ python3 amazon.pyほとんどの場合、目的のHTMLは表示されません。Amazonがリクエストをブロックし、次のようなレスポンスが返されます。
To discuss automated access to Amazon data please contact [email protected].response.status_codeを出力すると、成功を示す200ではなく、503エラーが返されていることがわかります。
Amazonは、このリクエストがブラウザから送信されたものではないと判断してブロックしています。これは多くのウェブサイトで一般的な対応です。Amazonはリクエストをブロックし、500番台、場合によっては400番台で始まるエラーコードを返すことがあります。
簡単な解決策として、ブラウザから送信されるヘッダーを模倣したヘッダーをリクエストに付加できます。
ユーザーエージェントだけを送信すれば十分な場合もあります。そうでない場合は、accept-languageヘッダーなどの追加ヘッダーが必要になることもあります。
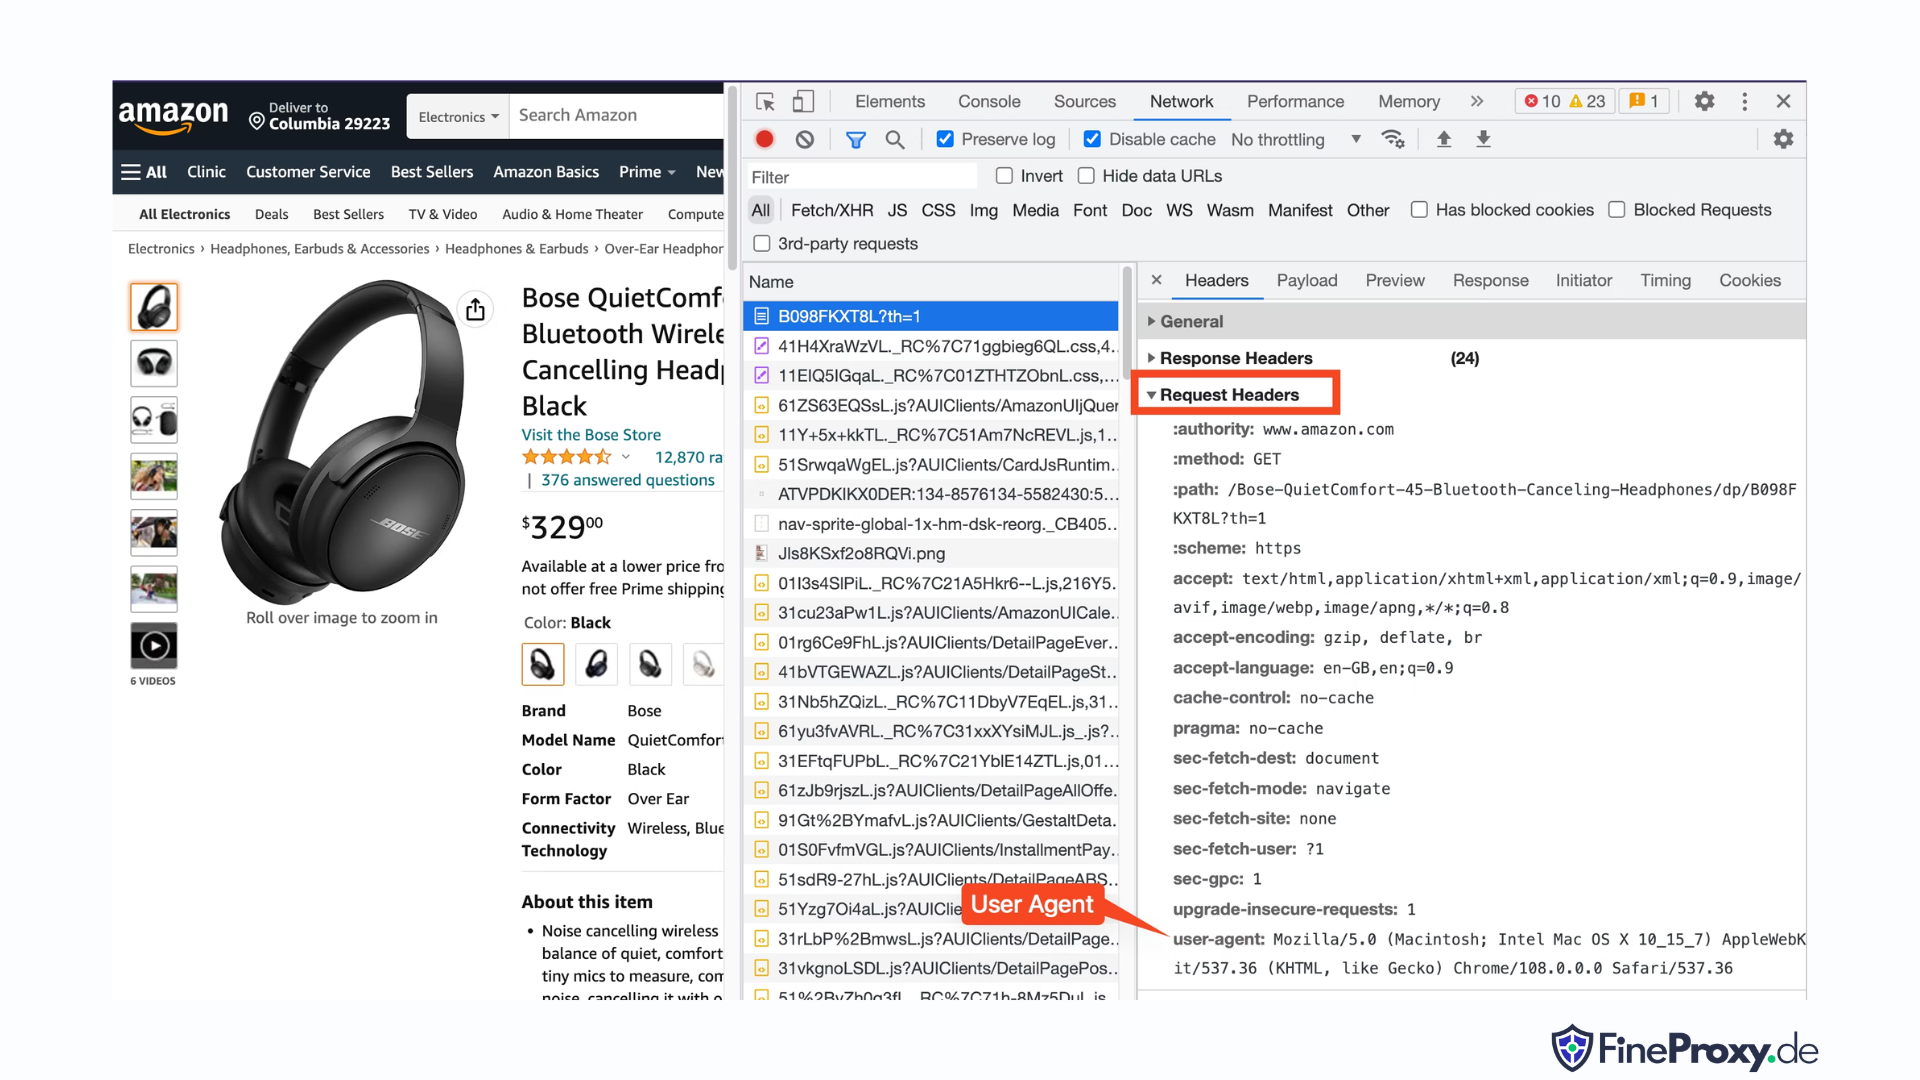
ブラウザから送信されるユーザーエージェントを確認するには、F12キーを押してNetworkタブを開き、ページを再読み込みします。最初のリクエストを選択し、Request Headersを確認してください。
このユーザーエージェントをコピーし、ユーザーエージェントとaccept-languageヘッダーを含む次の例のように、ヘッダー用の辞書を作成します。
custom_headers = { ' user-agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/108.0.0.0 Safari/537.36', 'accept-language': 'en-GB,en;q=0.9', }次に、この辞書をgetメソッドのオプションのパラメーターとして送信できます。
response = requests.get(url, headers=custom_headersAmazonの商品情報のスクレイピング
Amazonの商品をウェブスクレイピングする際は、通常、カテゴリページと商品詳細ページの2種類のページを扱います。
たとえば、https://www.amazon.com/b?node=12097479011にアクセスするか、Amazonでオーバーイヤーヘッドホンを検索してください。検索結果が表示されるページは、カテゴリページと呼ばれます。
カテゴリページには、商品タイトル、商品画像、商品評価、商品価格、そして最も重要な商品ページのURLが表示されます。商品説明などの詳しい情報にアクセスするには、商品詳細ページに移動する必要があります。
商品詳細ページの構造を分析してみましょう。
Chromeなどの最新ブラウザで、https://www.amazon.com/Bose-QuietComfort-45-Bluetooth-Canceling-Headphones/dp/B098FKXT8Lのような商品URLを開きます。商品タイトルを右クリックし、「検証」を選択します。商品タイトルのHTMLマークアップがハイライト表示されます。
id属性に「productTitle」が設定されたspanタグであることがわかります。
同様に、価格を右クリックして「検証」を選択すると、価格のHTMLマークアップを確認できます。
価格のドル部分はクラス「a-price-whole」のspanタグに、セント部分はクラス「a-price-fraction」の別のspanタグに含まれています。
同じ方法で評価、画像、説明も見つけられます。
この情報を集めたら、既存のコードに次の行を追加します。
response = requests.get(url, headers=custom_headers) soup = BeautifulSoup(response.text, 'lxml')Beautiful Soupには、findメソッドを使ってタグを選択する独自の方法があります。また、代替手段としてCSSセレクターもサポートしています。どちらの方法でも同じ結果が得られます。このチュートリアルでは、要素を選択する汎用的な方法であるCSSセレクターを使用します。CSSセレクターは、Amazonの商品情報を抽出するほぼすべてのウェブスクレイピングツールで利用できます。
これで、Soupオブジェクトを使って特定の情報を取得する準備ができました。
商品名の抽出
商品名またはタイトルは、idが「productTitle」のspan要素にあります。一意のidを使った要素の選択は簡単です。
例として、次のコードを見てみましょう。
title_element = soup.select_one('#productTitle')CSSセレクターをselect_oneメソッドに渡すと、要素のインスタンスが返されます。
テキストから情報を抽出するには、text属性を使います。
title = title_element.text出力すると、余分な空白が含まれている場合があります。これを解消するには、次のように.strip()関数を呼び出します。
title = title_element.text.strip()商品評価の抽出
Amazonの商品評価を取得するには、少し追加の作業が必要です。
まず、評価のセレクターを指定します。
#acrPopover次に、評価を含む要素を選択するため、次の文を使います。
rating_element = soup.select_one('#acrPopover')実際の評価値はtitle属性に含まれていることに注意してください。
rating_text = rating_element.attrs.get('title') print(rating_text) # prints '4.6 out of 5 stars'最後に、replaceメソッドを使って数値の評価を取得します。
rating = rating_text.replace('out of 5 stars', '')商品価格の抽出
商品価格は、商品タイトルの下と「今すぐ購入」ボックス内の2か所にあります。
Amazonの商品価格のスクレイピングには、どちらのタグも使用できます。
価格のCSSセレクターを作成します。
#price_inside_buybox次のように、このCSSセレクターをBeautifulSoupのselect_oneメソッドに渡します。
price_element = soup.select_one('#price_inside_buybox')これで、価格を出力できます。
print(price_element.text)画像の抽出
デフォルトの画像をスクレイピングするには、CSSセレクター#landingImageを使います。この情報を使って、次のコード行を記述すれば、src属性から画像URLを取得できます。
image_element = soup.select_one('#landingImage') image = image_element.attrs.get('src')商品説明の抽出
Amazonの商品データを抽出する次の手順は、商品説明の取得です。
手順は同じです。CSSセレクターを作成し、select_oneメソッドを使います。
説明のCSSセレクターは次のとおりです。
#productDescriptionこれにより、次のように要素を抽出できます。
description_element = soup.select_one('#productDescription') print(description_element.text)商品一覧の処理
商品情報のスクレイピング方法を見てきましたが、商品データにアクセスするには、商品一覧ページまたはカテゴリページから始める必要があります。
たとえば、https://www.amazon.com/b?node=12097479011はオーバーイヤーヘッドホンのカテゴリページです。
このページを調べると、すべての商品が一意の属性[data-asin]を持つdiv内に含まれていることがわかります。そのdiv内では、すべての商品リンクがh2タグ内にあります。
この情報をもとにしたCSSセレクターは次のとおりです。
[data-asin] h2 aこのセレクターのhref属性を読み取り、ループを実行できます。ただし、リンクは相対パスであることに注意してください。これらのリンクを解析するには、urljoinメソッドを使う必要があります。
from urllib.parse import urljoin ... def parse_listing(listing_url): … link_elements = soup_search.select("[data-asin] h2 a") page_data = [] for link in link_elements: full_url = urljoin(search_url, link.attrs.get("href")) product_info = get_product_info(full_url) page_data.append(product_info)ページネーションの処理
次のページへのリンクは、「Next」というテキストを含むリンク内にあります。次のように、CSSのcontains演算子を使ってこのリンクを検索できます。
next_page_el = soup.select_one('a:contains("Next")') if next_page_el: next_page_url = next_page_el.attrs.get('href') next_page_url = urljoin(listing_url, next_page_url)Amazonデータのエクスポート
スクレイピングしたデータは、意図的に辞書として返されます。スクレイピングした商品をすべて含むリストを作成できます。
def parse_listing(listing_url): ... page_data = [] for link in link_elements: ... product_info = get_product_info(full_url) page_data.append(product_info)次に、このpage_dataを使ってPandasのDataFrameオブジェクトを作成できます。
df = pd.DataFrame(page_data) df.to_csv('headphones.csv', index = False)Amazonで複数ページをスクレイピングする方法
Amazonで複数のページをスクレイピングすると、分析対象となるデータセットの範囲が広がり、Webスクレイピングプロジェクトの効果を高められます。複数のページを対象にする場合は、コンテンツを複数のページに分割するページネーションについて考慮する必要があります。
Amazonで複数のページをスクレイピングする際に留意すべき6つの重要なポイントをご紹介します。
- ページネーションのパターンを特定する:まず、カテゴリーページまたは検索結果ページのURL構造を分析し、Amazonがコンテンツをどのようにページ分割しているかを把握します。クエリパラメーター(例:「?page=2」)の場合もあれば、URLに埋め込まれた固有の識別子の場合もあります。
- 「次へ」ページのリンクを抽出する:次のページへのリンクを含む要素(通常はアンカータグ)を見つけます。適切なCSSセレクターまたはBeautiful Soupのメソッドを使って、この要素のhref属性を抽出します。これが次のページのURLです。
- 相対URLを絶対URLに変換する:抽出したURLは相対URLの場合があるため、
urllib.parseライブラリのurljoin関数を使って絶対URLに変換します。 - ループを作成する:各ページから目的のデータをスクレイピングするループを実装します。現在のページに「次へ」ページのリンクがあるかどうかを確認し、リンクがなくなるまでループを続けます。
- リクエストの間に遅延を設ける:Amazonのサーバーに過剰な負荷をかけたり、ボット対策を作動させたりしないよう、
timeライブラリのtime.sleep()関数を使ってリクエストの間に遅延を設けます。人間の閲覧行動を再現できるよう、遅延時間を調整してください。 - CAPTCHAやブロックへの対処:複数ページのスクレイピング中にCAPTCHAが表示されたり、IPアドレスがブロックされたりした場合は、プロキシを使ってIPアドレスを切り替えるか、こうした課題に自動で対処できる専用のスクレイピングツールやサービスの利用を検討してください。
以下では、AmazonのWebサイトから複数ページにわたってデータを抽出する方法を解説した、詳しいYouTube動画チュートリアルをご覧いただけます。このチュートリアルではWebスクレイピングについて掘り下げ、Amazonの多数のページから貴重な情報を効率よく効果的に収集するための手法に焦点を当てています。
チュートリアルでは、Python、BeautifulSoup、requestsなどの必須ツールやライブラリの使い方を紹介するとともに、Amazonのボット対策によるブロックや検知を避けるためのベストプラクティスを解説しています。ページネーションへの対処、リクエスト頻度の制限の管理、人間らしい閲覧行動の再現など、重要なトピックを取り上げています。
動画で紹介されている手順に加えて、このチュートリアルではWebスクレイピングを最適化するための便利なヒントやコツも紹介しています。IP制限を回避するためにプロキシを使用する方法、User-Agentやリクエストヘッダーをランダム化する方法、スムーズで中断のないスクレイピングを実現するために適切なエラー処理を実装する方法などが含まれます。
Amazonスクレイピング:よくある質問
人気のeコマースプラットフォームであるAmazonからデータを抽出する際には、注意すべき点がいくつかあります。Amazonのデータスクレイピングに関するよくある質問を見ていきましょう。
1. Amazonのスクレイピングは合法ですか?
インターネット上で一般公開されているデータのスクレイピングは合法であり、Amazonのスクレイピングもこれに含まれます。商品詳細、説明、評価、価格などの情報は合法的にスクレイピングできます。ただし、商品レビューをスクレイピングする場合は、個人データや著作権の保護に注意が必要です。たとえば、レビュアーの名前やアバターは個人データに該当する可能性があり、レビューの文章は著作権で保護されている可能性があります。このようなデータをスクレイピングする際は、常に慎重に対応し、法律の専門家に相談してください。
2. Amazonはスクレイピングを許可していますか?
一般公開されているデータのスクレイピングは合法ですが、Amazonはスクレイピングを防ぐための対策を講じることがあります。こうした対策には、リクエストのレート制限、IPアドレスのブロック、スクレイピングボットを検出するためのブラウザーフィンガープリンティングなどがあります。Amazonは通常、200 OKの成功ステータスコードを返してウェブスクレイピングをブロックし、CAPTCHAの入力を求めるか、HTTP Error 503 Service Unavailableのメッセージを表示して、有料APIについて営業に問い合わせるよう案内します。
これらの対策を回避する方法はありますが、倫理的にウェブスクレイピングを行えば、そもそも対策が作動するのを防ぐことができます。倫理的なウェブスクレイピングでは、リクエストの頻度を制限し、適切なユーザーエージェントを使用し、ウェブサイトのパフォーマンスに影響を与えるおそれのある過剰なスクレイピングを避けます。倫理的にスクレイピングを行うことで、Amazonから有用なデータを抽出しながら、ブロックされたり法的措置を受けたりするリスクを減らせます。
3. Amazonのデータをスクレイピングすることは倫理的ですか?
倫理的なスクレイピングとは、対象のウェブサイトを尊重して行うことです。リクエストを大量に送ってAmazonのウェブサイトに過剰な負荷をかける可能性は低いものの、倫理的なスクレイピングのガイドラインに従うべきです。倫理的にスクレイピングを行えば、法的な問題に直面したり、スクレイピング対策への対応を迫られたりするリスクを最小限に抑えられます。
4. Amazonをスクレイピングする際にブロックされないようにするには?
Amazonのスクレイピング時にブロックされないようにするには、リクエストの頻度を抑え、アクセスが集中する時間帯のスクレイピングを避け、スマートプロキシローテーションを使用し、検出を避けるために適切なユーザーエージェントとヘッダーを使いましょう。また、必要なデータだけを抽出し、サードパーティ製のスクレイピングツールやスクレイピングライブラリを利用してください。
5. Amazonをスクレイピングするリスクは何ですか?
Amazonのデータをスクレイピングすると、法的措置やアカウントの停止などのリスクが生じる可能性があります。Amazonは、IPアドレスのブロック、レート制限、ブラウザーフィンガープリンティングなどのボット対策を用いて、スクレイピングを検出・防止しています。ただし、倫理的にスクレイピングを行うことで、こうしたリスクを軽減できます。
結論
Amazonウェブスクレイピングの魅力的な迷宮を抜け出した今、このスリリングな旅で得た貴重な知識とスキルを振り返ってみましょう。信頼できるガイドであるProxyCompassとともに、小売業界の巨人からかけがえのないデータを抽出するための、曲がりくねった道のりを見事に進んできました。新たに身につけた専門知識を巧みに活用して旅立つ際には、デジタルのジャングルが絶えず進化し続けていることを忘れないでください。
好奇心を持ち続け、ウェブスクレイピングのマチェーテを磨き続け、絶えず変化するデータ抽出の世界を切り開いていきましょう。次の冒険でお会いするまで、勇敢な探検家よ、データに基づく探求が実り多く、価値あるものとなりますように!