
Stellen Sie sich vor, Sie wären ein abenteuerlustiger Entdecker, der sich kopfüber in das weite und geheimnisvolle Reich von Amazon stürzt – nicht den Regenwald, sondern den Online-Handelsriesen. Mit jedem Klick entdecken Sie unbezahlbare Schätze und dringen tiefer in das unerforschte Gebiet der Daten vor.
Bei dieser spannenden Expedition präsentieren wir Ihnen eine Schritt-für-Schritt-Anleitung, mit der Sie sich durch den dichten digitalen Dschungel des Web-Scrapings bei Amazon navigieren können. Machen Sie sich bereit für eine Reise wie keine andere, ausgerüstet mit Expertentipps und Tricks, um wertvolle Informationen mit beispielloser Präzision zu extrahieren.
Inhaltsverzeichnis
- Welche Daten Sie von Amazon scrapen sollten
- Einige grundlegende Voraussetzungen
- Vorbereitungen für das Scraping
- Produktinformationen von Amazon scrapen
- So scrapen Sie mehrere Seiten bei Amazon
- Amazon scrapen: Häufig gestellte Fragen
- Fazit
Sammeln Sie also Ihren Mut, schnüren Sie Ihre virtuellen Stiefel, und lassen Sie uns gemeinsam unser datengestütztes Abenteuer beginnen!
Welche Daten Sie von Amazon scrapen sollten
Mit einem Amazon-Produkt sind zahlreiche Datenpunkte verbunden. Zu den wichtigsten Elementen, auf die Sie sich beim Scraping konzentrieren sollten, gehören jedoch:
- Produkttitel
- Preis
- Ersparnis (falls zutreffend)
- Artikelzusammenfassung
- Zugehörige Liste der Merkmale (falls verfügbar)
- Bewertung
- Produktbilder
Dies sind zwar die wichtigsten Aspekte, die Sie beim Scraping eines Amazon-Artikels berücksichtigen sollten, doch sollten Sie beachten, dass die extrahierten Informationen je nach Ihren konkreten Zielen variieren können.
Einige grundlegende Voraussetzungen
Um eine Suppe zuzubereiten, brauchen wir die richtigen Zutaten. Ebenso benötigt unser neuer Web-Scraper bestimmte Komponenten.
- Python — Dank seiner Benutzerfreundlichkeit und umfangreichen Bibliothekssammlung ist Python die erste Wahl für Web-Scraping. Falls es noch nicht installiert ist, finden Sie in dieser Anleitung weitere Informationen.
- BeautifulSoup — Dies ist eine von vielen Web-Scraping-Bibliotheken für Python. Dank ihrer Einfachheit und unkomplizierten Nutzung ist sie eine beliebte Wahl für Web-Scraping. Nachdem Sie Python erfolgreich installiert haben, können Sie Beautiful Soup mit folgendem Befehl installieren: pip install bs4
- Grundkenntnisse zu HTML-Tags — In diesem Tutorial finden Sie die notwendigen Informationen zu HTML-Tags.
- Webbrowser — Da wir viele irrelevante Informationen einer Website herausfiltern müssen, sind bestimmte IDs und Tags für die Filterung erforderlich. Ein Webbrowser wie Google Chrome oder Mozilla Firefox ist hilfreich, um diese Tags zu identifizieren.
Einrichtung für das Scraping
Stellen Sie zunächst sicher, dass Python installiert ist. Falls Sie Python 3.8 oder höher nicht installiert haben, besuchen Sie python.org, um die neueste Version herunterzuladen und zu installieren.
Erstellen Sie als Nächstes ein Verzeichnis, in dem Sie Ihre Web-Scraping-Code-Dateien für Amazon speichern. Im Allgemeinen empfiehlt es sich, für Ihr Projekt eine virtuelle Umgebung einzurichten.
Verwenden Sie die folgenden Befehle, um unter macOS und Linux eine virtuelle Umgebung zu erstellen und zu aktivieren:
$ python3 -m venv .env $ source .env/bin/activateFür Windows-Nutzer lauten die Befehle etwas anders:
d:amazon>python -m venv .env d:amazon>.envscriptsactivateJetzt ist es an der Zeit, die erforderlichen Python-Pakete zu installieren.
Sie benötigen Pakete für zwei Hauptaufgaben: das Abrufen des HTML-Codes und dessen Analyse, um relevante Daten zu extrahieren.
Die Requests-Bibliothek ist eine weit verbreitete Python-Bibliothek eines Drittanbieters, mit der HTTP-Anfragen gestellt werden. Sie bietet eine einfache und benutzerfreundliche Schnittstelle, um HTTP-Anfragen an Webserver zu senden und Antworten zu empfangen. Sie ist wohl die bekannteste Bibliothek für Web-Scraping.
Die Requests-Bibliothek hat jedoch eine Einschränkung: Sie gibt die HTML-Antwort als Zeichenfolge zurück, in der sich beim Schreiben von Web-Scraping-Code bestimmte Elemente wie Angebotspreise nur schwer finden lassen.
Hier kommt Beautiful Soup ins Spiel. Beautiful Soup ist eine für Web-Scraping entwickelte Python-Bibliothek, die Daten aus HTML- und XML-Dateien extrahiert. Damit können Sie Informationen von einer Webseite abrufen, indem Sie nach Tags, Attributen oder bestimmten Texten suchen.
Verwenden Sie zum Installieren beider Bibliotheken den folgenden Befehl:
$ python3 -m pip install requests beautifulsoup4Windows-Nutzer ersetzen „python3“ durch „python“ und lassen den Rest des Befehls unverändert:
d:amazon>python -m pip install requests beautifulsoup4Beachten Sie, dass wir Version 4 der Beautiful-Soup-Bibliothek installieren.
Testen wir nun die Scraping-Bibliothek Requests. Erstellen Sie eine neue Datei namens amazon.py und geben Sie den folgenden Code ein:
import requests url = ' https://www.amazon.com/Bose-QuietComfort-45-Bluetooth-Canceling-Headphones/dp/B098FKXT8L' response = requests.get(url) print(response.text)Speichern Sie die Datei und führen Sie sie im Terminal aus.
$ python3 amazon.pyIn den meisten Fällen können Sie den gewünschten HTML-Code nicht anzeigen. Amazon blockiert die Anfrage und Sie erhalten die folgende Antwort:
To discuss automated access to Amazon data please contact [email protected].Wenn Sie response.status_code ausgeben, sehen Sie, dass Sie statt des Erfolgscodes 200 einen Fehler 503 erhalten.
Amazon erkennt, dass diese Anfrage nicht von einem Browser stammt, und blockiert sie. Diese Vorgehensweise ist bei vielen Websites üblich. Amazon kann Ihre Anfragen blockieren und einen Fehlercode zurückgeben, der mit 500 oder manchmal sogar mit 400 beginnt.
Eine einfache Lösung besteht darin, mit Ihrer Anfrage Header zu senden, die denen eines Browsers ähneln.
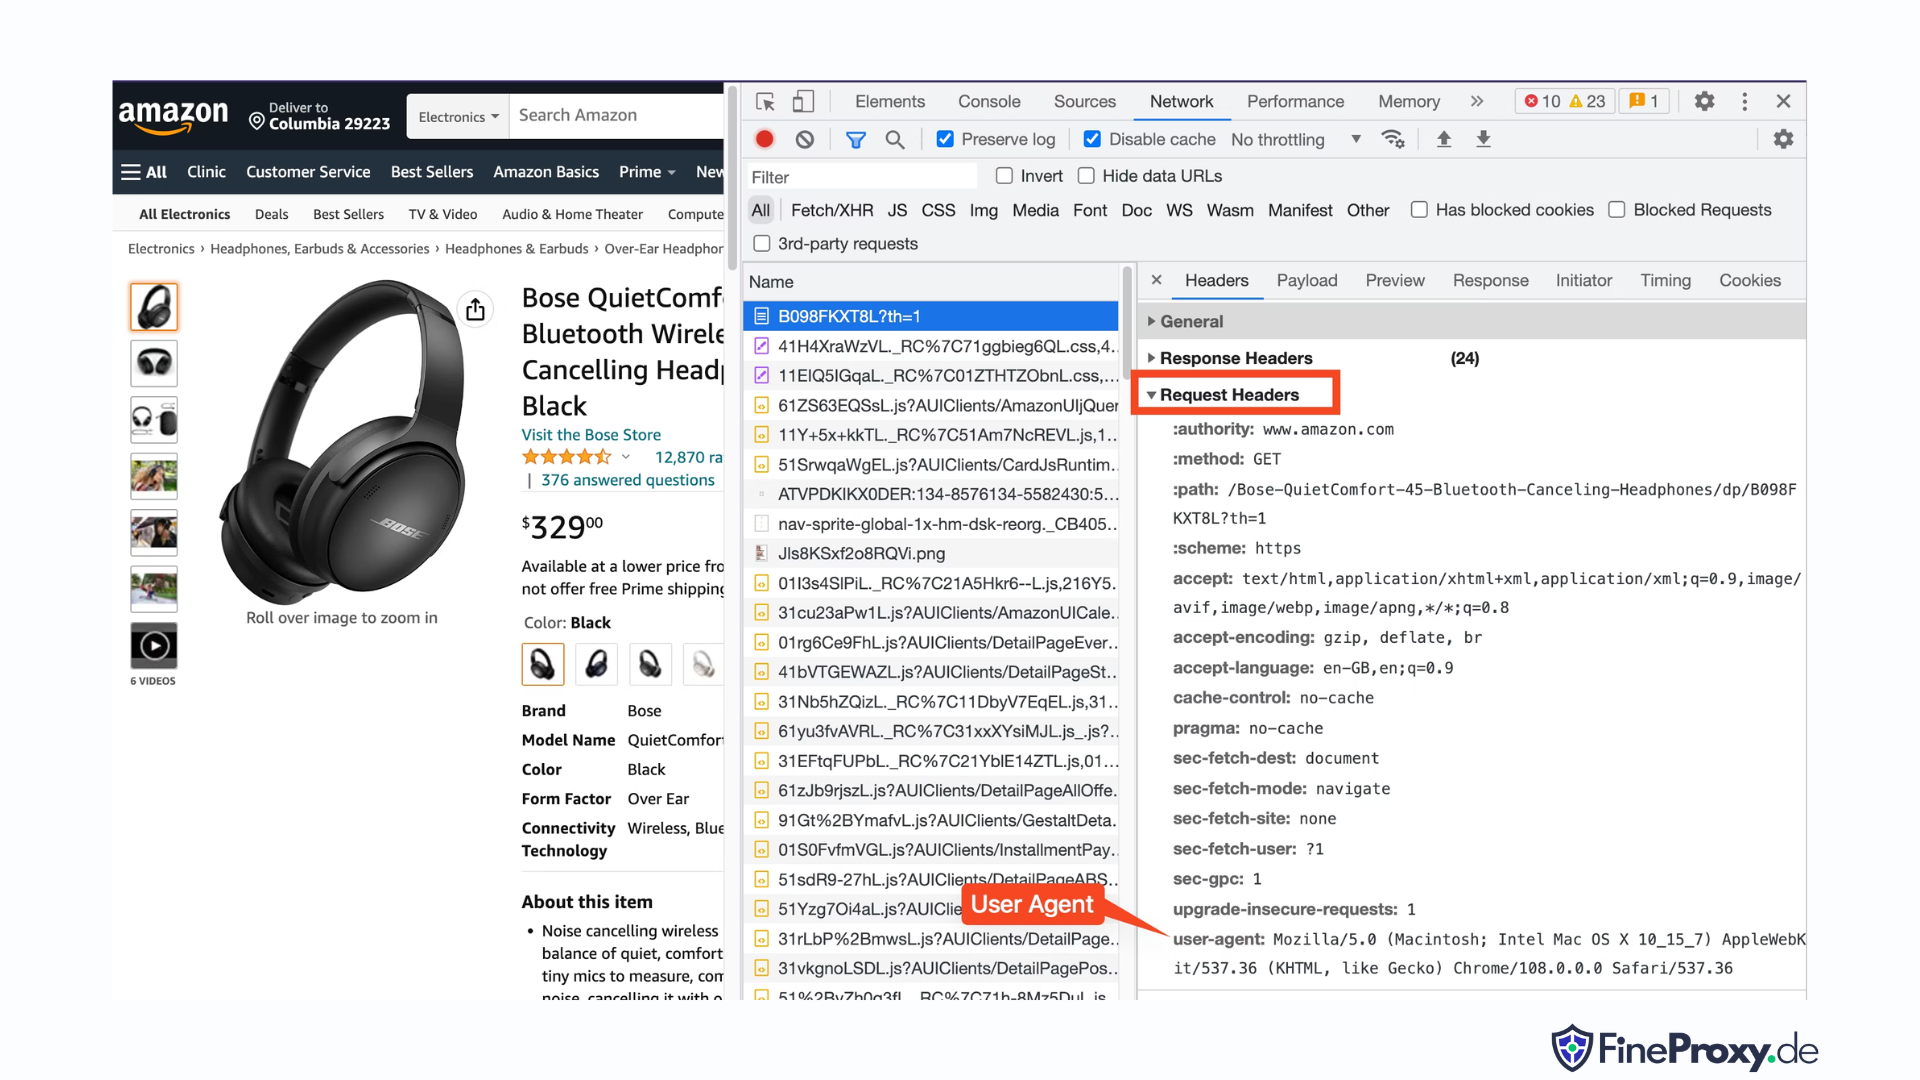
Manchmal reicht es aus, nur den User-Agent zu senden. In anderen Fällen müssen Sie möglicherweise zusätzliche Header senden, etwa den Accept-Language-Header.
Um den von Ihrem Browser gesendeten User-Agent zu finden, drücken Sie F12, öffnen Sie den Tab „Netzwerk“ und laden Sie die Seite neu. Wählen Sie die erste Anfrage aus und prüfen Sie die Request-Header.
Kopieren Sie diesen User-Agent und erstellen Sie ein Dictionary für die Header, wie in diesem Beispiel mit den User-Agent- und Accept-Language-Headern:
custom_headers = { ' user-agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/108.0.0.0 Safari/537.36', 'accept-language': 'en-GB,en;q=0.9', }Anschließend können Sie dieses Dictionary als optionalen Parameter an die Methode get übergeben:
response = requests.get(url, headers=custom_headersAmazon-Produktinformationen scrapen
Beim Scrapen von Amazon-Produkten arbeiten Sie in der Regel mit zwei Seitentypen: der Kategorieseite und der Produktdetailseite.
Besuchen Sie beispielsweise https://www.amazon.com/b?node=12097479011 oder suchen Sie auf Amazon nach Over-Ear-Kopfhörern. Die Seite mit den Suchergebnissen wird als Kategorieseite bezeichnet.
Auf der Kategorieseite werden der Produkttitel, das Produktbild, die Produktbewertung, der Produktpreis und vor allem die Produkt-URLs angezeigt. Um auf weitere Informationen wie Produktbeschreibungen zuzugreifen, müssen Sie die Produktdetailseite besuchen.
Sehen wir uns den Aufbau der Produktdetailseite an.
Öffnen Sie eine Produkt-URL, etwa https://www.amazon.com/Bose-QuietComfort-45-Bluetooth-Canceling-Headphones/dp/B098FKXT8L, in Chrome oder einem anderen modernen Browser. Klicken Sie mit der rechten Maustaste auf den Produkttitel und wählen Sie „Untersuchen“. Das HTML-Markup des Produkttitels wird hervorgehoben.
Sie werden feststellen, dass es sich um ein span-Tag handelt, dessen id-Attribut auf „productTitle“ gesetzt ist.
Klicken Sie entsprechend mit der rechten Maustaste auf den Preis und wählen Sie „Untersuchen“, um das HTML-Markup des Preises anzuzeigen.
Der Dollarbetrag des Preises befindet sich in einem span-Tag mit der Klasse „a-price-whole“, während der Centbetrag in einem anderen span-Tag mit der Klasse „a-price-fraction“ steht.
Auf dieselbe Weise können Sie auch die Bewertung, das Bild und die Beschreibung finden.
Sobald Sie diese Informationen gesammelt haben, fügen Sie dem vorhandenen Code die folgenden Zeilen hinzu:
response = requests.get(url, headers=custom_headers) soup = BeautifulSoup(response.text, 'lxml')Beautiful Soup bietet mit den find-Methoden eine eigene Methode zum Auswählen von Tags. Alternativ werden auch CSS-Selektoren unterstützt. Mit beiden Ansätzen erzielen Sie dasselbe Ergebnis. In diesem Tutorial verwenden wir CSS-Selektoren, eine universelle Methode zum Auswählen von Elementen. CSS-Selektoren sind mit nahezu allen Web-Scraping-Tools zum Extrahieren von Amazon-Produktinformationen kompatibel.
Jetzt können Sie das Soup-Objekt verwenden, um gezielt Informationen abzufragen.
Produktnamen extrahieren
Der Produktname oder Titel befindet sich in einem span-Element mit der id „productTitle“. Elemente anhand eindeutiger IDs auszuwählen, ist ganz einfach.
Sehen Sie sich den folgenden Code als Beispiel an:
title_element = soup.select_one('#productTitle')Wir übergeben den CSS-Selektor an die Methode select_one, die eine Elementinstanz zurückgibt.
Um Informationen aus dem Text zu extrahieren, verwenden Sie das Attribut text.
title = title_element.textBei der Ausgabe werden Sie möglicherweise einige Leerzeichen bemerken. Um dieses Problem zu beheben, fügen Sie wie folgt einen Aufruf der Funktion .strip() hinzu:
title = title_element.text.strip()Produktbewertungen extrahieren
Das Abrufen von Amazon-Produktbewertungen erfordert etwas zusätzlichen Aufwand.
Legen Sie zunächst einen Selektor für die Bewertung fest:
#acrPopoverVerwenden Sie anschließend die folgende Anweisung, um das Element mit der Bewertung auszuwählen:
rating_element = soup.select_one('#acrPopover')Beachten Sie, dass sich der eigentliche Bewertungswert im title-Attribut befindet:
rating_text = rating_element.attrs.get('title') print(rating_text) # prints '4.6 out of 5 stars'Verwenden Sie abschließend die Methode replace, um die numerische Bewertung zu erhalten:
rating = rating_text.replace('out of 5 stars', '')Produktpreis extrahieren
Der Produktpreis ist an zwei Stellen zu finden – unter dem Produkttitel und im Feld „Jetzt kaufen“.
Beide Tags können zum Scrapen von Amazon-Produktpreisen verwendet werden.
Erstellen Sie einen CSS-Selektor für den Preis:
#price_inside_buyboxÜbergeben Sie diesen CSS-Selektor wie folgt an die Methode select_one von BeautifulSoup:
price_element = soup.select_one('#price_inside_buybox')Jetzt können Sie den Preis ausgeben:
print(price_element.text)Bild extrahieren
Verwenden Sie zum Scrapen des Standardbilds den CSS-Selektor #landingImage. Mit diesen Informationen können Sie die folgenden Codezeilen schreiben, um die Bild-URL aus dem src-Attribut abzurufen:
image_element = soup.select_one('#landingImage') image = image_element.attrs.get('src')Produktbeschreibung extrahieren
Der nächste Schritt beim Extrahieren von Amazon-Produktdaten ist das Abrufen der Produktbeschreibung.
Das Vorgehen bleibt gleich – erstellen Sie einen CSS-Selektor und verwenden Sie die Methode select_one.
Der CSS-Selektor für die Beschreibung lautet:
#productDescriptionDamit können wir das Element wie folgt extrahieren:
description_element = soup.select_one('#productDescription') print(description_element.text)Produktangebote verarbeiten
Wir haben uns mit dem Scrapen von Produktinformationen beschäftigt. Um auf die Produktdaten zugreifen zu können, müssen Sie jedoch mit Produktangebots- oder Kategorieseiten beginnen.
Beispielsweise ist https://www.amazon.com/b?node=12097479011 die Kategorieseite für Over-Ear-Kopfhörer.
Wenn Sie diese Seite untersuchen, sehen Sie, dass alle Produkte in einem div enthalten sind, das über ein eindeutiges Attribut [data-asin] verfügt. Innerhalb dieses div befinden sich alle Produktlinks in einem h2-Tag.
Mit diesen Informationen lautet der CSS-Selektor:
[data-asin] h2 aSie können das href-Attribut dieses Selektors auslesen und eine Schleife ausführen. Beachten Sie jedoch, dass die Links relativ sind. Zum Parsen dieser Links müssen Sie die Methode urljoin verwenden.
from urllib.parse import urljoin ... def parse_listing(listing_url): … link_elements = soup_search.select("[data-asin] h2 a") page_data = [] for link in link_elements: full_url = urljoin(search_url, link.attrs.get("href")) product_info = get_product_info(full_url) page_data.append(product_info)Paginierung verarbeiten
Der Link zur nächsten Seite befindet sich in einem Link, der den Text „Next“ enthält. Mit dem contains-Operator von CSS können Sie wie folgt nach diesem Link suchen:
next_page_el = soup.select_one('a:contains("Next")') if next_page_el: next_page_url = next_page_el.attrs.get('href') next_page_url = urljoin(listing_url, next_page_url)Amazon-Daten exportieren
Die gescrapten Daten werden absichtlich als Wörterbuch zurückgegeben. Sie können eine Liste mit allen gescrapten Produkten erstellen.
def parse_listing(listing_url): ... page_data = [] for link in link_elements: ... product_info = get_product_info(full_url) page_data.append(product_info)Anschließend können Sie mit diesen page_data ein Pandas-DataFrame-Objekt erstellen:
df = pd.DataFrame(page_data) df.to_csv('headphones.csv', index = False)So scrapen Sie mehrere Seiten auf Amazon
Das Scrapen mehrerer Seiten auf Amazon kann die Effektivität Ihres Web-Scraping-Projekts steigern, da Sie dadurch einen umfangreicheren Datensatz zur Analyse erhalten. Wenn Sie mehrere Seiten anvisieren, müssen Sie die Paginierung berücksichtigen, also die Aufteilung von Inhalten auf mehrere Seiten.
Hier sind 6 wichtige Punkte, die Sie beim Scrapen mehrerer Seiten auf Amazon beachten sollten:
- Das Paginierungsmuster ermitteln: Analysieren Sie zunächst die URL-Struktur der Kategorie- oder Suchergebnisseiten, um zu verstehen, wie Amazon seine Inhalte paginiert. Dies kann ein Abfrageparameter (z. B. „?page=2“) oder eine in der URL eingebettete eindeutige Kennung sein.
- Den Link zur Seite „Weiter“ extrahieren: Suchen Sie das Element (in der Regel ein Anker-Tag), das den Link zur nächsten Seite enthält. Verwenden Sie den entsprechenden CSS-Selektor oder eine Beautiful-Soup-Methode, um das href-Attribut dieses Elements zu extrahieren. Es enthält die URL der nächsten Seite.
- Relative URLs in absolute URLs umwandeln: Da die extrahierten URLs relativ sein können, verwenden Sie die Funktion
urljoinaus der Bibliothekurllib.parse, um sie in absolute URLs umzuwandeln. - Eine Schleife erstellen: Implementieren Sie eine Schleife, die die Seiten durchläuft und auf jeder Seite die gewünschten Daten scrapt. Die Schleife sollte so lange laufen, bis keine weiteren Seiten mehr vorhanden sind. Dies lässt sich feststellen, indem Sie prüfen, ob auf der aktuellen Seite ein Link zur Seite „Weiter“ vorhanden ist.
- Verzögerungen zwischen Anfragen einfügen: Um den Amazon-Server nicht zu überlasten oder Anti-Bot-Maßnahmen auszulösen, fügen Sie mit der Funktion
time.sleep()aus der BibliothektimeVerzögerungen zwischen den Anfragen ein. Passen Sie die Dauer der Verzögerung so an, dass sie menschliches Surfverhalten nachahmt. - CAPTCHAs und Sperren bewältigen: Wenn beim Scrapen mehrerer Seiten CAPTCHAs oder IP-Sperren auftreten, sollten Sie Proxys zur Rotation der IP-Adressen oder spezielle Scraping-Tools und -Dienste verwenden, die diese Herausforderungen automatisch bewältigen können.
Unten finden Sie ein umfassendes YouTube-Video-Tutorial, das Sie durch den Prozess der Datenextraktion von mehreren Seiten der Amazon-Website führt. Das Tutorial bietet einen detaillierten Einblick in die Welt des Web-Scrapings und konzentriert sich auf Techniken, mit denen Sie effizient und effektiv wertvolle Informationen von zahlreichen Amazon-Seiten sammeln können.
Im Tutorial zeigt der Präsentator die Verwendung wichtiger Tools und Bibliotheken wie Python, BeautifulSoup und requests und erläutert zugleich bewährte Methoden, mit denen Sie vermeiden, von Amazons Anti-Bot-Mechanismen blockiert oder erkannt zu werden. Das Video behandelt wichtige Themen wie den Umgang mit Paginierung, die Verwaltung von Ratenlimits und die Nachahmung menschlichen Surfverhaltens.
Zusätzlich zu den Schritt-für-Schritt-Anleitungen im Video enthält das Tutorial auch nützliche Tipps und Tricks, mit denen Sie Ihr Web-Scraping optimieren können. Dazu gehören die Verwendung von Proxys zur Umgehung von IP-Beschränkungen, die zufällige Anpassung des User-Agent und der Anfrage-Header sowie eine angemessene Fehlerbehandlung, um einen reibungslosen und unterbrechungsfreien Scraping-Prozess sicherzustellen.
Scraping bei Amazon: Häufig gestellte Fragen
Wenn es um das Extrahieren von Daten von Amazon, einer beliebten E-Commerce-Plattform, geht, gibt es einige Dinge, die man beachten sollte. Sehen wir uns die häufig gestellten Fragen zum Scraping von Amazon-Daten an.
1. Ist es legal, Amazon zu scrapen?
Das Scraping öffentlich zugänglicher Daten aus dem Internet ist legal, und dazu gehört auch das Scraping von Amazon. Sie dürfen Informationen wie Produktdetails, Beschreibungen, Bewertungen und Preise legal scrapen. Beim Scraping von Produktrezensionen sollten Sie jedoch bei personenbezogenen Daten und dem Urheberrecht vorsichtig sein. Der Name und das Avatarbild des Rezensenten können beispielsweise personenbezogene Daten darstellen, während der Rezensionstext urheberrechtlich geschützt sein kann. Gehen Sie beim Scrapen solcher Daten stets vorsichtig vor und holen Sie rechtlichen Rat ein.
2. Erlaubt Amazon Scraping?
Obwohl das Scraping öffentlich zugänglicher Daten legal ist, ergreift Amazon manchmal Maßnahmen, um Scraping zu verhindern. Zu diesen Maßnahmen gehören die Begrenzung der Anfragerate, das Sperren von IP-Adressen und der Einsatz von Browser-Fingerprinting, um Scraping-Bots zu erkennen. Amazon blockiert Web-Scraping üblicherweise mit einem 200-OK-Erfolgsstatuscode und verlangt, dass Sie ein CAPTCHA lösen, oder zeigt eine HTTP-Fehlermeldung 503 Service Unavailable an, die Sie auffordert, sich wegen einer kostenpflichtigen API an den Vertrieb zu wenden.
Es gibt Möglichkeiten, diese Maßnahmen zu umgehen, aber ethisches Web-Scraping kann dabei helfen, sie gar nicht erst auszulösen. Ethisches Web-Scraping bedeutet, die Häufigkeit der Anfragen zu begrenzen, geeignete User-Agents zu verwenden und übermäßiges Scraping zu vermeiden, das die Leistung der Website beeinträchtigen könnte. Indem Sie ethisch scrapen, können Sie das Risiko einer Sperrung oder rechtlicher Konsequenzen verringern und dennoch nützliche Daten von Amazon extrahieren.
3. Ist es ethisch vertretbar, Amazon-Daten zu scrapen?
Ethisches Scraping bedeutet, die Zielwebsite zu respektieren. Es ist zwar unwahrscheinlich, dass Sie die Amazon-Website mit zu vielen Anfragen überlasten, dennoch sollten Sie sich an die Richtlinien für ethisches Scraping halten. Ethisches Scraping kann das Risiko rechtlicher Probleme oder den Einsatz von Anti-Scraping-Maßnahmen minimieren.
4. Wie kann ich vermeiden, beim Scraping von Amazon gesperrt zu werden?
Um zu vermeiden, beim Scraping von Amazon gesperrt zu werden, sollten Sie die Anfragerate begrenzen, während der Stoßzeiten nicht scrapen, eine intelligente Proxy-Rotation einsetzen und geeignete User-Agents und Header verwenden, um nicht erkannt zu werden. Extrahieren Sie außerdem nur die benötigten Daten und verwenden Sie Scraping-Tools oder Scraping-Bibliotheken von Drittanbietern.
5. Welche Risiken birgt das Scraping von Amazon?
Das Scraping von Amazon-Daten birgt potenzielle Risiken, darunter rechtliche Schritte und die Sperrung des Kontos. Amazon setzt Anti-Bot-Maßnahmen ein, um Scraping zu erkennen und zu verhindern, darunter das Sperren von IP-Adressen, die Begrenzung der Anfragerate und Browser-Fingerprinting. Durch ethisches Scraping können Sie diese Risiken jedoch mindern.
Fazit
Nachdem wir uns aus dem faszinierenden Labyrinth des Amazon-Web-Scrapings herausgearbeitet haben, ist es an der Zeit, kurz innezuhalten und das unschätzbare Wissen und die Fähigkeiten zu würdigen, die wir auf dieser aufregenden Reise erworben haben. Mit ProxyCompass als Ihrem vertrauenswürdigen Wegweiser haben Sie die Wendungen und Windungen beim Extrahieren kostbarer Daten aus dem Handelsriesen erfolgreich gemeistert. Wenn Sie nun aufbrechen und Ihr neu gewonnenes Fachwissen geschickt einsetzen, denken Sie daran, dass sich der digitale Dschungel unaufhörlich weiterentwickelt.
Bleiben Sie neugierig, schärfen Sie Ihre Web-Scraping-Machete und erobern Sie weiterhin die sich ständig wandelnde Landschaft der Datenextraktion. Bis zu unserer nächsten waghalsigen Expedition, unerschrockener Entdecker: Mögen Ihre datengestützten Unternehmungen erfolgreich und lohnend sein!