Bayangkan diri Anda sebagai penjelajah penuh petualangan, menyelam langsung ke dunia Amazon yang luas dan misterius—bukan hutan hujan, melainkan raksasa ritel online. Dengan setiap klik, Anda menemukan harta karun yang tak ternilai, menyelami lebih dalam wilayah data yang belum terjamah.
Dalam ekspedisi seru ini, kami menyajikan panduan langkah demi langkah untuk menjelajahi rimba digital Amazon yang lebat melalui web scraping. Bersiaplah memulai perjalanan yang tiada duanya, berbekal kiat dan trik ahli untuk mengekstrak informasi berharga dengan presisi tak tertandingi.
Daftar isi
- Data Apa yang Perlu Di-scrape dari Amazon
- Beberapa Persyaratan Dasar
- Persiapan untuk Scraping
- Scraping Informasi Produk Amazon
- Cara Melakukan Scraping Beberapa Halaman di Amazon
- Scraping Amazon: Tanya Jawab Umum
- Kesimpulan
Jadi, kumpulkan keberanian Anda, kenakan sepatu bot virtual, dan mari kita mulai petualangan berbasis data ini bersama-sama!
Data Apa yang Perlu Di-scrape dari Amazon
Ada banyak titik data yang terkait dengan produk Amazon, tetapi elemen utama yang perlu diperhatikan saat melakukan scraping meliputi:
- Judul Produk
- Harga
- Penghematan (jika berlaku)
- Ringkasan Barang
- Daftar fitur terkait (jika tersedia)
- Skor ulasan
- Gambar produk
Meskipun hal-hal tersebut merupakan aspek utama yang perlu dipertimbangkan saat melakukan scraping item Amazon, penting untuk diperhatikan bahwa informasi yang Anda ekstrak dapat bervariasi, bergantung pada tujuan spesifik Anda.
Beberapa Persyaratan Dasar
Untuk menyiapkan sup, kita membutuhkan bahan-bahan yang tepat. Demikian pula, scraper web baru kita memerlukan komponen khusus.
- Python — Kemudahan penggunaannya dan koleksi pustakanya yang luas menjadikan Python pilihan utama untuk web scraping. Jika belum terinstal, lihat panduan ini.
- BeautifulSoup — Ini adalah salah satu dari banyak pustaka web scraping yang tersedia untuk Python. Kesederhanaan dan kemudahan penggunaannya menjadikannya pilihan populer untuk web scraping. Setelah berhasil menginstal Python, Anda dapat menginstal Beautiful Soup dengan menjalankan: pip install bs4
- Pemahaman Dasar tentang Tag HTML — Lihat tutorial ini untuk memperoleh pengetahuan yang diperlukan tentang tag HTML.
- Browser Web — Karena kita perlu menyaring banyak informasi yang tidak relevan dari sebuah situs web, id dan tag tertentu diperlukan untuk proses penyaringan. Browser web seperti Google Chrome atau Mozilla Firefox berguna untuk mengidentifikasi tag tersebut.
Persiapan untuk Scraping
Untuk memulai, pastikan Python sudah terinstal. Jika Anda belum memiliki Python 3.8 atau versi yang lebih baru, kunjungi python.org untuk mengunduh dan menginstal versi terbaru.
Selanjutnya, buat direktori untuk menyimpan file kode scraping web Amazon Anda. Biasanya, sebaiknya siapkan lingkungan virtual untuk proyek Anda.
Gunakan perintah berikut untuk membuat dan mengaktifkan lingkungan virtual di macOS dan Linux:
$ python3 -m venv .env $ source .env/bin/activateBagi pengguna Windows, perintahnya sedikit berbeda:
d:amazon>python -m venv .env d:amazon>.envscriptsactivateSekarang saatnya menginstal paket Python yang diperlukan.
Anda memerlukan paket untuk dua tugas utama: mendapatkan HTML dan menguraikannya untuk mengekstrak data yang relevan.
Requests adalah pustaka Python pihak ketiga yang banyak digunakan untuk membuat permintaan HTTP. Pustaka ini menawarkan antarmuka yang mudah dan sederhana untuk membuat permintaan HTTP ke server web dan menerima respons. Requests mungkin merupakan pustaka paling terkenal untuk scraping web.
Namun, pustaka Requests memiliki keterbatasan: pustaka ini mengembalikan respons HTML sebagai string, yang dapat menyulitkan pencarian elemen tertentu seperti harga listing saat menulis kode scraping web.
Di sinilah Beautiful Soup berperan. Beautiful Soup adalah pustaka Python yang dirancang untuk scraping web, yang mengekstrak data dari file HTML dan XML. Pustaka ini memungkinkan Anda mengambil informasi dari halaman web dengan mencari tag, atribut, atau teks tertentu.
Untuk menginstal kedua pustaka tersebut, gunakan perintah berikut:
$ python3 -m pip install requests beautifulsoup4Bagi pengguna Windows, ganti ‘python3’ dengan ‘python’, dan biarkan bagian perintah lainnya tetap sama:
d:amazon>python -m pip install requests beautifulsoup4Perhatikan bahwa kita menginstal Beautiful Soup versi 4.
Sekarang mari kita uji pustaka scraping Requests. Buat file baru bernama amazon.py dan masukkan kode berikut:
import requests url = ' https://www.amazon.com/Bose-QuietComfort-45-Bluetooth-Canceling-Headphones/dp/B098FKXT8L' response = requests.get(url) print(response.text)Simpan file tersebut dan jalankan dari terminal.
$ python3 amazon.pyDalam kebanyakan kasus, Anda tidak akan dapat melihat HTML yang diinginkan. Amazon akan memblokir permintaan tersebut, dan Anda akan menerima respons berikut:
To discuss automated access to Amazon data please contact [email protected].Jika Anda mencetak response.status_code, Anda akan melihat bahwa respons yang diterima adalah error 503, bukan kode sukses 200.
Amazon tahu bahwa permintaan ini tidak berasal dari browser dan memblokirnya. Praktik ini umum dilakukan oleh banyak situs web. Amazon mungkin memblokir permintaan Anda dan mengembalikan kode error yang diawali dengan 500 atau terkadang bahkan 400.
Solusi sederhana adalah mengirimkan header bersama permintaan Anda yang meniru header yang dikirim oleh browser.
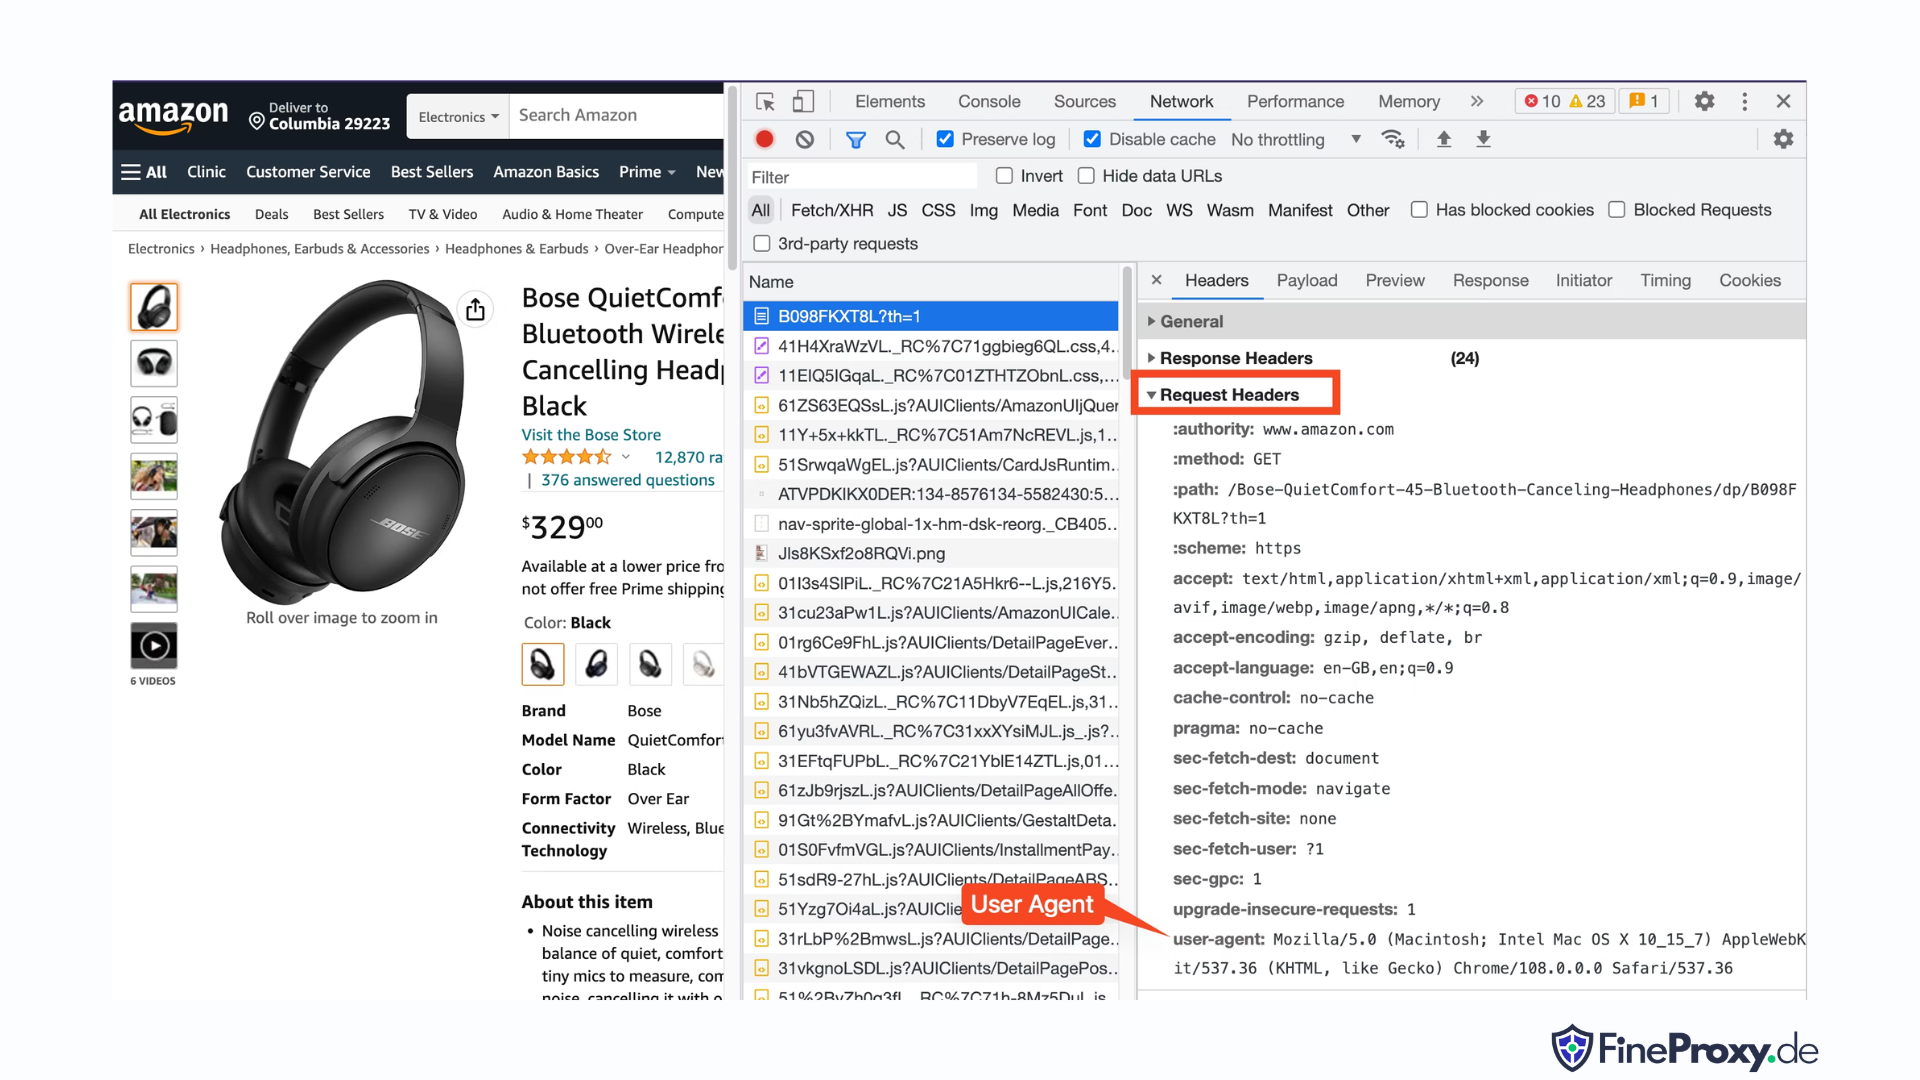
Terkadang, mengirimkan user-agent saja sudah cukup. Di lain waktu, Anda mungkin perlu mengirimkan header tambahan, seperti header accept-language.
Untuk menemukan user-agent yang dikirim oleh browser Anda, tekan F12, buka tab Network, lalu muat ulang halaman. Pilih permintaan pertama dan periksa Request Headers.
Salin user-agent ini dan buat kamus untuk header, seperti contoh berikut yang menggunakan header user-agent dan accept-language:
custom_headers = { ' user-agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/108.0.0.0 Safari/537.36', 'accept-language': 'en-GB,en;q=0.9', }Anda kemudian dapat mengirimkan kamus ini sebagai parameter opsional dalam metode get:
response = requests.get(url, headers=custom_headersMengikis Informasi Produk Amazon
Dalam proses scraping web produk Amazon, biasanya Anda akan berinteraksi dengan dua jenis halaman: halaman kategori dan halaman detail produk.
Misalnya, kunjungi https://www.amazon.com/b?node=12097479011 atau cari Headphone Over-Ear di Amazon. Halaman yang menampilkan hasil pencarian dikenal sebagai halaman kategori.
Halaman kategori menampilkan judul produk, gambar produk, peringkat produk, harga produk, dan, yang paling penting, URL halaman produk. Untuk mengakses informasi lainnya, seperti deskripsi produk, Anda harus mengunjungi halaman detail produk.
Mari kita analisis struktur halaman detail produk.
Buka URL produk, seperti https://www.amazon.com/Bose-QuietComfort-45-Bluetooth-Canceling-Headphones/dp/B098FKXT8L, menggunakan Chrome atau browser modern lainnya. Klik kanan judul produk dan pilih Inspect. Markup HTML judul produk akan disorot.
Anda akan melihat bahwa elemen tersebut adalah tag span dengan atribut id yang disetel ke “productTitle”.
Demikian pula, klik kanan harga dan pilih Inspect untuk melihat markup HTML harga.
Komponen dolar dari harga berada dalam tag span dengan class “a-price-whole”, sedangkan komponen sen berada dalam tag span lain dengan class “a-price-fraction”.
Anda juga dapat menemukan peringkat, gambar, dan deskripsi dengan cara yang sama.
Setelah mengumpulkan informasi ini, tambahkan baris berikut ke kode yang ada:
response = requests.get(url, headers=custom_headers) soup = BeautifulSoup(response.text, 'lxml')Beautiful Soup menyediakan metode khusus untuk memilih tag menggunakan metode find. Beautiful Soup juga mendukung pemilih CSS sebagai alternatif. Anda dapat menggunakan salah satu pendekatan untuk mendapatkan hasil yang sama. Dalam tutorial ini, kita akan menggunakan pemilih CSS, metode universal untuk memilih elemen. Pemilih CSS kompatibel dengan hampir semua alat scraping web untuk mengekstrak informasi produk Amazon.
Sekarang Anda siap menggunakan objek Soup untuk mencari informasi tertentu.
Mengekstrak Nama Produk
Nama atau judul produk terdapat dalam elemen span dengan id ‘productTitle’. Memilih elemen menggunakan id unik itu mudah.
Perhatikan kode berikut sebagai contoh:
title_element = soup.select_one('#productTitle')Kita meneruskan pemilih CSS ke metode select_one, yang mengembalikan instans elemen.
Untuk mengekstrak informasi dari teks, gunakan atribut text.
title = title_element.textSaat dicetak, Anda mungkin melihat beberapa spasi kosong. Untuk mengatasinya, tambahkan pemanggilan fungsi .strip() seperti berikut:
title = title_element.text.strip()Mengekstrak Peringkat Produk
Mendapatkan peringkat produk Amazon membutuhkan sedikit upaya tambahan.
Pertama, tentukan pemilih untuk peringkat:
#acrPopoverSelanjutnya, gunakan pernyataan berikut untuk memilih elemen yang berisi peringkat:
rating_element = soup.select_one('#acrPopover')Perhatikan bahwa nilai peringkat sebenarnya terdapat di dalam atribut title:
rating_text = rating_element.attrs.get('title') print(rating_text) # prints '4.6 out of 5 stars'Terakhir, gunakan metode replace untuk mendapatkan peringkat numerik:
rating = rating_text.replace('out of 5 stars', '')Mengekstrak Harga Produk
Harga produk dapat ditemukan di dua lokasi — di bawah judul produk dan di dalam kotak Buy Now.
Salah satu tag ini dapat digunakan untuk melakukan scraping harga produk Amazon.
Buat pemilih CSS untuk harga:
#price_inside_buyboxTeruskan pemilih CSS ini ke metode select_one BeautifulSoup seperti berikut:
price_element = soup.select_one('#price_inside_buybox')Sekarang, Anda dapat mencetak harganya:
print(price_element.text)Mengekstrak Gambar
Untuk melakukan scraping gambar default, gunakan pemilih CSS #landingImage. Dengan informasi ini, Anda dapat menulis baris kode berikut untuk mendapatkan URL gambar dari atribut src:
image_element = soup.select_one('#landingImage') image = image_element.attrs.get('src')Mengekstrak Deskripsi Produk
Langkah selanjutnya dalam mengekstrak data produk Amazon adalah mendapatkan deskripsi produk.
Prosesnya tetap sama — buat pemilih CSS dan gunakan metode select_one.
Pemilih CSS untuk deskripsi adalah:
#productDescriptionIni memungkinkan kita mengekstrak elemen sebagai berikut:
description_element = soup.select_one('#productDescription') print(description_element.text)Menangani Daftar Produk
Kita telah mempelajari cara melakukan scraping informasi produk, tetapi Anda perlu memulai dari halaman daftar produk atau halaman kategori untuk mengakses data produk.
Misalnya, https://www.amazon.com/b?node=12097479011 adalah halaman kategori untuk headphone over-ear.
Jika Anda memeriksa halaman ini, Anda akan melihat bahwa semua produk berada di dalam div yang memiliki atribut unik [data-asin]. Di dalam div tersebut, semua tautan produk berada dalam tag h2.
Dengan informasi ini, Pemilih CSS-nya adalah:
[data-asin] h2 aAnda dapat membaca atribut href dari pemilih ini dan menjalankan loop. Namun, ingat bahwa tautannya bersifat relatif. Anda perlu menggunakan metode urljoin untuk mengurai tautan ini.
from urllib.parse import urljoin ... def parse_listing(listing_url): … link_elements = soup_search.select("[data-asin] h2 a") page_data = [] for link in link_elements: full_url = urljoin(search_url, link.attrs.get("href")) product_info = get_product_info(full_url) page_data.append(product_info)Menangani Paginasi
Tautan ke halaman berikutnya berada dalam tautan yang berisi teks “Berikutnya”. Anda dapat mencari tautan ini menggunakan operator contains dari CSS sebagai berikut:
next_page_el = soup.select_one('a:contains("Next")') if next_page_el: next_page_url = next_page_el.attrs.get('href') next_page_url = urljoin(listing_url, next_page_url)Mengekspor Data Amazon
Data yang di-scrape sengaja dikembalikan sebagai kamus. Anda dapat membuat daftar yang berisi semua produk yang di-scrape.
def parse_listing(listing_url): ... page_data = [] for link in link_elements: ... product_info = get_product_info(full_url) page_data.append(product_info)Anda kemudian dapat menggunakan page_data ini untuk membuat objek DataFrame Pandas:
df = pd.DataFrame(page_data) df.to_csv('headphones.csv', index = False)Cara Mengambil Data dari Beberapa Halaman di Amazon
Mengambil data dari beberapa halaman di Amazon dapat meningkatkan efektivitas proyek web scraping Anda dengan menyediakan kumpulan data yang lebih luas untuk dianalisis. Saat menargetkan beberapa halaman, Anda perlu mempertimbangkan paginasi, yaitu proses membagi konten ke beberapa halaman.
Berikut 6 poin penting yang perlu diingat saat mengambil data dari beberapa halaman di Amazon:
- Identifikasi pola paginasi: Pertama, analisis struktur URL halaman kategori atau hasil pencarian untuk memahami cara Amazon membagi kontennya ke dalam beberapa halaman. Ini bisa berupa parameter kueri (misalnya, “?page=2”) atau pengenal unik yang disisipkan dalam URL.
- Ambil tautan halaman “Berikutnya”: Temukan elemen (biasanya tag anchor) yang memuat tautan ke halaman berikutnya. Gunakan pemilih CSS yang sesuai atau metode Beautiful Soup untuk mengambil atribut href dari elemen ini, yang merupakan URL halaman berikutnya.
- Ubah URL relatif menjadi URL absolut: Karena URL yang diambil mungkin bersifat relatif, gunakan fungsi
urljoindari pustakaurllib.parseuntuk mengubahnya menjadi URL absolut. - Buat perulangan: Terapkan perulangan yang menelusuri setiap halaman dan mengambil data yang diinginkan dari masing-masing halaman. Perulangan harus berlanjut sampai tidak ada lagi halaman yang tersisa, yang dapat diketahui dengan memeriksa apakah tautan halaman “Berikutnya” tersedia di halaman saat ini.
- Tambahkan jeda di antara permintaan: Untuk menghindari membebani server Amazon atau memicu langkah-langkah anti-bot, tambahkan jeda di antara permintaan menggunakan fungsi
time.sleep()dari pustakatime. Sesuaikan durasi jeda agar menyerupai perilaku penjelajahan manusia. - Menangani CAPTCHA dan pemblokiran: Jika Anda menemukan CAPTCHA atau pemblokiran IP saat mengambil data dari beberapa halaman, pertimbangkan untuk menggunakan proxy guna merotasi alamat IP atau alat dan layanan scraping khusus yang dapat menangani tantangan ini secara otomatis.
Di bawah ini, Anda akan menemukan tutorial video YouTube lengkap yang memandu Anda melalui proses mengekstrak data dari beberapa halaman di situs web Amazon. Tutorial ini membahas dunia web scraping secara mendalam, dengan berfokus pada teknik yang memungkinkan Anda mengumpulkan informasi berharga dari banyak halaman Amazon secara efisien dan efektif.
Sepanjang tutorial, presenter mendemonstrasikan penggunaan alat dan pustaka penting seperti Python, BeautifulSoup, dan requests, sekaligus menyoroti praktik terbaik agar tidak diblokir atau terdeteksi oleh mekanisme anti-bot Amazon. Video ini membahas topik penting seperti menangani paginasi, mengelola batas laju permintaan, dan meniru perilaku penjelajahan yang menyerupai manusia.
Selain petunjuk langkah demi langkah yang diberikan dalam video, tutorial ini juga membagikan kiat dan trik berguna untuk mengoptimalkan pengalaman web scraping Anda. Di antaranya adalah menggunakan proxy untuk melewati pembatasan IP, mengacak User-Agent dan header permintaan, serta menerapkan penanganan kesalahan yang tepat untuk memastikan proses scraping berjalan lancar tanpa gangguan.
Scraping Amazon: Tanya Jawab
Dalam hal mengekstrak data dari Amazon, platform e-commerce populer, ada beberapa hal yang perlu diperhatikan. Mari kita bahas pertanyaan yang sering diajukan terkait scraping data Amazon.
1. Apakah Scraping Amazon Legal?
Scraping data yang tersedia untuk umum dari internet legal, termasuk scraping Amazon. Anda dapat secara legal melakukan scraping informasi seperti detail produk, deskripsi, peringkat, dan harga. Namun, saat melakukan scraping ulasan produk, Anda harus berhati-hati dengan data pribadi dan perlindungan hak cipta. Misalnya, nama dan avatar pengulas dapat dianggap sebagai data pribadi, sedangkan teks ulasan mungkin dilindungi hak cipta. Selalu berhati-hati dan mintalah saran hukum saat melakukan scraping data semacam itu.
2. Apakah Amazon Mengizinkan Scraping?
Meskipun scraping data yang tersedia untuk umum legal, Amazon terkadang mengambil langkah untuk mencegah scraping. Langkah-langkah ini mencakup pembatasan laju permintaan, pemblokiran alamat IP, dan penggunaan sidik jari browser untuk mendeteksi bot scraping. Amazon biasanya memblokir web scraping dengan kode respons status keberhasilan 200 OK dan mengharuskan Anda melewati CAPTCHA atau menampilkan pesan HTTP Error 503 Service Unavailable yang meminta Anda menghubungi tim penjualan untuk mendapatkan API berbayar.
Ada cara untuk mengakali langkah-langkah ini, tetapi web scraping yang etis dapat membantu mencegah pemicuan langkah-langkah tersebut sejak awal. Web scraping yang etis mencakup pembatasan frekuensi permintaan, penggunaan user agent yang sesuai, dan menghindari scraping berlebihan yang dapat memengaruhi kinerja situs web. Dengan melakukan scraping secara etis, Anda dapat mengurangi risiko diblokir atau menghadapi konsekuensi hukum sekaligus tetap mengekstrak data yang berguna dari Amazon.
3. Apakah Scraping Data Amazon Etis?
Scraping secara etis berarti menghormati situs web yang menjadi target. Meskipun kecil kemungkinan Anda akan membebani situs web Amazon dengan terlalu banyak permintaan, Anda tetap harus mengikuti panduan scraping yang etis. Scraping yang etis dapat meminimalkan risiko menghadapi masalah hukum atau berurusan dengan langkah-langkah anti-scraping.
4. Bagaimana Cara Menghindari Pemblokiran Saat Melakukan Scraping Amazon?
Untuk menghindari pemblokiran saat melakukan scraping Amazon, Anda harus membatasi laju permintaan, menghindari scraping pada jam sibuk, menggunakan rotasi proxy cerdas, serta menggunakan user agent dan header yang sesuai agar tidak terdeteksi. Selain itu, ekstrak hanya data yang Anda perlukan dan gunakan alat scraping pihak ketiga atau pustaka scraping.
5. Apa Risiko Scraping Amazon?
Scraping data Amazon memiliki potensi risiko, seperti tindakan hukum dan penangguhan akun. Amazon menggunakan langkah-langkah anti-bot untuk mendeteksi dan mencegah scraping, termasuk pemblokiran alamat IP, pembatasan laju permintaan, dan sidik jari browser. Namun, dengan melakukan scraping secara etis, Anda dapat mengurangi risiko ini.
Kesimpulan
Saat kita keluar dari labirin web scraping Amazon yang memikat, inilah saatnya berhenti sejenak untuk mengapresiasi pengetahuan dan keterampilan tak ternilai yang telah kita kumpulkan dalam perjalanan yang mendebarkan ini. Dengan ProxyCompass sebagai pemandu tepercaya, Anda telah berhasil melewati lika-liku ekstraksi data berharga dari raksasa ritel tersebut. Saat melangkah maju dengan menggunakan keahlian baru Anda secara terampil, ingatlah bahwa rimba digital tak pernah berhenti berkembang.
Tetaplah ingin tahu, terus asah parang web scraping Anda, dan terus taklukkan lanskap ekstraksi data yang selalu berubah. Sampai ekspedisi penuh tantangan kita berikutnya, penjelajah pemberani, semoga petualangan berbasis data Anda membuahkan hasil dan membawa kepuasan!