
Hãy hình dung bạn là một nhà thám hiểm ưa phiêu lưu, dấn thân vào vương quốc Amazon rộng lớn và bí ẩn—không phải rừng mưa nhiệt đới, mà là gã khổng lồ bán lẻ trực tuyến. Mỗi lần nhấp chuột, bạn lại khám phá những kho báu vô giá, tiến sâu hơn vào vùng đất dữ liệu chưa được khai phá.
Trong chuyến thám hiểm đầy kịch tính này, chúng tôi mang đến hướng dẫn từng bước để bạn khám phá khu rừng kỹ thuật số rậm rạp của hoạt động thu thập dữ liệu web trên Amazon. Hãy chuẩn bị bắt đầu một hành trình có một không hai, với các mẹo và thủ thuật chuyên môn giúp trích xuất thông tin giá trị với độ chính xác chưa từng có.
Mục lục
- Nên thu thập dữ liệu nào từ Amazon
- Một số yêu cầu cơ bản
- Thiết lập để thu thập dữ liệu
- Thu thập thông tin sản phẩm trên Amazon
- Cách thu thập dữ liệu từ nhiều trang trên Amazon
- Thu thập dữ liệu Amazon: Câu hỏi thường gặp
- Kết luận
Vậy nên, hãy gom hết can đảm, xỏ đôi ủng ảo vào chân và cùng bắt đầu cuộc phiêu lưu dựa trên dữ liệu này nhé!
Nên thu thập dữ liệu nào từ Amazon
Có rất nhiều điểm dữ liệu liên quan đến một sản phẩm trên Amazon, nhưng những yếu tố chính cần tập trung khi thu thập dữ liệu gồm:
- Tên sản phẩm
- Giá
- Khoản tiết kiệm (nếu có)
- Tóm tắt sản phẩm
- Danh sách tính năng liên quan (nếu có)
- Điểm đánh giá
- Hình ảnh sản phẩm
Mặc dù đây là những khía cạnh chính cần cân nhắc khi thu thập dữ liệu về một mặt hàng trên Amazon, bạn cần lưu ý rằng thông tin trích xuất được có thể thay đổi tùy theo mục tiêu cụ thể của mình.
Một số yêu cầu cơ bản
Để nấu một món súp, chúng ta cần đúng nguyên liệu. Tương tự, trình thu thập dữ liệu web mới của chúng ta cần một số thành phần cụ thể.
- Python — Tính dễ sử dụng và bộ sưu tập thư viện phong phú khiến Python trở thành lựa chọn hàng đầu để thu thập dữ liệu web. Nếu bạn chưa cài đặt Python, hãy tham khảo hướng dẫn này.
- BeautifulSoup — Đây là một trong nhiều thư viện thu thập dữ liệu web hiện có cho Python. Sự đơn giản và cách sử dụng gọn gàng khiến thư viện này trở thành lựa chọn phổ biến để thu thập dữ liệu web. Sau khi cài đặt Python thành công, bạn có thể cài đặt Beautiful Soup bằng cách chạy: pip install bs4
- Kiến thức cơ bản về thẻ HTML — Hãy tham khảo hướng dẫn này để trang bị kiến thức cần thiết về các thẻ HTML.
- Trình duyệt web — Vì cần lọc bỏ nhiều thông tin không liên quan trên một trang web, nên cần có các ID và thẻ cụ thể để lọc. Một trình duyệt web như Google Chrome hoặc Mozilla Firefox sẽ hữu ích trong việc xác định các thẻ đó.
Chuẩn bị để thu thập dữ liệu
Để bắt đầu, hãy đảm bảo rằng bạn đã cài đặt Python. Nếu bạn chưa có Python 3.8 trở lên, hãy truy cập python.org để tải xuống và cài đặt phiên bản mới nhất.
Tiếp theo, hãy tạo một thư mục để lưu trữ các tệp mã thu thập dữ liệu web cho Amazon. Nhìn chung, bạn nên thiết lập môi trường ảo cho dự án của mình.
Sử dụng các lệnh sau để tạo và kích hoạt môi trường ảo trên macOS và Linux:
$ python3 -m venv .env $ source .env/bin/activateĐối với người dùng Windows, các lệnh sẽ hơi khác:
d:amazon>python -m venv .env d:amazon>.envscriptsactivateGiờ là lúc cài đặt các gói Python cần thiết.
Bạn sẽ cần các gói phục vụ hai nhiệm vụ chính: lấy HTML và phân tích cú pháp để trích xuất dữ liệu liên quan.
Thư viện Requests là một thư viện Python của bên thứ ba được sử dụng rộng rãi để gửi các yêu cầu HTTP. Thư viện này cung cấp giao diện đơn giản, thân thiện với người dùng để gửi yêu cầu HTTP đến máy chủ web và nhận phản hồi. Đây có lẽ là thư viện nổi tiếng nhất dùng cho thu thập dữ liệu web.
Tuy nhiên, thư viện Requests có một hạn chế: thư viện trả về phản hồi HTML dưới dạng chuỗi, khiến việc tìm kiếm các phần tử cụ thể như giá niêm yết trở nên khó khăn khi viết mã thu thập dữ liệu web.
Đó là lúc Beautiful Soup phát huy tác dụng. Beautiful Soup là một thư viện Python được thiết kế để thu thập dữ liệu web, giúp trích xuất dữ liệu từ các tệp HTML và XML. Thư viện cho phép bạn lấy thông tin từ một trang web bằng cách tìm kiếm thẻ, thuộc tính hoặc văn bản cụ thể.
Để cài đặt cả hai thư viện, hãy sử dụng lệnh sau:
$ python3 -m pip install requests beautifulsoup4Đối với người dùng Windows, hãy thay ‘python3’ bằng ‘python’, giữ nguyên phần còn lại của lệnh:
d:amazon>python -m pip install requests beautifulsoup4Lưu ý rằng chúng ta đang cài đặt phiên bản 4 của thư viện Beautiful Soup.
Giờ hãy kiểm tra thư viện Requests để thu thập dữ liệu. Tạo một tệp mới có tên amazon.py và nhập đoạn mã sau:
import requests url = ' https://www.amazon.com/Bose-QuietComfort-45-Bluetooth-Canceling-Headphones/dp/B098FKXT8L' response = requests.get(url) print(response.text)Lưu tệp và chạy tệp đó từ terminal.
$ python3 amazon.pyTrong hầu hết trường hợp, bạn sẽ không xem được HTML mong muốn. Amazon sẽ chặn yêu cầu và bạn sẽ nhận được phản hồi sau:
To discuss automated access to Amazon data please contact [email protected].Nếu in response.status_code, bạn sẽ thấy mình nhận được lỗi 503 thay vì mã thành công 200.
Amazon biết yêu cầu này không đến từ trình duyệt và chặn yêu cầu đó. Cách làm này khá phổ biến ở nhiều trang web. Amazon có thể chặn các yêu cầu của bạn và trả về mã lỗi bắt đầu bằng 500 hoặc đôi khi là 400.
Một giải pháp đơn giản là gửi kèm các header trong yêu cầu để mô phỏng những header mà trình duyệt gửi.
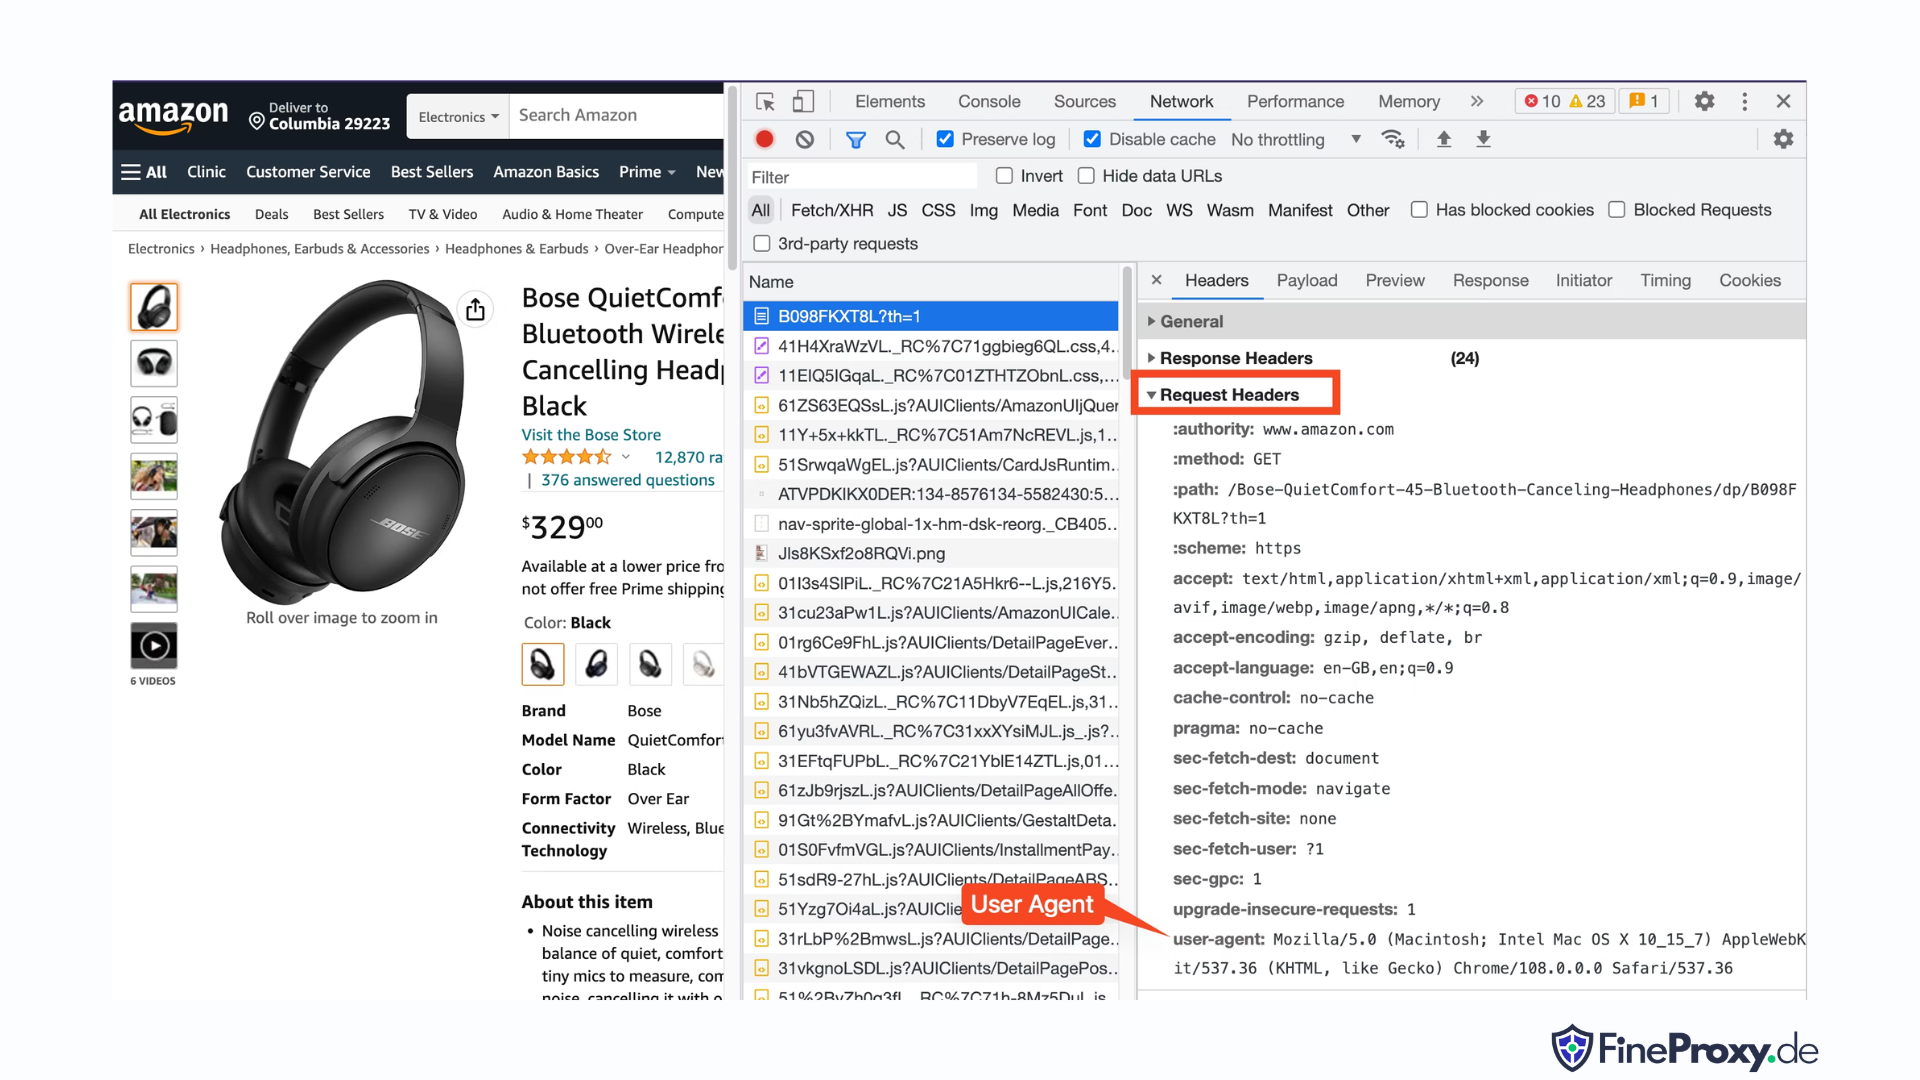
Đôi khi, chỉ gửi user-agent là đủ. Những lúc khác, bạn có thể cần gửi thêm các header, chẳng hạn như header accept-language.
Để tìm user-agent mà trình duyệt của bạn gửi, nhấn F12, mở thẻ Network và tải lại trang. Chọn yêu cầu đầu tiên rồi xem Request Headers.
Sao chép user-agent này và tạo một từ điển cho các header, như ví dụ sau với header user-agent và accept-language:
custom_headers = { ' user-agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/108.0.0.0 Safari/537.36', 'accept-language': 'en-GB,en;q=0.9', }Sau đó, bạn có thể gửi từ điển này dưới dạng tham số tùy chọn trong phương thức get:
response = requests.get(url, headers=custom_headersThu thập thông tin sản phẩm trên Amazon
Trong quá trình thu thập dữ liệu sản phẩm trên Amazon, thông thường bạn sẽ làm việc với hai loại trang: trang danh mục và trang chi tiết sản phẩm.
Ví dụ: truy cập https://www.amazon.com/b?node=12097479011 hoặc tìm kiếm Tai nghe chụp tai trên Amazon. Trang hiển thị kết quả tìm kiếm được gọi là trang danh mục.
Trang danh mục hiển thị tiêu đề sản phẩm, hình ảnh sản phẩm, đánh giá sản phẩm, giá sản phẩm và quan trọng nhất là URL của các sản phẩm. Để truy cập thêm thông tin, chẳng hạn như mô tả sản phẩm, bạn phải truy cập trang chi tiết sản phẩm.
Hãy cùng phân tích cấu trúc của trang chi tiết sản phẩm.
Mở URL của một sản phẩm, chẳng hạn như https://www.amazon.com/Bose-QuietComfort-45-Bluetooth-Canceling-Headphones/dp/B098FKXT8L, bằng Chrome hoặc một trình duyệt hiện đại khác. Nhấp chuột phải vào tiêu đề sản phẩm rồi chọn Inspect. Mã đánh dấu HTML của tiêu đề sản phẩm sẽ được làm nổi bật.
Bạn sẽ thấy đó là thẻ span có thuộc tính id được đặt thành “productTitle”.
Tương tự, nhấp chuột phải vào giá rồi chọn Inspect để xem mã đánh dấu HTML của giá.
Phần đô la của giá nằm trong thẻ span có class “a-price-whole”, còn phần xu nằm trong một thẻ span khác có class “a-price-fraction”.
Bạn cũng có thể tìm đánh giá, hình ảnh và mô tả theo cách tương tự.
Sau khi thu thập thông tin này, hãy thêm các dòng sau vào mã hiện có:
response = requests.get(url, headers=custom_headers) soup = BeautifulSoup(response.text, 'lxml')Beautiful Soup cung cấp một phương thức riêng để chọn thẻ bằng các phương thức find. Thư viện này cũng hỗ trợ bộ chọn CSS như một lựa chọn thay thế. Bạn có thể dùng một trong hai cách để đạt được cùng kết quả. Trong hướng dẫn này, chúng ta sẽ sử dụng bộ chọn CSS, một phương pháp phổ biến để chọn các phần tử. Bộ chọn CSS tương thích với hầu hết các công cụ thu thập dữ liệu web dùng để trích xuất thông tin sản phẩm trên Amazon.
Giờ đây, bạn đã sẵn sàng sử dụng đối tượng Soup để truy vấn thông tin cụ thể.
Trích xuất tên sản phẩm
Tên hoặc tiêu đề sản phẩm nằm trong phần tử span có id là ‘productTitle’. Việc chọn phần tử bằng id duy nhất rất đơn giản.
Hãy xem đoạn mã sau làm ví dụ:
title_element = soup.select_one('#productTitle')Chúng ta truyền bộ chọn CSS vào phương thức select_one, phương thức này trả về một thực thể phần tử.
Để trích xuất thông tin dạng văn bản, hãy sử dụng thuộc tính text.
title = title_element.textKhi in ra, bạn có thể nhận thấy một vài khoảng trắng. Để xử lý vấn đề này, hãy thêm lệnh gọi hàm .strip() như sau:
title = title_element.text.strip()Trích xuất đánh giá sản phẩm
Việc lấy đánh giá sản phẩm trên Amazon đòi hỏi thêm một vài thao tác.
Trước tiên, hãy xác định bộ chọn cho phần đánh giá:
#acrPopoverTiếp theo, dùng câu lệnh sau để chọn phần tử chứa đánh giá:
rating_element = soup.select_one('#acrPopover')Lưu ý rằng giá trị đánh giá thực tế nằm trong thuộc tính title:
rating_text = rating_element.attrs.get('title') print(rating_text) # prints '4.6 out of 5 stars'Cuối cùng, sử dụng phương thức replace để lấy giá trị đánh giá dạng số:
rating = rating_text.replace('out of 5 stars', '')Trích xuất giá sản phẩm
Giá sản phẩm có thể được tìm thấy ở hai vị trí — bên dưới tiêu đề sản phẩm và trong hộp Buy Now.
Bạn có thể dùng một trong hai thẻ này để thu thập giá sản phẩm trên Amazon.
Tạo bộ chọn CSS cho giá:
#price_inside_buyboxTruyền bộ chọn CSS này vào phương thức select_one của BeautifulSoup như sau:
price_element = soup.select_one('#price_inside_buybox')Bây giờ, bạn có thể in giá:
print(price_element.text)Trích xuất hình ảnh
Để thu thập hình ảnh mặc định, hãy dùng bộ chọn CSS #landingImage. Với thông tin này, bạn có thể viết các dòng mã sau để lấy URL hình ảnh từ thuộc tính src:
image_element = soup.select_one('#landingImage') image = image_element.attrs.get('src')Trích xuất mô tả sản phẩm
Bước tiếp theo để trích xuất dữ liệu sản phẩm trên Amazon là lấy mô tả sản phẩm.
Quy trình vẫn như cũ — tạo bộ chọn CSS và sử dụng phương thức select_one.
Bộ chọn CSS cho phần mô tả là:
#productDescriptionNhờ đó, chúng ta có thể trích xuất phần tử như sau:
description_element = soup.select_one('#productDescription') print(description_element.text)Xử lý danh sách sản phẩm
Chúng ta đã tìm hiểu cách thu thập thông tin sản phẩm, nhưng để truy cập dữ liệu sản phẩm, bạn cần bắt đầu từ trang danh sách sản phẩm hoặc trang danh mục.
Ví dụ: https://www.amazon.com/b?node=12097479011 là trang danh mục tai nghe chụp tai.
Nếu xem xét trang này, bạn sẽ thấy tất cả sản phẩm đều nằm trong một div có thuộc tính duy nhất [data-asin]. Bên trong div đó, tất cả liên kết sản phẩm đều nằm trong thẻ h2.
Với thông tin này, Bộ chọn CSS là:
[data-asin] h2 aBạn có thể đọc thuộc tính href của bộ chọn này rồi chạy một vòng lặp. Tuy nhiên, hãy nhớ rằng các liên kết sẽ là đường dẫn tương đối. Bạn cần dùng phương thức urljoin để phân tích các liên kết này.
from urllib.parse import urljoin ... def parse_listing(listing_url): … link_elements = soup_search.select("[data-asin] h2 a") page_data = [] for link in link_elements: full_url = urljoin(search_url, link.attrs.get("href")) product_info = get_product_info(full_url) page_data.append(product_info)Xử lý phân trang
Liên kết đến trang tiếp theo nằm trong một liên kết có nội dung “Next”. Bạn có thể tìm liên kết này bằng toán tử contains của CSS như sau:
next_page_el = soup.select_one('a:contains("Next")') if next_page_el: next_page_url = next_page_el.attrs.get('href') next_page_url = urljoin(listing_url, next_page_url)Xuất dữ liệu Amazon
Dữ liệu đã thu thập được cố ý trả về dưới dạng từ điển. Bạn có thể tạo một danh sách chứa tất cả sản phẩm đã thu thập.
def parse_listing(listing_url): ... page_data = [] for link in link_elements: ... product_info = get_product_info(full_url) page_data.append(product_info)Sau đó, bạn có thể dùng page_data để tạo một đối tượng Pandas DataFrame:
df = pd.DataFrame(page_data) df.to_csv('headphones.csv', index = False)Cách thu thập dữ liệu nhiều trang trên Amazon
Thu thập dữ liệu nhiều trang trên Amazon có thể nâng cao hiệu quả của dự án thu thập dữ liệu web bằng cách cung cấp bộ dữ liệu phong phú hơn để phân tích. Khi nhắm đến nhiều trang, bạn cần xem xét phân trang, tức là quá trình chia nội dung thành nhiều trang.
Dưới đây là 6 điểm chính cần ghi nhớ khi thu thập dữ liệu nhiều trang trên Amazon:
- Xác định kiểu phân trang: Trước tiên, hãy phân tích cấu trúc URL của trang danh mục hoặc trang kết quả tìm kiếm để hiểu cách Amazon phân trang nội dung. Đây có thể là một tham số truy vấn (ví dụ: “?page=2”) hoặc một mã định danh duy nhất được nhúng trong URL.
- Trích xuất liên kết trang “Tiếp theo”: Tìm phần tử (thường là thẻ neo) chứa liên kết đến trang tiếp theo. Sử dụng bộ chọn CSS thích hợp hoặc phương thức Beautiful Soup để trích xuất thuộc tính href của phần tử này, chính là URL của trang tiếp theo.
- Chuyển URL tương đối thành URL tuyệt đối: Vì các URL được trích xuất có thể là URL tương đối, hãy dùng hàm
urljointừ thư việnurllib.parseđể chuyển chúng thành URL tuyệt đối. - Tạo vòng lặp: Triển khai một vòng lặp để duyệt qua các trang và thu thập dữ liệu mong muốn từ từng trang. Vòng lặp sẽ tiếp tục cho đến khi không còn trang nào, có thể xác định bằng cách kiểm tra xem liên kết trang “Tiếp theo” có tồn tại trên trang hiện tại hay không.
- Thêm thời gian chờ giữa các yêu cầu: Để tránh gây quá tải cho máy chủ của Amazon hoặc kích hoạt các biện pháp chống bot, hãy thêm thời gian chờ giữa các yêu cầu bằng hàm
time.sleep()từ thư việntime. Điều chỉnh thời lượng chờ để mô phỏng hành vi duyệt web của con người. - Xử lý CAPTCHA và chặn truy cập: Nếu gặp CAPTCHA hoặc bị chặn IP khi thu thập dữ liệu nhiều trang, hãy cân nhắc sử dụng proxy để xoay vòng địa chỉ IP hoặc các công cụ và dịch vụ thu thập dữ liệu chuyên dụng có thể tự động xử lý những thách thức này.
Bên dưới, bạn sẽ tìm thấy video hướng dẫn toàn diện trên YouTube, chỉ dẫn quy trình trích xuất dữ liệu từ nhiều trang trên trang web của Amazon. Hướng dẫn này đi sâu vào lĩnh vực thu thập dữ liệu web, tập trung vào các kỹ thuật giúp bạn thu thập thông tin hữu ích từ nhiều trang Amazon một cách hiệu quả.
Trong suốt hướng dẫn, người thuyết trình minh họa cách sử dụng các công cụ và thư viện thiết yếu như Python, BeautifulSoup và requests, đồng thời nêu bật các phương pháp tốt nhất để tránh bị Amazon chặn hoặc phát hiện thông qua cơ chế chống bot. Video đề cập đến những chủ đề quan trọng như xử lý phân trang, quản lý giới hạn tần suất yêu cầu và mô phỏng hành vi duyệt web giống con người.
Bên cạnh hướng dẫn từng bước trong video, tài liệu hướng dẫn còn chia sẻ các mẹo và thủ thuật hữu ích để tối ưu hóa trải nghiệm thu thập dữ liệu web của bạn. Những mẹo này bao gồm sử dụng proxy để vượt qua các hạn chế IP, ngẫu nhiên hóa User-Agent và tiêu đề yêu cầu, cũng như triển khai xử lý lỗi phù hợp để đảm bảo quá trình thu thập dữ liệu diễn ra suôn sẻ, không bị gián đoạn.
Thu thập dữ liệu từ Amazon: Câu hỏi thường gặp
Khi trích xuất dữ liệu từ Amazon, một nền tảng thương mại điện tử phổ biến, có một số điều cần lưu ý. Hãy cùng tìm hiểu các câu hỏi thường gặp liên quan đến việc thu thập dữ liệu từ Amazon.
1. Thu thập dữ liệu từ Amazon có hợp pháp không?
Thu thập dữ liệu công khai trên internet là hợp pháp, trong đó có cả việc thu thập dữ liệu từ Amazon. Bạn có thể thu thập hợp pháp những thông tin như chi tiết sản phẩm, mô tả, xếp hạng và giá cả. Tuy nhiên, khi thu thập đánh giá sản phẩm, bạn nên thận trọng với dữ liệu cá nhân và vấn đề bảo hộ bản quyền. Ví dụ, tên và ảnh đại diện của người đánh giá có thể cấu thành dữ liệu cá nhân, trong khi nội dung bài đánh giá có thể được bảo hộ bản quyền. Luôn thận trọng và tìm tư vấn pháp lý khi thu thập loại dữ liệu này.
2. Amazon có cho phép thu thập dữ liệu không?
Mặc dù việc thu thập dữ liệu công khai là hợp pháp, đôi khi Amazon vẫn áp dụng các biện pháp để ngăn chặn hoạt động này. Những biện pháp đó bao gồm giới hạn tốc độ yêu cầu, cấm địa chỉ IP và sử dụng dấu vân tay trình duyệt để phát hiện bot thu thập dữ liệu. Amazon thường chặn hoạt động thu thập dữ liệu web bằng mã phản hồi thành công 200 OK và yêu cầu bạn vượt qua CAPTCHA, hoặc hiển thị thông báo HTTP Error 503 Service Unavailable để liên hệ bộ phận bán hàng về API trả phí.
Có những cách để vượt qua các biện pháp này, nhưng thu thập dữ liệu web có đạo đức có thể giúp bạn tránh kích hoạt chúng ngay từ đầu. Thu thập dữ liệu web có đạo đức bao gồm việc giới hạn tần suất yêu cầu, sử dụng user agent phù hợp và tránh thu thập dữ liệu quá mức có thể ảnh hưởng đến hiệu suất trang web. Bằng cách thu thập dữ liệu có đạo đức, bạn có thể giảm nguy cơ bị cấm hoặc phải đối mặt với hậu quả pháp lý mà vẫn trích xuất được dữ liệu hữu ích từ Amazon.
3. Thu thập dữ liệu từ Amazon có đạo đức không?
Thu thập dữ liệu có đạo đức nghĩa là tôn trọng trang web mục tiêu. Dù khả năng bạn làm quá tải trang web Amazon bằng quá nhiều yêu cầu là thấp, bạn vẫn nên tuân theo các nguyên tắc thu thập dữ liệu có đạo đức. Cách làm này có thể giảm thiểu nguy cơ gặp vấn đề pháp lý hoặc phải đối phó với các biện pháp chống thu thập dữ liệu.
4. Làm thế nào để tránh bị cấm khi thu thập dữ liệu từ Amazon?
Để tránh bị cấm khi thu thập dữ liệu từ Amazon, bạn nên giới hạn tần suất gửi yêu cầu, tránh thu thập dữ liệu vào giờ cao điểm, sử dụng tính năng xoay vòng proxy thông minh và dùng user agent cùng header phù hợp để tránh bị phát hiện. Ngoài ra, chỉ trích xuất dữ liệu bạn cần và sử dụng các công cụ hoặc thư viện thu thập dữ liệu của bên thứ ba.
5. Những rủi ro khi thu thập dữ liệu từ Amazon là gì?
Thu thập dữ liệu Amazon tiềm ẩn một số rủi ro, chẳng hạn như bị kiện và đình chỉ tài khoản. Amazon sử dụng các biện pháp chống bot để phát hiện và ngăn chặn hoạt động thu thập dữ liệu, bao gồm cấm địa chỉ IP, giới hạn tốc độ và lấy dấu vân tay trình duyệt. Tuy nhiên, bạn có thể giảm thiểu những rủi ro này bằng cách thu thập dữ liệu có đạo đức.
Kết luận
Khi đã thoát khỏi mê cung đầy mê hoặc của hoạt động thu thập dữ liệu web từ Amazon, đã đến lúc dừng lại một chút để trân trọng những kiến thức và kỹ năng quý giá mà chúng ta đã tích lũy được trong hành trình đầy hào hứng này. Với ProxyCompass làm người dẫn đường đáng tin cậy, bạn đã điều hướng thành công qua những khúc quanh co để trích xuất dữ liệu vô giá từ gã khổng lồ bán lẻ. Khi tiến bước, khéo léo vận dụng chuyên môn mới có được, hãy nhớ rằng khu rừng kỹ thuật số không ngừng biến đổi.
Hãy luôn tò mò, tiếp tục mài sắc con dao phát quang dùng để thu thập dữ liệu web và tiếp tục chinh phục bối cảnh trích xuất dữ liệu luôn thay đổi. Hẹn gặp lại trong chuyến thám hiểm táo bạo tiếp theo, nhà thám hiểm gan dạ, chúc những hành trình khai phá dữ liệu của bạn gặt hái thành quả và thành công!