
Imaginez-vous en explorateur aventureux, plongeant tête la première dans le vaste et mystérieux univers d’Amazon — non pas la forêt tropicale, mais le géant du commerce en ligne. À chaque clic, vous découvrez des trésors inestimables et vous aventurez plus profondément dans ce territoire inexploré de données.
Au cours de cette expédition palpitante, nous vous proposons un guide étape par étape pour naviguer dans la jungle numérique dense du scraping web sur Amazon. Préparez-vous à entreprendre un voyage hors du commun, armé de conseils et d’astuces d’experts pour extraire des informations précieuses avec une précision inégalée.
Table des matières
- Quelles données extraire d’Amazon
- Quelques exigences de base
- Préparer le scraping
- Extraire des informations sur les produits Amazon
- Comment extraire des données de plusieurs pages sur Amazon
- Scraper Amazon : FAQ
- Conclusion
Alors, rassemblez votre courage, chaussez vos bottes virtuelles et commençons ensemble notre aventure axée sur les données !
Quelles données extraire d’Amazon
Un produit Amazon est associé à de nombreux points de données, mais les principaux éléments à prendre en compte lors du scraping sont les suivants :
- Titre du produit
- Prix
- Économies (le cas échéant)
- Résumé de l’article
- Liste des caractéristiques associées (si disponible)
- Note des avis
- Visuels du produit
Bien qu’il s’agisse des principaux aspects à prendre en compte lors du scraping d’un article Amazon, il est important de noter que les informations que vous extrayez peuvent varier en fonction de vos objectifs précis.
Quelques exigences de base
Pour préparer une soupe, il nous faut les bons ingrédients. De même, notre nouveau scraper web nécessite des composants spécifiques.
- Python — Sa facilité d’utilisation et sa vaste collection de bibliothèques font de Python le choix privilégié pour le scraping web. S’il n’est pas déjà installé, consultez ce guide.
- BeautifulSoup — C’est l’une des nombreuses bibliothèques de scraping web disponibles pour Python. Sa simplicité et sa facilité d’utilisation en font un choix populaire pour le scraping web. Après avoir installé Python avec succès, vous pouvez installer Beautiful Soup en exécutant : pip install bs4
- Connaissances de base des balises HTML — Consultez ce tutoriel pour acquérir les connaissances nécessaires sur les balises HTML.
- Navigateur web — Comme nous devons filtrer une grande quantité d’informations non pertinentes d’un site web, des identifiants et des balises spécifiques sont nécessaires à cette fin. Un navigateur web comme Google Chrome ou Mozilla Firefox est utile pour identifier ces balises.
Configuration du scraping
Pour commencer, assurez-vous que Python est installé. Si vous ne disposez pas de Python 3.8 ou d’une version ultérieure, rendez-vous sur python.org pour télécharger et installer la dernière version.
Ensuite, créez un répertoire pour stocker vos fichiers de code de scraping Web pour Amazon. Il est généralement recommandé de configurer un environnement virtuel pour votre projet.
Utilisez les commandes suivantes pour créer et activer un environnement virtuel sous macOS et Linux :
$ python3 -m venv .env $ source .env/bin/activatePour les utilisateurs de Windows, les commandes sont légèrement différentes :
d:amazon>python -m venv .env d:amazon>.envscriptsactivateIl est maintenant temps d’installer les packages Python nécessaires.
Vous aurez besoin de packages pour deux tâches principales : récupérer le HTML et l’analyser afin d’en extraire les données pertinentes.
La bibliothèque Requests est une bibliothèque Python tierce très utilisée pour effectuer des requêtes HTTP. Elle offre une interface simple et conviviale pour envoyer des requêtes HTTP aux serveurs Web et recevoir leurs réponses. C’est sans doute la bibliothèque de scraping Web la plus connue.
Cependant, la bibliothèque Requests présente une limite : elle renvoie la réponse HTML sous forme de chaîne de caractères, ce qui peut rendre difficile la recherche d’éléments spécifiques, comme les prix des annonces, lors de l’écriture de code de scraping Web.
C’est là que Beautiful Soup intervient. Beautiful Soup est une bibliothèque Python conçue pour le scraping Web, qui extrait des données de fichiers HTML et XML. Elle vous permet de récupérer des informations d’une page Web en recherchant des balises, des attributs ou du texte spécifique.
Pour installer les deux bibliothèques, utilisez la commande suivante :
$ python3 -m pip install requests beautifulsoup4Pour les utilisateurs de Windows, remplacez « python3 » par « python », sans modifier le reste de la commande :
d:amazon>python -m pip install requests beautifulsoup4Notez que nous installons la version 4 de la bibliothèque Beautiful Soup.
Testons maintenant la bibliothèque de scraping Requests. Créez un nouveau fichier nommé amazon.py et saisissez le code suivant :
import requests url = ' https://www.amazon.com/Bose-QuietComfort-45-Bluetooth-Canceling-Headphones/dp/B098FKXT8L' response = requests.get(url) print(response.text)Enregistrez le fichier et exécutez-le depuis le terminal.
$ python3 amazon.pyDans la plupart des cas, vous ne pourrez pas afficher le HTML souhaité. Amazon bloquera la requête et vous recevrez la réponse suivante :
To discuss automated access to Amazon data please contact [email protected].Si vous affichez response.status_code, vous verrez que vous obtenez une erreur 503 au lieu d’un code de réussite 200.
Amazon sait que cette requête ne provient pas d’un navigateur et la bloque. Cette pratique est courante sur de nombreux sites Web. Amazon peut bloquer vos requêtes et renvoyer un code d’erreur commençant par 500, voire parfois par 400.
Une solution simple consiste à envoyer des en-têtes avec votre requête, en imitant ceux qu’envoie un navigateur.
Parfois, le user-agent suffit. D’autres fois, vous devrez peut-être envoyer des en-têtes supplémentaires, comme l’en-tête accept-language.
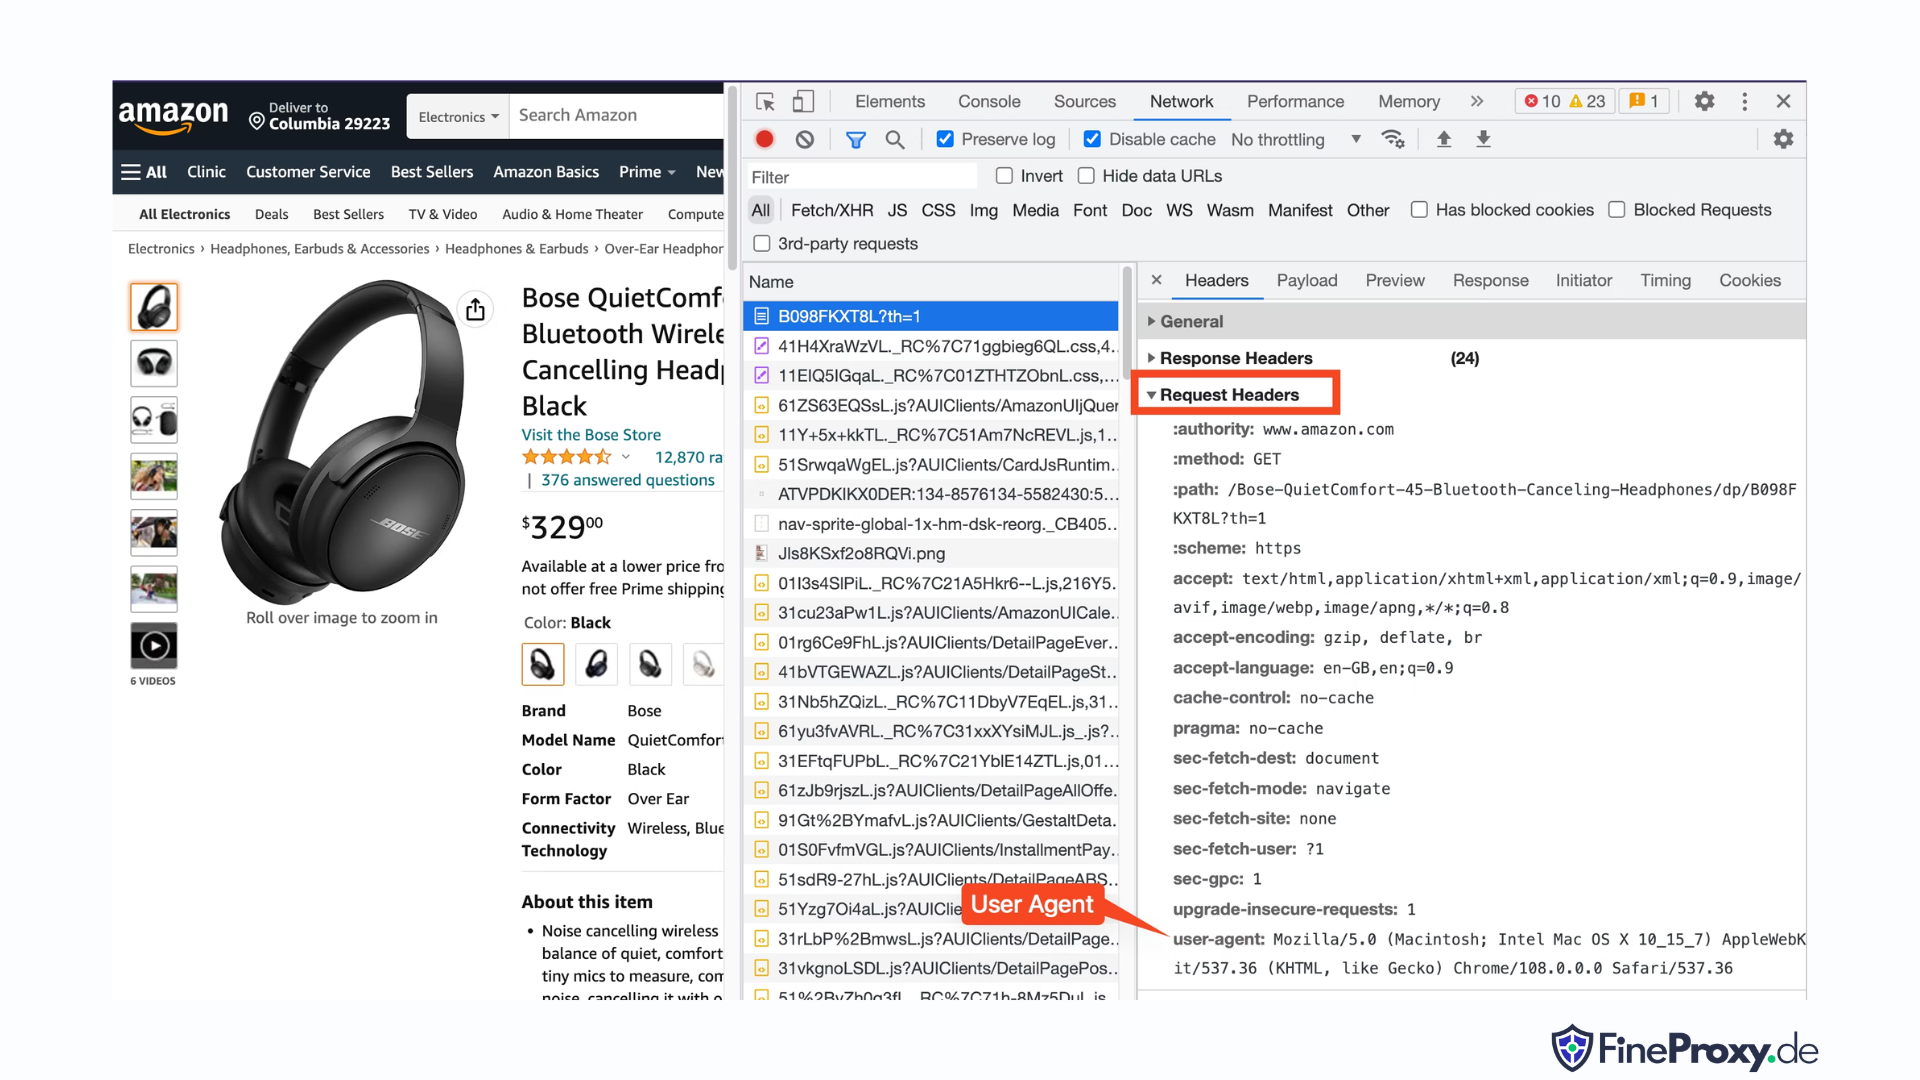
Pour trouver le user-agent envoyé par votre navigateur, appuyez sur F12, ouvrez l’onglet Network et rechargez la page. Sélectionnez la première requête et examinez les Request Headers.
Copiez ce user-agent et créez un dictionnaire pour les en-têtes, comme dans cet exemple avec les en-têtes user-agent et accept-language :
custom_headers = { ' user-agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/108.0.0.0 Safari/537.36', 'accept-language': 'en-GB,en;q=0.9', }Vous pouvez ensuite transmettre ce dictionnaire comme paramètre facultatif de la méthode get :
response = requests.get(url, headers=custom_headersExtraire les informations sur les produits Amazon
Lors de l’extraction des données des produits Amazon, vous consulterez généralement deux types de pages : la page de catégorie et la page de détails du produit.
Par exemple, rendez-vous sur https://www.amazon.com/b?node=12097479011 ou recherchez des casques circum-auriculaires sur Amazon. La page affichant les résultats de recherche est appelée page de catégorie.
La page de catégorie présente le titre du produit, son image, sa note, son prix et, surtout, l’URL de la page du produit. Pour accéder à davantage d’informations, comme les descriptions des produits, vous devez consulter la page de détails du produit.
Analysons la structure de la page de détails du produit.
Ouvrez une URL de produit, comme https://www.amazon.com/Bose-QuietComfort-45-Bluetooth-Canceling-Headphones/dp/B098FKXT8L, dans Chrome ou un autre navigateur moderne. Faites un clic droit sur le titre du produit et choisissez Inspecter. Le balisage HTML du titre du produit sera mis en surbrillance.
Vous remarquerez qu’il s’agit d’une balise span dont l’attribut id est défini sur « productTitle ».
De même, faites un clic droit sur le prix et sélectionnez Inspecter pour afficher le balisage HTML du prix.
La partie en dollars du prix se trouve dans une balise span avec la classe « a-price-whole », tandis que la partie en cents se trouve dans une autre balise span avec la classe « a-price-fraction ».
Vous pouvez également localiser la note, l’image et la description de la même manière.
Une fois ces informations recueillies, ajoutez les lignes suivantes au code existant :
response = requests.get(url, headers=custom_headers) soup = BeautifulSoup(response.text, 'lxml')Beautiful Soup propose une méthode particulière pour sélectionner les balises à l’aide des méthodes find. Elle prend également en charge les sélecteurs CSS comme solution de rechange. Vous pouvez utiliser l’une ou l’autre approche pour obtenir le même résultat. Dans ce tutoriel, nous utiliserons les sélecteurs CSS, une méthode universelle pour sélectionner des éléments. Les sélecteurs CSS sont compatibles avec presque tous les outils d’extraction de données Web permettant d’extraire des informations sur les produits Amazon.
Vous êtes maintenant prêt à utiliser l’objet Soup pour rechercher des informations précises.
Extraire le nom du produit
Le nom ou le titre du produit se trouve dans un élément span dont l’id est « productTitle ». La sélection d’éléments à l’aide d’identifiants uniques est simple.
Voici un exemple de code :
title_element = soup.select_one('#productTitle')Nous transmettons le sélecteur CSS à la méthode select_one, qui renvoie une instance d’élément.
Pour extraire les informations du texte, utilisez l’attribut text.
title = title_element.textLors de l’affichage, vous remarquerez peut-être quelques espaces blancs. Pour résoudre ce problème, ajoutez un appel à la fonction .strip() comme suit :
title = title_element.text.strip()Extraire les notes des produits
L’obtention des notes des produits Amazon nécessite quelques étapes supplémentaires.
Commencez par définir un sélecteur pour la note :
#acrPopoverEnsuite, utilisez l’instruction suivante pour sélectionner l’élément contenant la note :
rating_element = soup.select_one('#acrPopover')Notez que la valeur réelle de la note se trouve dans l’attribut title :
rating_text = rating_element.attrs.get('title') print(rating_text) # prints '4.6 out of 5 stars'Enfin, utilisez la méthode replace pour obtenir la note numérique :
rating = rating_text.replace('out of 5 stars', '')Extraire le prix du produit
Le prix du produit se trouve à deux endroits — sous le titre du produit et dans l’encadré « Acheter maintenant ».
Vous pouvez utiliser l’une ou l’autre de ces balises pour extraire les prix des produits Amazon.
Créez un sélecteur CSS pour le prix :
#price_inside_buyboxTransmettez ce sélecteur CSS à la méthode select_one de BeautifulSoup comme ceci :
price_element = soup.select_one('#price_inside_buybox')Vous pouvez maintenant afficher le prix :
print(price_element.text)Extraire l’image
Pour extraire l’image par défaut, utilisez le sélecteur CSS #landingImage. À l’aide de ces informations, vous pouvez écrire les lignes de code suivantes pour obtenir l’URL de l’image à partir de l’attribut src :
image_element = soup.select_one('#landingImage') image = image_element.attrs.get('src')Extraire la description du produit
L’étape suivante de l’extraction des données des produits Amazon consiste à obtenir la description du produit.
La procédure reste la même : créez un sélecteur CSS et utilisez la méthode select_one.
Le sélecteur CSS de la description est :
#productDescriptionCela nous permet d’extraire l’élément comme suit :
description_element = soup.select_one('#productDescription') print(description_element.text)Gérer les listes de produits
Nous avons vu comment extraire les informations sur les produits, mais vous devrez commencer par les pages de listes de produits ou de catégories pour accéder aux données des produits.
Par exemple, https://www.amazon.com/b?node=12097479011 est la page de catégorie des casques circum-auriculaires.
Si vous examinez cette page, vous verrez que tous les produits sont contenus dans une div dotée d’un attribut unique [data-asin]. Dans cette div, tous les liens des produits se trouvent dans une balise h2.
À partir de ces informations, le sélecteur CSS est :
[data-asin] h2 aVous pouvez lire l’attribut href de ce sélecteur et exécuter une boucle. Cependant, n’oubliez pas que les liens sont relatifs. Vous devrez utiliser la méthode urljoin pour analyser ces liens.
from urllib.parse import urljoin ... def parse_listing(listing_url): … link_elements = soup_search.select("[data-asin] h2 a") page_data = [] for link in link_elements: full_url = urljoin(search_url, link.attrs.get("href")) product_info = get_product_info(full_url) page_data.append(product_info)Gérer la pagination
Le lien vers la page suivante se trouve dans un lien contenant le texte « Suivant ». Vous pouvez rechercher ce lien à l’aide de l’opérateur contains de CSS, comme suit :
next_page_el = soup.select_one('a:contains("Next")') if next_page_el: next_page_url = next_page_el.attrs.get('href') next_page_url = urljoin(listing_url, next_page_url)Exporter les données Amazon
Les données extraites sont volontairement renvoyées sous forme de dictionnaire. Vous pouvez créer une liste contenant tous les produits extraits.
def parse_listing(listing_url): ... page_data = [] for link in link_elements: ... product_info = get_product_info(full_url) page_data.append(product_info)Vous pouvez ensuite utiliser cette page_data pour créer un objet Pandas DataFrame :
df = pd.DataFrame(page_data) df.to_csv('headphones.csv', index = False)Comment extraire des données de plusieurs pages sur Amazon
Extraire des données de plusieurs pages sur Amazon peut améliorer l’efficacité de votre projet de scraping Web en vous fournissant un ensemble de données plus vaste à analyser. Lorsque vous ciblez plusieurs pages, vous devez tenir compte de la pagination, qui consiste à répartir le contenu sur plusieurs pages.
Voici 6 points essentiels à garder à l’esprit lorsque vous extrayez des données de plusieurs pages sur Amazon :
- Identifiez le modèle de pagination : Commencez par analyser la structure des URL des pages de catégories ou de résultats de recherche afin de comprendre comment Amazon pagine son contenu. Il peut s’agir d’un paramètre de requête (par ex. « ?page=2 ») ou d’un identifiant unique intégré à l’URL.
- Extrayez le lien vers la page « Suivante » : Repérez l’élément (généralement une balise d’ancrage) contenant le lien vers la page suivante. Utilisez le sélecteur CSS approprié ou une méthode de Beautiful Soup pour extraire l’attribut href de cet élément, qui correspond à l’URL de la page suivante.
- Convertissez les URL relatives en URL absolues : Comme les URL extraites peuvent être relatives, utilisez la fonction
urljoinde la bibliothèqueurllib.parsepour les convertir en URL absolues. - Créez une boucle : Implémentez une boucle qui parcourt les pages et extrait les données souhaitées de chacune d’elles. La boucle doit continuer jusqu’à ce qu’il n’y ait plus de pages, ce que vous pouvez déterminer en vérifiant si le lien vers la page « Suivante » existe sur la page actuelle.
- Ajoutez des délais entre les requêtes : Pour éviter de surcharger le serveur d’Amazon ou de déclencher des mesures anti-robots, insérez des délais entre les requêtes à l’aide de la fonction
time.sleep()de la bibliothèquetime. Ajustez la durée du délai afin d’imiter le comportement de navigation d’un humain. - Gestion des CAPTCHA et des blocages : Si vous rencontrez des CAPTCHA ou des blocages d’adresse IP lors de l’extraction de données de plusieurs pages, envisagez d’utiliser des proxys pour faire tourner les adresses IP, ou des outils et services de scraping dédiés capables de gérer automatiquement ces difficultés.
Vous trouverez ci-dessous un tutoriel vidéo complet sur YouTube qui vous guide tout au long du processus d’extraction de données de plusieurs pages du site Web d’Amazon. Ce tutoriel explore en détail le scraping Web et se concentre sur des techniques qui vous permettront de recueillir efficacement des informations précieuses sur de nombreuses pages Amazon.
Tout au long du tutoriel, le présentateur montre comment utiliser des outils et bibliothèques essentiels, tels que Python, BeautifulSoup et requests, tout en mettant en avant les bonnes pratiques pour éviter d’être bloqué ou détecté par les mécanismes anti-robots d’Amazon. La vidéo aborde des sujets essentiels comme la gestion de la pagination, le respect des limites de débit et l’imitation d’un comportement de navigation humain.
En plus des instructions étape par étape fournies dans la vidéo, le tutoriel présente également des conseils et astuces utiles pour optimiser votre expérience de scraping Web. Il s’agit notamment d’utiliser des proxys pour contourner les restrictions d’adresse IP, de varier aléatoirement les en-têtes User-Agent et de requête, et de mettre en place une gestion appropriée des erreurs afin de garantir un processus d’extraction fluide et ininterrompu.
Scraper Amazon : FAQ
Lorsqu’il s’agit d’extraire des données d’Amazon, une plateforme de commerce électronique populaire, il convient de garder certaines choses à l’esprit. Explorons les questions fréquemment posées sur le scraping des données d’Amazon.
1. Est-il légal de scraper Amazon ?
Le scraping des données accessibles au public sur Internet est légal, y compris celui des données d’Amazon. Vous pouvez légalement scraper des informations telles que les détails des produits, les descriptions, les notes et les prix. Cependant, lorsque vous scrapez des avis sur les produits, vous devez faire preuve de prudence concernant les données personnelles et la protection des droits d’auteur. Par exemple, le nom et l’avatar de la personne qui a publié l’avis peuvent constituer des données personnelles, tandis que le texte de l’avis peut être protégé par le droit d’auteur. Faites toujours preuve de prudence et demandez conseil à un avocat lorsque vous scrapez de telles données.
2. Amazon autorise-t-il le scraping ?
Bien que le scraping des données accessibles au public soit légal, Amazon prend parfois des mesures pour l’empêcher. Ces mesures comprennent la limitation du débit des requêtes, le bannissement d’adresses IP et l’utilisation de l’empreinte numérique du navigateur pour détecter les robots de scraping. Amazon bloque généralement le scraping Web en renvoyant un code de réponse de succès 200 OK et exige que vous passiez un CAPTCHA, ou affiche un message d’erreur HTTP 503 Service Unavailable vous invitant à contacter le service commercial pour obtenir une API payante.
Il existe des moyens de contourner ces mesures, mais le scraping Web éthique peut vous aider à éviter de les déclencher. Le scraping Web éthique consiste à limiter la fréquence des requêtes, à utiliser des agents utilisateurs appropriés et à éviter un scraping excessif susceptible d’affecter les performances du site Web. En pratiquant le scraping de manière éthique, vous pouvez réduire le risque d’être banni ou de subir des conséquences juridiques, tout en continuant à extraire des données utiles d’Amazon.
3. Est-il éthique de scraper les données d’Amazon ?
Le scraping éthique implique de respecter le site Web ciblé. Même s’il est peu probable que vous surchargiez le site Web d’Amazon avec trop de requêtes, vous devriez tout de même suivre les bonnes pratiques en matière de scraping éthique. Le scraping éthique peut minimiser le risque de problèmes juridiques ou de mesures anti-scraping.
4. Comment éviter d’être banni lors du scraping d’Amazon ?
Pour éviter d’être banni lorsque vous scrapez Amazon, vous devriez limiter la fréquence de vos requêtes, éviter de scraper aux heures de pointe, utiliser une rotation intelligente des proxys et utiliser des agents utilisateurs et des en-têtes appropriés pour éviter d’être détecté. De plus, n’extrayez que les données dont vous avez besoin et utilisez des outils de scraping tiers ou des bibliothèques de scraping.
5. Quels sont les risques liés au scraping d’Amazon ?
Le scraping des données d’Amazon comporte des risques potentiels, tels que des poursuites judiciaires et la suspension de votre compte. Amazon utilise des mesures anti-robots pour détecter et empêcher le scraping, notamment le bannissement d’adresses IP, la limitation du débit et l’empreinte numérique du navigateur. Cependant, en pratiquant le scraping de manière éthique, vous pouvez atténuer ces risques.
Conclusion
Alors que nous sortons de l’envoûtant labyrinthe du scraping Web d’Amazon, prenons un instant pour apprécier les connaissances et les compétences inestimables acquises au cours de cette aventure exaltante. Avec ProxyCompass comme guide de confiance, vous avez réussi à naviguer dans les méandres de l’extraction de données inestimables auprès de ce géant de la vente au détail. Alors que vous poursuivez votre route en mettant à profit votre nouvelle expertise avec finesse, n’oubliez pas que la jungle numérique ne cesse d’évoluer.
Restez curieux, continuez à aiguiser votre machette de scraping Web et poursuivez votre conquête du paysage en constante évolution de l’extraction de données. Jusqu’à notre prochaine expédition audacieuse, intrépide explorateur, que vos quêtes guidées par les données soient fructueuses et gratifiantes !