
Imagínate como un explorador aventurero, lanzándote de cabeza al vasto y misterioso reino de Amazon, no la selva tropical, sino el gigante del comercio minorista en línea. Con cada clic, descubres tesoros invaluables y te adentras cada vez más en el territorio inexplorado de los datos.
En esta emocionante expedición, te presentamos una guía paso a paso para navegar por la densa jungla digital del scraping web de Amazon. Prepárate para emprender un viaje sin igual, con consejos y trucos de expertos para extraer información valiosa con una precisión inigualable.
Tabla de contenidos
- Qué datos extraer de Amazon
- Algunos requisitos básicos
- Preparativos para el scraping
- Extraer información de productos de Amazon
- Cómo extraer datos de varias páginas de Amazon
- Scraping de Amazon: preguntas frecuentes
- Conclusión
Así que reúne tu valor, ponte tus botas virtuales y ¡emprendamos juntos esta aventura basada en datos!
Qué datos extraer de Amazon
Hay numerosos datos asociados a un producto de Amazon, pero los elementos clave en los que debes centrarte al extraer información incluyen:
- Título del producto
- Precio
- Ahorro (cuando corresponda)
- Resumen del artículo
- Lista de características asociadas (si está disponible)
- Puntuación de las reseñas
- Imágenes del producto
Aunque estos son los principales aspectos que debes tener en cuenta al extraer información de un artículo de Amazon, es importante señalar que los datos que obtengas pueden variar según tus objetivos específicos.
Algunos requisitos básicos
Para preparar una sopa, necesitamos los ingredientes adecuados. Del mismo modo, nuestro nuevo scraper web requiere componentes específicos.
- Python — Su facilidad de uso y su extensa colección de bibliotecas hacen de Python la mejor opción para el scraping web. Si aún no está instalado, consulta esta guía.
- BeautifulSoup — Esta es una de las muchas bibliotecas de scraping web disponibles para Python. Su sencillez y facilidad de uso la convierten en una opción popular para el scraping web. Después de instalar Python correctamente, puedes instalar Beautiful Soup ejecutando: pip install bs4
- Conocimientos básicos de etiquetas HTML — Consulta este tutorial para adquirir los conocimientos necesarios sobre las etiquetas HTML.
- Navegador web — Como necesitamos filtrar mucha información irrelevante de un sitio web, se requieren identificadores y etiquetas específicos para hacerlo. Un navegador web como Google Chrome o Mozilla Firefox resulta útil para identificar esas etiquetas.
Configuración para la extracción de datos
Para empezar, asegúrate de tener Python instalado. Si no tienes Python 3.8 o posterior, visita python.org para descargar e instalar la versión más reciente.
A continuación, crea un directorio para guardar los archivos de código de extracción de datos web para Amazon. Por lo general, es buena idea configurar un entorno virtual para tu proyecto.
Usa los siguientes comandos para crear y activar un entorno virtual en macOS y Linux:
$ python3 -m venv .env $ source .env/bin/activatePara los usuarios de Windows, los comandos serán ligeramente diferentes:
d:amazon>python -m venv .env d:amazon>.envscriptsactivateAhora es el momento de instalar los paquetes de Python necesarios.
Necesitarás paquetes para dos tareas principales: obtener el HTML y analizarlo para extraer los datos relevantes.
La biblioteca Requests es una biblioteca de Python de terceros muy utilizada para realizar solicitudes HTTP. Ofrece una interfaz sencilla y fácil de usar para enviar solicitudes HTTP a servidores web y recibir respuestas. Es quizá la biblioteca más conocida para la extracción de datos web.
Sin embargo, la biblioteca Requests tiene una limitación: devuelve la respuesta HTML como una cadena, lo que puede dificultar la búsqueda de elementos específicos, como los precios de los productos, al escribir código para la extracción de datos web.
Ahí es donde entra Beautiful Soup. Beautiful Soup es una biblioteca de Python diseñada para la extracción de datos web que extrae datos de archivos HTML y XML. Te permite obtener información de una página web buscando etiquetas, atributos o texto específico.
Para instalar ambas bibliotecas, usa el siguiente comando:
$ python3 -m pip install requests beautifulsoup4Para los usuarios de Windows, sustituye ‘python3’ por ‘python’ y deja el resto del comando igual:
d:amazon>python -m pip install requests beautifulsoup4Ten en cuenta que estamos instalando la versión 4 de la biblioteca Beautiful Soup.
Ahora probemos la biblioteca Requests para la extracción de datos. Crea un archivo nuevo llamado amazon.py e introduce el siguiente código:
import requests url = ' https://www.amazon.com/Bose-QuietComfort-45-Bluetooth-Canceling-Headphones/dp/B098FKXT8L' response = requests.get(url) print(response.text)Guarda el archivo y ejecútalo desde la terminal.
$ python3 amazon.pyEn la mayoría de los casos, no podrás ver el HTML deseado. Amazon bloqueará la solicitud y recibirás la siguiente respuesta:
To discuss automated access to Amazon data please contact [email protected].Si imprimes response.status_code, verás que recibes un error 503 en lugar de un código de éxito 200.
Amazon sabe que esta solicitud no proviene de un navegador y la bloquea. Esta práctica es habitual en muchos sitios web. Amazon puede bloquear tus solicitudes y devolver un código de error que empiece por 500 o, a veces, incluso por 400.
Una solución sencilla es enviar encabezados con tu solicitud que imiten los enviados por un navegador.
A veces, basta con enviar solo el user-agent. Otras veces, puede que tengas que enviar encabezados adicionales, como el encabezado accept-language.
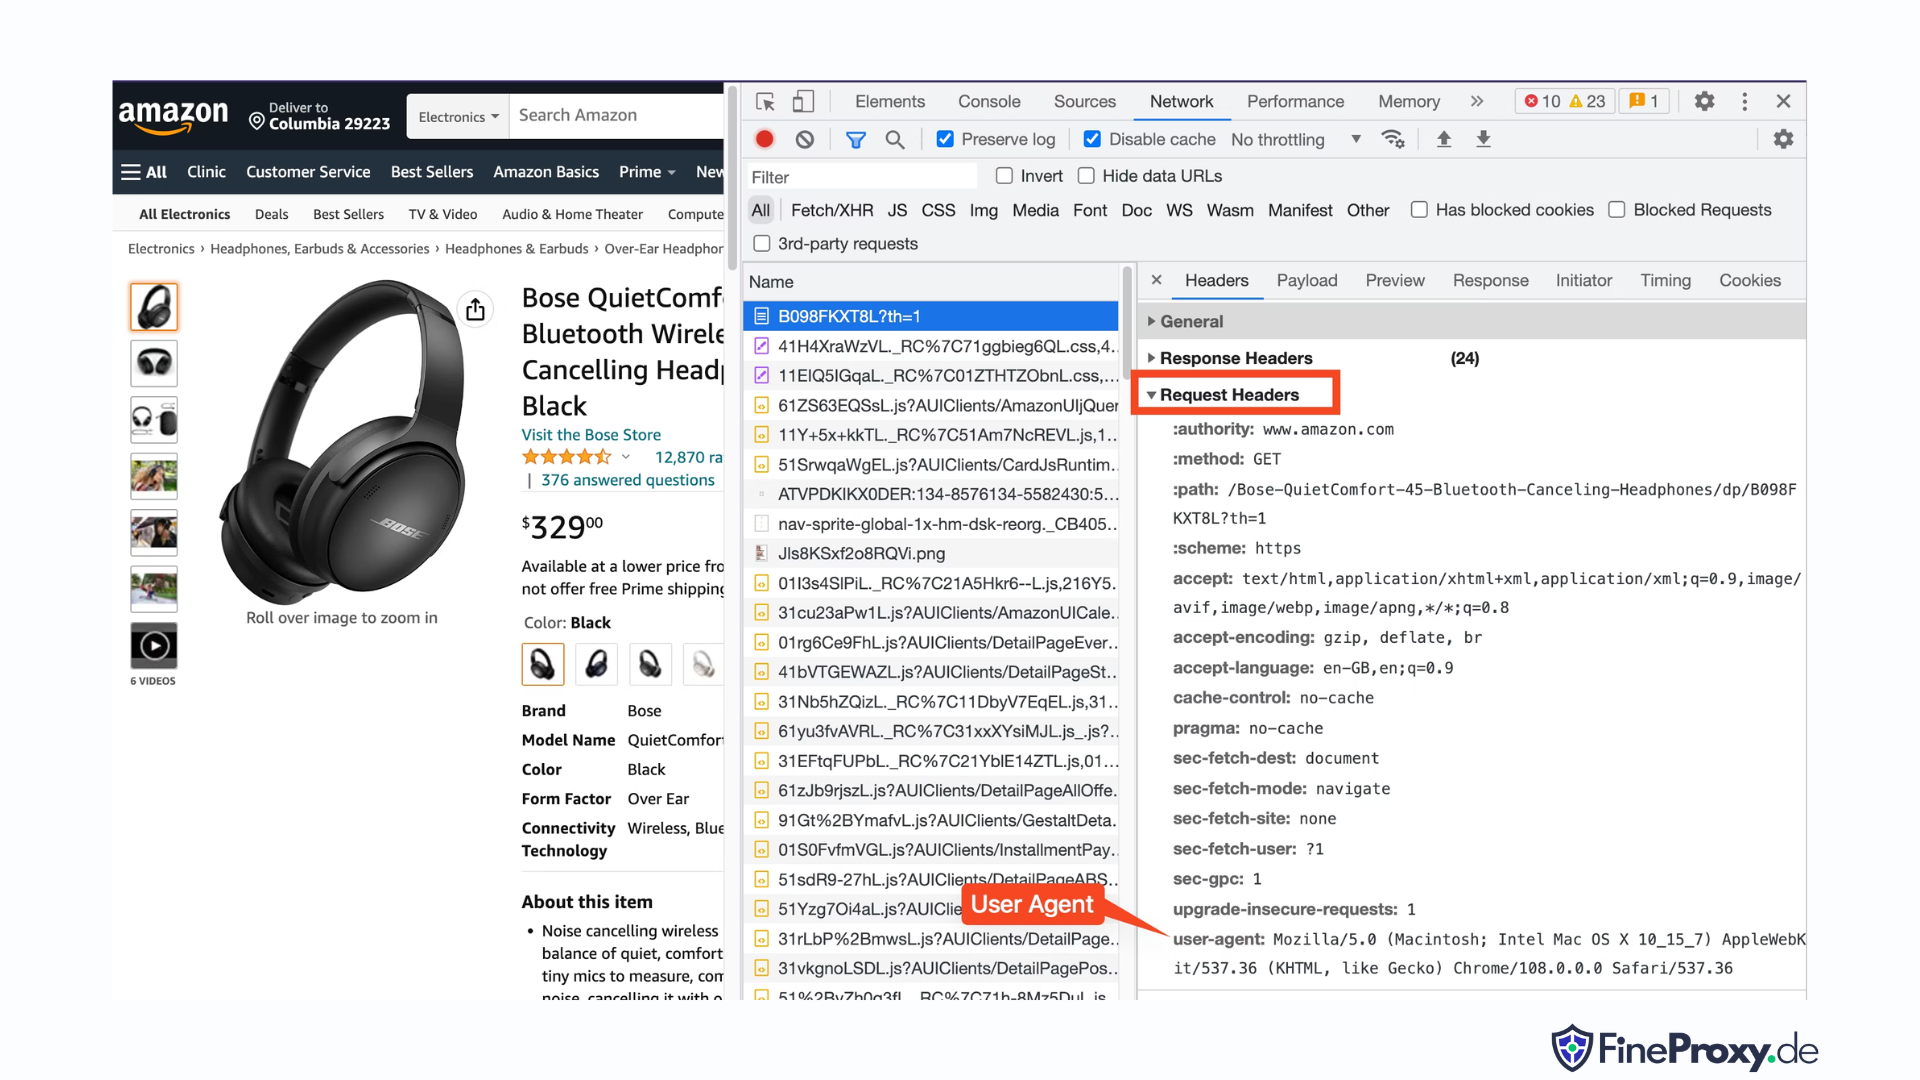
Para encontrar el user-agent enviado por tu navegador, pulsa F12, abre la pestaña Network y vuelve a cargar la página. Selecciona la primera solicitud y examina los Request Headers.
Copia este user-agent y crea un diccionario para los encabezados, como en este ejemplo con los encabezados user-agent y accept-language:
custom_headers = { ' user-agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/108.0.0.0 Safari/537.36', 'accept-language': 'en-GB,en;q=0.9', }Luego puedes enviar este diccionario como parámetro opcional en el método get:
response = requests.get(url, headers=custom_headersExtracción de información de productos de Amazon
Al extraer productos de Amazon mediante web scraping, normalmente interactuarás con dos tipos de páginas: la página de categoría y la página de detalles del producto.
Por ejemplo, visita https://www.amazon.com/b?node=12097479011 o busca auriculares supraaurales en Amazon. La página que muestra los resultados de búsqueda se conoce como página de categoría.
La página de categoría presenta el título del producto, la imagen del producto, la calificación del producto, el precio del producto y, lo más importante, la página con las URL de los productos. Para acceder a más información, como las descripciones de los productos, debes visitar la página de detalles del producto.
Analicemos la estructura de la página de detalles del producto.
Abre una URL de producto, como https://www.amazon.com/Bose-QuietComfort-45-Bluetooth-Canceling-Headphones/dp/B098FKXT8L, con Chrome u otro navegador moderno. Haz clic con el botón derecho en el título del producto y selecciona Inspeccionar. Se resaltará el marcado HTML del título del producto.
Verás que es una etiqueta span cuyo atributo id está establecido en “productTitle”.
Del mismo modo, haz clic con el botón derecho en el precio y selecciona Inspeccionar para ver el marcado HTML del precio.
El componente de dólares del precio está en una etiqueta span con la clase “a-price-whole”, mientras que el componente de centavos está en otra etiqueta span con la clase “a-price-fraction”.
También puedes localizar la calificación, la imagen y la descripción de la misma manera.
Una vez que hayas recopilado esta información, añade las siguientes líneas al código existente:
response = requests.get(url, headers=custom_headers) soup = BeautifulSoup(response.text, 'lxml')Beautiful Soup ofrece un método distinto para seleccionar etiquetas mediante los métodos find. También admite selectores CSS como alternativa. Puedes usar cualquiera de los dos métodos para obtener el mismo resultado. En este tutorial, utilizaremos selectores CSS, un método universal para seleccionar elementos. Los selectores CSS son compatibles con casi todas las herramientas de web scraping para extraer información de productos de Amazon.
Ahora ya puedes usar el objeto Soup para consultar información específica.
Extracción del nombre del producto
El nombre o título del producto se encuentra en un elemento span con el id ‘productTitle’. Seleccionar elementos usando ids únicos es sencillo.
Considera el siguiente código como ejemplo:
title_element = soup.select_one('#productTitle')Pasamos el selector CSS al método select_one, que devuelve una instancia del elemento.
Para extraer información del texto, usa el atributo text.
title = title_element.textAl imprimirlo, quizá observes algunos espacios en blanco. Para solucionarlo, añade una llamada a la función .strip() de la siguiente manera:
title = title_element.text.strip()Extracción de las calificaciones de los productos
Obtener las calificaciones de los productos de Amazon requiere un esfuerzo adicional.
Primero, define un selector para la calificación:
#acrPopoverA continuación, usa la siguiente instrucción para seleccionar el elemento que contiene la calificación:
rating_element = soup.select_one('#acrPopover')Ten en cuenta que el valor real de la calificación se encuentra dentro del atributo title:
rating_text = rating_element.attrs.get('title') print(rating_text) # prints '4.6 out of 5 stars'Por último, usa el método replace para obtener la calificación numérica:
rating = rating_text.replace('out of 5 stars', '')Extracción del precio del producto
El precio del producto se puede encontrar en dos lugares: debajo del título del producto y en el cuadro «Comprar ahora».
Cualquiera de estas etiquetas se puede utilizar para extraer mediante scraping los precios de los productos de Amazon.
Crea un selector CSS para el precio:
#price_inside_buyboxPasa este selector CSS al método select_one de BeautifulSoup de esta manera:
price_element = soup.select_one('#price_inside_buybox')Ahora puedes imprimir el precio:
print(price_element.text)Extracción de la imagen
Para extraer mediante scraping la imagen predeterminada, usa el selector CSS #landingImage. Con esta información, puedes escribir las siguientes líneas de código para obtener la URL de la imagen desde el atributo src:
image_element = soup.select_one('#landingImage') image = image_element.attrs.get('src')Extracción de la descripción del producto
El siguiente paso para extraer datos de productos de Amazon es obtener la descripción del producto.
El proceso sigue siendo el mismo: crea un selector CSS y usa el método select_one.
El selector CSS para la descripción es:
#productDescriptionEsto nos permite extraer el elemento de la siguiente manera:
description_element = soup.select_one('#productDescription') print(description_element.text)Gestión de listados de productos
Hemos explorado cómo extraer información de productos mediante scraping, pero tendrás que empezar por las páginas de listados de productos o de categorías para acceder a los datos de los productos.
Por ejemplo, https://www.amazon.com/b?node=12097479011 es la página de categoría de los auriculares supraaurales.
Si examinas esta página, verás que todos los productos están dentro de un div que tiene un atributo único [data-asin]. Dentro de ese div, todos los enlaces de los productos están en una etiqueta h2.
Con esta información, el selector CSS es:
[data-asin] h2 aPuedes leer el atributo href de este selector y ejecutar un bucle. Sin embargo, recuerda que los enlaces serán relativos. Tendrás que usar el método urljoin para analizar estos enlaces.
from urllib.parse import urljoin ... def parse_listing(listing_url): … link_elements = soup_search.select("[data-asin] h2 a") page_data = [] for link in link_elements: full_url = urljoin(search_url, link.attrs.get("href")) product_info = get_product_info(full_url) page_data.append(product_info)Gestión de la paginación
El enlace a la página siguiente está en un enlace que contiene el texto “Next”. Puedes buscar este enlace usando el operador contains de CSS de la siguiente manera:
next_page_el = soup.select_one('a:contains("Next")') if next_page_el: next_page_url = next_page_el.attrs.get('href') next_page_url = urljoin(listing_url, next_page_url)Exportación de datos de Amazon
Los datos extraídos se devuelven intencionalmente como un diccionario. Puedes crear una lista que contenga todos los productos extraídos.
def parse_listing(listing_url): ... page_data = [] for link in link_elements: ... product_info = get_product_info(full_url) page_data.append(product_info)Luego puedes usar este page_data para crear un objeto DataFrame de Pandas:
df = pd.DataFrame(page_data) df.to_csv('headphones.csv', index = False)Cómo extraer datos de varias páginas de Amazon
Extraer datos de varias páginas de Amazon puede mejorar la eficacia de tu proyecto de extracción web al proporcionarte un conjunto de datos más amplio para analizar. Al dirigirte a varias páginas, deberás tener en cuenta la paginación, que es el proceso de dividir el contenido en varias páginas.
Aquí tienes 6 puntos clave que debes tener en cuenta al extraer datos de varias páginas de Amazon:
- Identifica el patrón de paginación: Primero, analiza la estructura de las URL de las páginas de categorías o de resultados de búsqueda para entender cómo Amazon pagina su contenido. Puede tratarse de un parámetro de consulta (por ejemplo, “?page=2”) o de un identificador único incluido en la URL.
- Extrae el enlace a la página “Siguiente”: Localiza el elemento (normalmente una etiqueta de anclaje) que contiene el enlace a la página siguiente. Utiliza el selector CSS o el método de Beautiful Soup adecuado para extraer el atributo href de este elemento, que es la URL de la página siguiente.
- Convierte las URL relativas en URL absolutas: Como las URL extraídas podrían ser relativas, utiliza la función
urljoinde la bibliotecaurllib.parsepara convertirlas en URL absolutas. - Crea un bucle: Implementa un bucle que recorra las páginas y extraiga los datos deseados de cada una. El bucle debe continuar hasta que no queden más páginas, lo que puedes determinar comprobando si existe el enlace a la página “Siguiente” en la página actual.
- Añade pausas entre las solicitudes: Para evitar saturar el servidor de Amazon o activar medidas antibots, introduce pausas entre las solicitudes mediante la función
time.sleep()de la bibliotecatime. Ajusta la duración de la pausa para imitar el comportamiento de navegación de una persona. - Cómo gestionar los CAPTCHA y los bloqueos: Si te encuentras con CAPTCHA o bloqueos de IP al extraer datos de varias páginas, considera usar proxies para rotar las direcciones IP o herramientas y servicios de extracción especializados que puedan gestionar estos desafíos automáticamente.
A continuación encontrarás un completo tutorial en vídeo de YouTube que te guía por el proceso de extracción de datos de varias páginas del sitio web de Amazon. El tutorial profundiza en el mundo de la extracción web y se centra en técnicas que te permitirán recopilar información valiosa de numerosas páginas de Amazon de forma eficiente y eficaz.
A lo largo del tutorial, el presentador muestra cómo utilizar herramientas y bibliotecas esenciales, como Python, BeautifulSoup y requests, y destaca las prácticas recomendadas para evitar que Amazon te bloquee o detecte mediante sus mecanismos antibots. El vídeo trata temas esenciales como la gestión de la paginación y de los límites de frecuencia, así como la imitación del comportamiento de navegación de una persona.
Además de las instrucciones paso a paso del vídeo, el tutorial también comparte consejos y trucos útiles para optimizar tu experiencia de extracción web. Entre ellos se incluyen el uso de proxies para eludir las restricciones de IP, la aleatorización del User-Agent y de los encabezados de las solicitudes, y la implementación de una gestión adecuada de errores para garantizar un proceso de extracción fluido e ininterrumpido.
Scraping de Amazon: Preguntas frecuentes
Al extraer datos de Amazon, una popular plataforma de comercio electrónico, hay ciertos aspectos que se deben tener en cuenta. Veamos las preguntas frecuentes relacionadas con el scraping de datos de Amazon.
1. ¿Es legal hacer scraping de Amazon?
El scraping de datos disponibles públicamente en Internet es legal, y esto incluye hacer scraping de Amazon. Puedes extraer legalmente información como detalles de productos, descripciones, valoraciones y precios. Sin embargo, al hacer scraping de reseñas de productos, debes tener cuidado con los datos personales y la protección de los derechos de autor. Por ejemplo, el nombre y el avatar de quien escribe la reseña pueden constituir datos personales, mientras que el texto de la reseña puede estar protegido por derechos de autor. Actúa siempre con precaución y busca asesoramiento legal al extraer este tipo de datos.
2. ¿Amazon permite hacer scraping?
Aunque hacer scraping de datos disponibles públicamente es legal, Amazon a veces toma medidas para evitarlo. Estas medidas incluyen limitar la frecuencia de las solicitudes, bloquear direcciones IP y usar la huella digital del navegador para detectar bots de scraping. Amazon suele bloquear el web scraping con una respuesta de código de estado 200 OK y exige que completes un CAPTCHA o muestra un mensaje de error HTTP 503 Service Unavailable para que contactes con el equipo de ventas y contrates una API de pago.
Hay formas de eludir estas medidas, pero el web scraping ético puede ayudar a evitar que se activen desde el principio. El web scraping ético implica limitar la frecuencia de las solicitudes, usar agentes de usuario adecuados y evitar el scraping excesivo que podría afectar al rendimiento del sitio web. Si haces scraping de forma ética, puedes reducir el riesgo de que te bloqueen o de afrontar consecuencias legales y, aun así, extraer datos útiles de Amazon.
3. ¿Es ético hacer scraping de datos de Amazon?
Hacer scraping de forma ética implica respetar el sitio web de destino. Aunque es poco probable que sobrecargues el sitio web de Amazon con demasiadas solicitudes, aun así debes seguir las pautas de scraping ético. El scraping ético puede minimizar el riesgo de afrontar problemas legales o medidas contra el scraping.
4. ¿Cómo puedo evitar que me bloqueen al hacer scraping de Amazon?
Para evitar que te bloqueen al hacer scraping de Amazon, debes limitar la frecuencia de tus solicitudes, evitar hacer scraping durante las horas de mayor actividad, usar la rotación inteligente de proxies y emplear agentes de usuario y encabezados adecuados para evitar que te detecten. Además, extrae únicamente los datos que necesitas y usa herramientas de scraping de terceros o bibliotecas de scraping.
5. ¿Cuáles son los riesgos de hacer scraping de Amazon?
El scraping de datos de Amazon conlleva riesgos potenciales, como acciones legales y la suspensión de la cuenta. Amazon utiliza medidas antibots para detectar y evitar el scraping, como el bloqueo de direcciones IP, la limitación de la frecuencia de las solicitudes y la huella digital del navegador. Sin embargo, si haces scraping de forma ética, puedes mitigar estos riesgos.
Conclusión
Ahora que salimos del fascinante laberinto del web scraping de Amazon, es hora de hacer una pausa y apreciar los valiosos conocimientos y habilidades que hemos adquirido en este emocionante viaje. Con ProxyCompass como guía de confianza, has logrado sortear los giros y vueltas para extraer datos invaluables del gigante del comercio minorista. Al seguir adelante y aplicar con destreza tus nuevos conocimientos, recuerda que la jungla digital no deja de evolucionar.
Mantén la curiosidad, sigue afilando tu machete de web scraping y continúa conquistando el panorama siempre cambiante de la extracción de datos. Hasta nuestra próxima intrépida expedición, explorador audaz: ¡que tus aventuras basadas en datos sean fructíferas y gratificantes!