
تخيّل نفسك مستكشفًا مغامرًا، تغوص بكل حماسك في عالم أمازون الشاسع والغاميض — ليس الغابة المطيرة، بل عملاق تجارة التجزئة عبر الإنترنت. مع كل نقرة، تكشف كنوزًا لا تُقدّر بثمن، وتتعمق أكثر في أرض البيانات المجهولة.
في هذه الرحلة الاستكشافية المشوقة، نقدم دليلًا خطوة بخطوة للتنقل في غابة أمازون الرقمية الكثيفة واستخراج البيانات من الويب. استعد لخوض رحلة لا مثيل لها، مسلحًا بنصائح وحيل الخبراء لاستخراج معلومات قيّمة بدقة لا تضاهى.
جدول المحتويات
- ما البيانات التي ينبغي استخراجها من أمازون
- بعض المتطلبات الأساسية
- الإعداد لاستخراج البيانات
- استخراج معلومات المنتجات من أمازون
- كيفية استخراج البيانات من صفحات متعددة على أمازون
- استخراج البيانات من أمازون: الأسئلة الشائعة
- الخاتمة
لذا، اجمع شجاعتك، وانتعل حذاءك الافتراضي، ولنبدأ معًا مغامرتنا القائمة على البيانات!
ما البيانات التي ينبغي استخراجها من أمازون
ترتبط بمنتج أمازون نقاط بيانات عديدة، لكن العناصر الأساسية التي ينبغي التركيز عليها عند استخراج البيانات تشمل:
- عنوان المنتج
- التكلفة
- التوفير (عند انطباقه)
- ملخص المنتج
- قائمة الميزات المرتبطة (إن توفرت)
- تقييم المراجعات
- صور المنتج
على الرغم من أن هذه هي الجوانب الرئيسية التي ينبغي مراعاتها عند استخراج بيانات أحد منتجات أمازون، فمن المهم الإشارة إلى أن المعلومات التي تستخرجها قد تختلف بحسب أهدافك المحددة.
بعض المتطلبات الأساسية
لتحضير الحساء، نحتاج إلى المكونات المناسبة. وبالمثل، يتطلب برنامج استخراج البيانات الجديد لدينا مكونات محددة.
- Python — تجعل سهولة استخدام Python ومجموعتها الواسعة من المكتبات الخيار الأول لاستخراج البيانات من الويب. إذا لم تكن مثبتة بالفعل، فارجع إلى هذا الدليل.
- BeautifulSoup — هذه واحدة من مكتبات استخراج البيانات العديدة المتاحة لـ Python. تجعلها بساطتها وسهولة استخدامها خيارًا شائعًا لاستخراج البيانات من الويب. بعد تثبيت Python بنجاح، يمكنك تثبيت Beautiful Soup بتشغيل: pip install bs4
- فهم أساسي لوسوم HTML — راجع هذا البرنامج التعليمي لاكتساب المعرفة اللازمة حول وسوم HTML.
- متصفح ويب — نظرًا إلى حاجتنا إلى تصفية الكثير من المعلومات غير ذات الصلة من موقع ويب، نحتاج إلى معرّفات ووسوم محددة لأغراض التصفية. يفيد متصفح ويب مثل Google Chrome أو Mozilla Firefox في تحديد هذه الوسوم.
الإعداد لاستخراج البيانات من الويب
للبدء، تأكد من تثبيت Python لديك. إذا لم يكن لديك Python 3.8 أو إصدار أحدث، فتفضل بزيارة python.org لتنزيل أحدث إصدار وتثبيته.
بعد ذلك، أنشئ مجلدًا لتخزين ملفات التعليمات البرمجية الخاصة باستخراج البيانات من Amazon. ومن الجيد عمومًا إعداد بيئة افتراضية لمشروعك.
استخدم الأوامر التالية لإنشاء بيئة افتراضية وتفعيلها على macOS وLinux:
$ python3 -m venv .env $ source .env/bin/activateأما مستخدمو Windows، فستكون الأوامر مختلفة قليلًا:
d:amazon>python -m venv .env d:amazon>.envscriptsactivateحان الآن وقت تثبيت حزم Python اللازمة.
ستحتاج إلى حزم لتنفيذ مهمتين أساسيتين: الحصول على HTML وتحليله لاستخراج البيانات ذات الصلة.
مكتبة Requests هي مكتبة Python شائعة الاستخدام من جهة خارجية لإرسال طلبات HTTP. وتوفر واجهة مباشرة وسهلة الاستخدام لإرسال طلبات HTTP إلى خوادم الويب وتلقي الاستجابات. وربما تكون أشهر مكتبة لاستخراج البيانات من الويب.
لكن لمكتبة Requests أحد القيود: فهي تعيد استجابة HTML كسلسلة نصية، ما قد يجعل البحث عن عناصر محددة، مثل أسعار المنتجات المعروضة، أمرًا صعبًا عند كتابة تعليمات برمجية لاستخراج البيانات من الويب.
وهنا يأتي دور Beautiful Soup. Beautiful Soup هي مكتبة Python مصممة لاستخراج البيانات من الويب، وتستخرج البيانات من ملفات HTML وXML. وتتيح لك استرجاع المعلومات من صفحة ويب من خلال البحث عن الوسوم أو السمات أو نص محدد.
لتثبيت المكتبتين، استخدم الأمر التالي:
$ python3 -m pip install requests beautifulsoup4بالنسبة لمستخدمي Windows، استبدلوا ‘python3’ بـ ‘python’، مع إبقاء بقية الأمر كما هي:
d:amazon>python -m pip install requests beautifulsoup4لاحظ أننا نثبت الإصدار 4 من مكتبة Beautiful Soup.
لنختبر الآن مكتبة Requests لاستخراج البيانات. أنشئ ملفًا جديدًا باسم amazon.py وأدخل التعليمات البرمجية التالية:
import requests url = ' https://www.amazon.com/Bose-QuietComfort-45-Bluetooth-Canceling-Headphones/dp/B098FKXT8L' response = requests.get(url) print(response.text)احفظ الملف وشغّله من الطرفية.
$ python3 amazon.pyفي معظم الحالات، لن تتمكن من عرض HTML المطلوب. ستحظر Amazon الطلب، وستتلقى الاستجابة التالية:
To discuss automated access to Amazon data please contact [email protected].إذا طبعت response.status_code، فسترى أنك تتلقى خطأ 503 بدلًا من رمز النجاح 200.
تعرف Amazon أن هذا الطلب لم يأتِ من متصفح، فتحظره. وهذه ممارسة شائعة لدى العديد من المواقع. قد تحظر Amazon طلباتك وتعيد رمز خطأ يبدأ بـ 500 أو أحيانًا حتى بـ 400.
ومن الحلول البسيطة إرسال ترويسات مع طلبك تحاكي تلك التي يرسلها المتصفح.
في بعض الأحيان، يكفي إرسال user-agent فقط. وفي أحيان أخرى، قد تحتاج إلى إرسال ترويسات إضافية، مثل ترويسة accept-language.
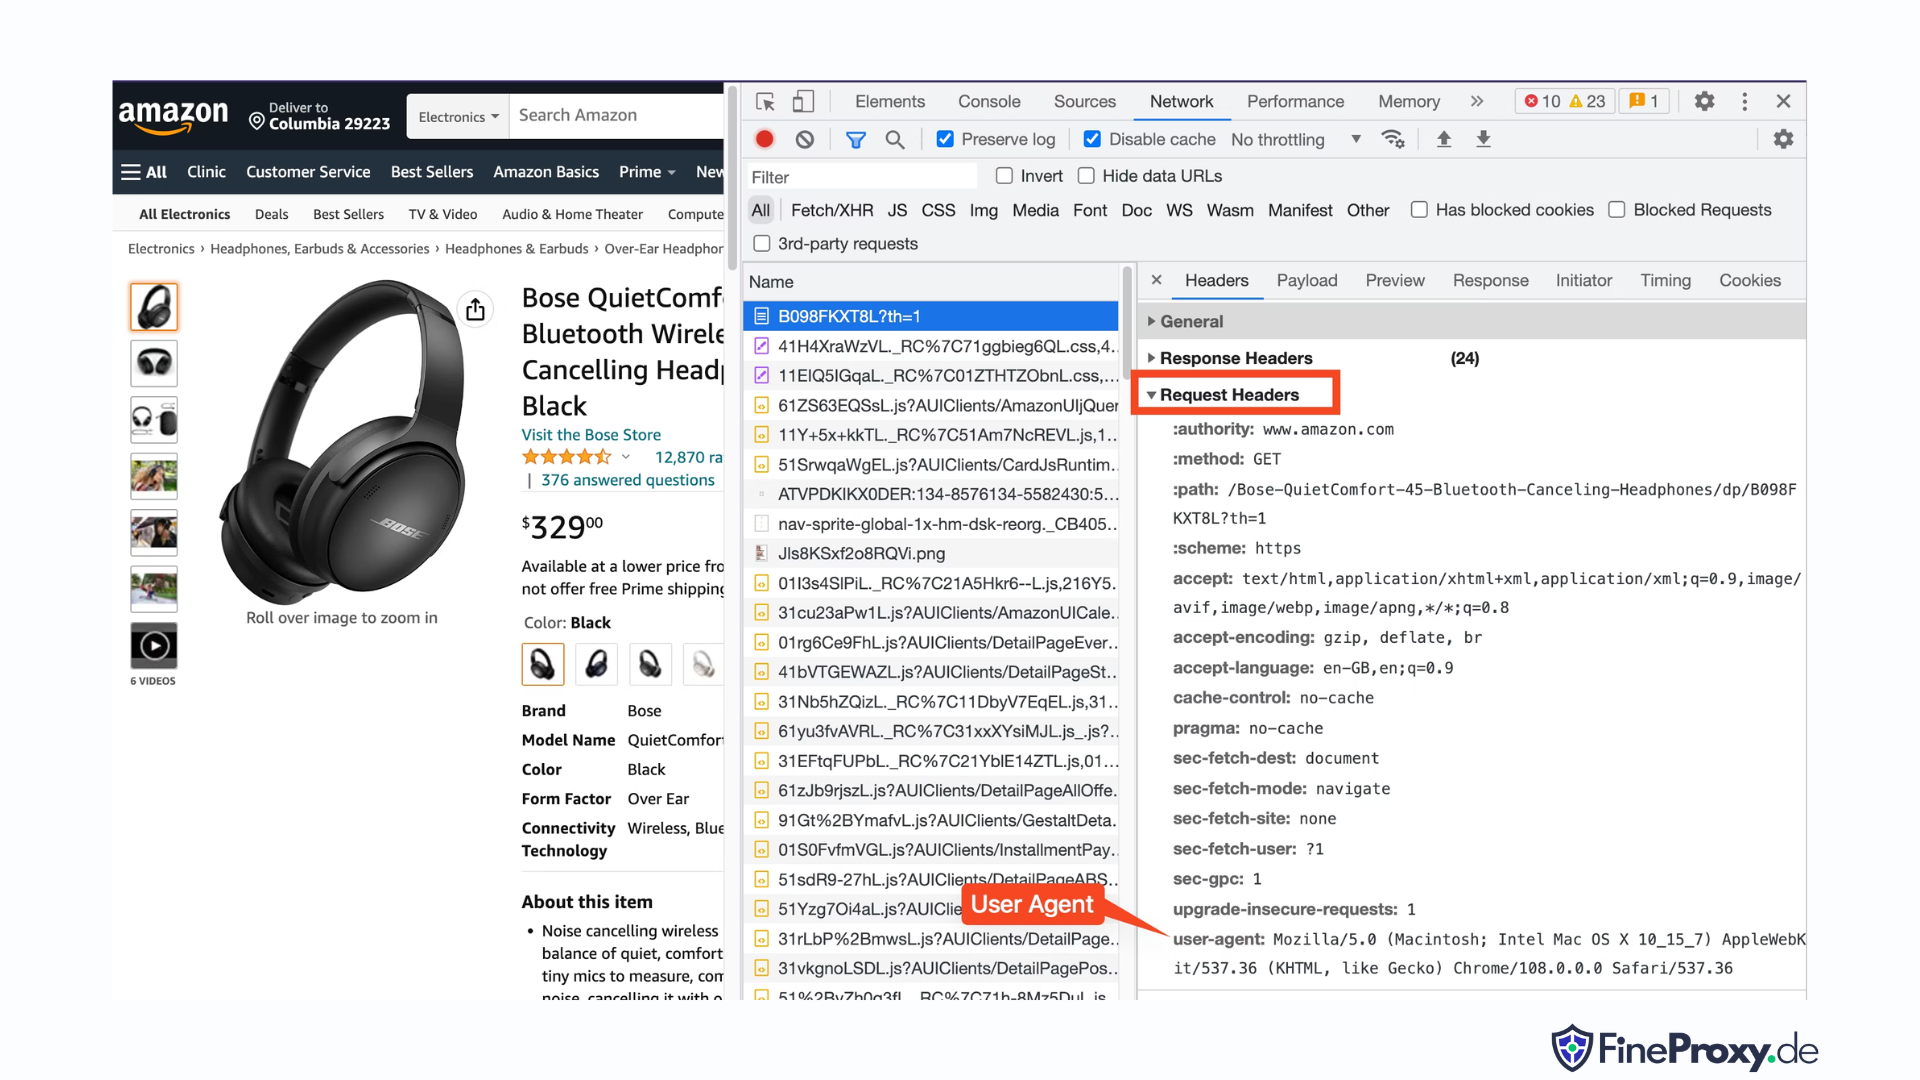
للعثور على user-agent الذي يرسله متصفحك، اضغط على F12، وافتح تبويب Network، ثم أعد تحميل الصفحة. حدد الطلب الأول وافحص Request Headers.
انسخ user-agent هذا وأنشئ قاموسًا للترويسات، كما في هذا المثال الذي يتضمن ترويستي user-agent وaccept-language:
custom_headers = { ' user-agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/108.0.0.0 Safari/537.36', 'accept-language': 'en-GB,en;q=0.9', }يمكنك بعد ذلك إرسال هذا القاموس بوصفه معلمة اختيارية في الدالة get:
response = requests.get(url, headers=custom_headersاستخراج معلومات منتجات Amazon
أثناء عملية استخراج بيانات منتجات Amazon من الويب، ستتعامل عادةً مع نوعين من الصفحات: صفحة الفئة وصفحة تفاصيل المنتج.
على سبيل المثال، تفضل بزيارة https://www.amazon.com/b?node=12097479011 أو ابحث عن سماعات رأس فوق الأذن على Amazon. تُعرف الصفحة التي تعرض نتائج البحث باسم صفحة الفئة.
تعرض صفحة الفئة عنوان المنتج وصورته وتقييمه وسعره، والأهم من ذلك، روابط صفحات المنتجات. للوصول إلى مزيد من المعلومات، مثل أوصاف المنتجات، يجب زيارة صفحة تفاصيل المنتج.
لنحلل بنية صفحة تفاصيل المنتج.
افتح رابط منتج، مثل https://www.amazon.com/Bose-QuietComfort-45-Bluetooth-Canceling-Headphones/dp/B098FKXT8L، باستخدام Chrome أو متصفح حديث آخر. انقر بزر الفأرة الأيمن على عنوان المنتج واختر Inspect. سيُبرز ترميز HTML الخاص بعنوان المنتج.
ستلاحظ أنه عنصر span سمة id فيه مضبوطة على “productTitle”.
وبالمثل، انقر بزر الفأرة الأيمن على السعر واختر Inspect لعرض ترميز HTML الخاص بالسعر.
يوجد جزء الدولار من السعر في عنصر span ذي الفئة “a-price-whole”، بينما يوجد جزء السنتات في عنصر span آخر ذي الفئة “a-price-fraction”.
يمكنك أيضًا العثور على التقييم والصورة والوصف بالطريقة نفسها.
بعد جمع هذه المعلومات، أضف الأسطر التالية إلى الشيفرة الحالية:
response = requests.get(url, headers=custom_headers) soup = BeautifulSoup(response.text, 'lxml')تتيح Beautiful Soup طريقة مميزة لاختيار العناصر باستخدام دوال find. كما تدعم محددات CSS كبديل. يمكنك استخدام أي من الطريقتين للوصول إلى النتيجة نفسها. في هذا البرنامج التعليمي، سنستخدم محددات CSS، وهي طريقة عامة لاختيار العناصر. تتوافق محددات CSS مع جميع أدوات استخراج بيانات الويب تقريبًا لاستخراج معلومات منتجات Amazon.
أصبحت الآن مستعدًا لاستخدام كائن Soup للاستعلام عن معلومات محددة.
استخراج اسم المنتج
يوجد اسم المنتج أو عنوانه في عنصر span ذي المعرّف ‘productTitle’. ويُعد اختيار العناصر باستخدام معرّفات فريدة أمرًا بسيطًا.
انظر إلى الشيفرة التالية كمثال:
title_element = soup.select_one('#productTitle')نمرر محدد CSS إلى الدالة select_one، التي تُعيد مثيلًا للعنصر.
لاستخراج المعلومات من النص، استخدم سمة text.
title = title_element.textعند طباعة القيمة، قد تلاحظ وجود بعض المسافات البيضاء. لمعالجة ذلك، أضف استدعاء الدالة .strip() كما يلي:
title = title_element.text.strip()استخراج تقييمات المنتجات
يتطلب الحصول على تقييمات منتجات Amazon بعض الجهد الإضافي.
أولًا، أنشئ محددًا للتقييم:
#acrPopoverبعد ذلك، استخدم العبارة التالية لتحديد العنصر الذي يحتوي على التقييم:
rating_element = soup.select_one('#acrPopover')لاحظ أن قيمة التقييم الفعلية موجودة داخل سمة title:
rating_text = rating_element.attrs.get('title') print(rating_text) # prints '4.6 out of 5 stars'وأخيرًا، استخدم الدالة replace للحصول على التقييم الرقمي:
rating = rating_text.replace('out of 5 stars', '')استخراج سعر المنتج
يمكن العثور على سعر المنتج في موضعين — أسفل عنوان المنتج وداخل مربع الشراء الآن.
يمكن استخدام أي من هذين العنصرين لاستخراج أسعار منتجات Amazon.
أنشئ محدد CSS للسعر:
#price_inside_buyboxمرر محدد CSS هذا إلى الدالة select_one في BeautifulSoup كما يلي:
price_element = soup.select_one('#price_inside_buybox')يمكنك الآن طباعة السعر:
print(price_element.text)استخراج الصورة
لاستخراج الصورة الافتراضية، استخدم محدد CSS #landingImage. وباستخدام هذه المعلومات، يمكنك كتابة أسطر الشيفرة التالية للحصول على عنوان URL للصورة من سمة src:
image_element = soup.select_one('#landingImage') image = image_element.attrs.get('src')استخراج وصف المنتج
الخطوة التالية في استخراج بيانات منتجات Amazon هي الحصول على وصف المنتج.
تبقى العملية كما هي — أنشئ محدد CSS واستخدم الدالة select_one.
محدد CSS الخاص بالوصف هو:
#productDescriptionيسمح لنا ذلك باستخراج العنصر كما يلي:
description_element = soup.select_one('#productDescription') print(description_element.text)التعامل مع قوائم المنتجات
استكشفنا استخراج معلومات المنتجات، لكن ستحتاج إلى البدء بصفحات قوائم المنتجات أو صفحات الفئات للوصول إلى بيانات المنتجات.
على سبيل المثال، https://www.amazon.com/b?node=12097479011 هي صفحة الفئة الخاصة بسماعات الرأس فوق الأذن.
إذا فحصت هذه الصفحة، فسترى أن جميع المنتجات مضمنة داخل عنصر div له سمة فريدة [data-asin]. وداخل عنصر div هذا، توجد جميع روابط المنتجات في عنصر h2.
باستخدام هذه المعلومات، يكون محدد CSS كما يلي:
[data-asin] h2 aيمكنك قراءة سمة href لهذا المحدد وتشغيل حلقة تكرارية. لكن تذكر أن الروابط ستكون نسبية. ستحتاج إلى استخدام الدالة urljoin لتحليل هذه الروابط.
from urllib.parse import urljoin ... def parse_listing(listing_url): … link_elements = soup_search.select("[data-asin] h2 a") page_data = [] for link in link_elements: full_url = urljoin(search_url, link.attrs.get("href")) product_info = get_product_info(full_url) page_data.append(product_info)التعامل مع ترقيم الصفحات
يوجد رابط الصفحة التالية في عنصر link يتضمن النص “التالي”. يمكنك البحث عن هذا الرابط باستخدام عامل contains في CSS كما يلي:
next_page_el = soup.select_one('a:contains("Next")') if next_page_el: next_page_url = next_page_el.attrs.get('href') next_page_url = urljoin(listing_url, next_page_url)تصدير بيانات Amazon
تُعاد البيانات المستخرجة على هيئة قاموس عمدًا. يمكنك إنشاء قائمة تحتوي على جميع المنتجات المستخرجة.
def parse_listing(listing_url): ... page_data = [] for link in link_elements: ... product_info = get_product_info(full_url) page_data.append(product_info)يمكنك بعد ذلك استخدام page_data لإنشاء كائن DataFrame من Pandas:
df = pd.DataFrame(page_data) df.to_csv('headphones.csv', index = False)كيفية استخراج البيانات من صفحات متعددة على Amazon
يمكن أن يؤدي استخراج البيانات من صفحات متعددة على Amazon إلى تعزيز فعالية مشروع استخراج بيانات الويب من خلال توفير مجموعة بيانات أوسع لتحليلها. عند استهداف صفحات متعددة، ستحتاج إلى مراعاة ترقيم الصفحات، وهي عملية تقسيم المحتوى عبر عدة صفحات.
إليك 6 نقاط أساسية يجب وضعها في الاعتبار عند استخراج البيانات من صفحات متعددة على Amazon:
- تحديد نمط ترقيم الصفحات: أولاً، حلّل بنية عنوان URL لصفحات الفئات أو نتائج البحث لفهم كيفية تقسيم Amazon لمحتواها إلى صفحات. قد يكون ذلك معلمة استعلام (مثل “?page=2”) أو معرّفاً فريداً مضمنًا في عنوان URL.
- استخراج رابط الصفحة «التالية»: حدّد العنصر (عادةً وسم ارتساء) الذي يحتوي على رابط الصفحة التالية. استخدم محدد CSS المناسب أو طريقة Beautiful Soup لاستخراج سمة href لهذا العنصر، وهي عنوان URL للصفحة التالية.
- تحويل عناوين URL النسبية إلى عناوين URL مطلقة: نظراً إلى أن عناوين URL المستخرجة قد تكون نسبية، استخدم الدالة
urljoinمن مكتبةurllib.parseلتحويلها إلى عناوين URL مطلقة. - إنشاء حلقة تكرار: نفّذ حلقة تكرار تنتقل بين الصفحات، وتستخرج البيانات المطلوبة من كل صفحة. ينبغي أن تستمر الحلقة حتى نفاد الصفحات، ويمكن تحديد ذلك بالتحقق مما إذا كان رابط الصفحة «التالية» موجوداً في الصفحة الحالية.
- إضافة فواصل زمنية بين الطلبات: لتجنب إثقال خادم Amazon أو تشغيل إجراءات مكافحة الروبوتات، أضف فواصل زمنية بين الطلبات باستخدام الدالة
time.sleep()من مكتبةtime. اضبط مدة التأخير لمحاكاة سلوك التصفح البشري. - التعامل مع اختبارات CAPTCHA والحظر: إذا واجهت اختبارات CAPTCHA أو حظر عناوين IP أثناء استخراج البيانات من صفحات متعددة، ففكّر في استخدام بروكسيات لتدوير عناوين IP أو أدوات وخدمات مخصصة لاستخراج البيانات يمكنها التعامل مع هذه التحديات تلقائياً.
فيما يلي فيديو تعليمي شامل على YouTube يرشدك خلال عملية استخراج البيانات من صفحات متعددة على موقع Amazon. يتعمق البرنامج التعليمي في عالم استخراج بيانات الويب، مع التركيز على التقنيات التي ستمكّنك من جمع معلومات قيّمة من صفحات Amazon عديدة بكفاءة وفعالية.
على امتداد البرنامج التعليمي، يوضّح مقدّم الفيديو استخدام الأدوات والمكتبات الأساسية، مثل Python وBeautifulSoup وrequests، مع تسليط الضوء على أفضل الممارسات لتجنب الحظر أو اكتشاف Amazon لعملية الاستخراج عبر آليات مكافحة الروبوتات. يغطي الفيديو موضوعات أساسية مثل التعامل مع ترقيم الصفحات، وإدارة حدود معدل الطلبات، ومحاكاة سلوك التصفح البشري.
بالإضافة إلى الإرشادات المفصلة خطوة بخطوة الواردة في الفيديو، يشارك البرنامج التعليمي أيضاً نصائح وحِيلاً مفيدة لتحسين تجربتك في استخراج بيانات الويب. وتشمل استخدام البروكسيات لتجاوز قيود عناوين IP، وتغيير User-Agent ورؤوس الطلبات عشوائياً، وتطبيق معالجة مناسبة للأخطاء لضمان عملية استخراج سلسة ومتواصلة.
كشط بيانات أمازون: الأسئلة الشائعة
عندما يتعلق الأمر باستخراج البيانات من أمازون، وهي منصة تجارة إلكترونية شهيرة، فهناك أمور معينة ينبغي مراعاتها. دعونا نتناول الأسئلة الشائعة المتعلقة بكشط بيانات أمازون.
1. هل كشط بيانات أمازون قانوني؟
كشط البيانات المتاحة للعامة من الإنترنت قانوني، ويشمل ذلك كشط بيانات أمازون. يمكنك قانونيًا كشط معلومات مثل تفاصيل المنتجات وأوصافها وتقييماتها وأسعارها. ومع ذلك، ينبغي توخي الحذر بشأن البيانات الشخصية وحماية حقوق الطبع والنشر عند كشط مراجعات المنتجات. فعلى سبيل المثال، قد يُعد اسم المراجع وصورته الرمزية بيانات شخصية، في حين قد يكون نص المراجعة محميًا بحقوق الطبع والنشر. توخَّ الحذر دائمًا واطلب المشورة القانونية عند كشط مثل هذه البيانات.
2. هل تسمح أمازون بالكشط؟
على الرغم من أن كشط البيانات المتاحة للعامة قانوني، تتخذ أمازون أحيانًا تدابير لمنع الكشط. وتشمل هذه التدابير تحديد معدل الطلبات، وحظر عناوين IP، واستخدام بصمة المتصفح لاكتشاف روبوتات الكشط. عادةً ما تحظر أمازون كشط الويب مع إرجاع رمز استجابة نجاح 200 OK، وتطلب منك اجتياز اختبار CAPTCHA أو تعرض رسالة HTTP Error 503 Service Unavailable للاتصال بقسم المبيعات من أجل الحصول على واجهة برمجة تطبيقات مدفوعة.
توجد طرق للالتفاف على هذه التدابير، لكن كشط الويب الأخلاقي يمكن أن يساعد على تجنب تفعيلها من الأساس. يتضمن كشط الويب الأخلاقي الحد من وتيرة الطلبات، واستخدام وكلاء مستخدم مناسبين، وتجنب الكشط المفرط الذي قد يؤثر في أداء الموقع. ومن خلال الكشط بأخلاقيات، يمكنك تقليل خطر الحظر أو مواجهة عواقب قانونية، مع الاستمرار في استخراج بيانات مفيدة من أمازون.
3. هل كشط بيانات أمازون أخلاقي؟
يتضمن الكشط الأخلاقي احترام الموقع المستهدف. ورغم أنه من غير المرجح أن تتسبب في زيادة الحمل على موقع أمازون بإرسال عدد كبير جدًا من الطلبات، ينبغي لك مع ذلك اتباع إرشادات الكشط الأخلاقي. يمكن للكشط الأخلاقي أن يقلل من خطر مواجهة مشكلات قانونية أو التعامل مع تدابير مكافحة الكشط.
4. كيف يمكنني تجنب الحظر أثناء كشط بيانات أمازون؟
لتجنب الحظر عند كشط بيانات أمازون، ينبغي لك الحد من معدل طلباتك، وتجنب الكشط خلال ساعات الذروة، واستخدام التناوب الذكي للوكلاء، واستخدام وكلاء مستخدم وترويسات مناسبة لتجنب اكتشافك. بالإضافة إلى ذلك، استخرج البيانات التي تحتاج إليها فقط واستخدم أدوات كشط تابعة لجهات خارجية أو مكتبات للكشط.
5. ما مخاطر كشط بيانات أمازون؟
ينطوي كشط بيانات أمازون على مخاطر محتملة، مثل اتخاذ إجراءات قانونية وتعليق الحساب. تستخدم أمازون تدابير لمكافحة الروبوتات لاكتشاف الكشط ومنعه، بما في ذلك حظر عناوين IP، وتحديد معدل الطلبات، وبصمة المتصفح. ومع ذلك، يمكنك الحد من هذه المخاطر من خلال الكشط بأخلاقيات.
الخلاصة
بعد خروجنا من متاهة كشط بيانات أمازون المليئة بالتشويق، حان الوقت للتوقف لحظة وتقدير ما اكتسبناه في هذه الرحلة المفعمة بالإثارة من معارف ومهارات لا تُقدّر بثمن. وباعتبار ProxyCompass دليلك الموثوق، فقد نجحت في اجتياز منعطفات استخراج بيانات قيّمة من عملاق تجارة التجزئة. وبينما تمضي قدمًا مسلحًا بخبرتك الجديدة وتستخدمها ببراعة، تذكّر أن أدغال العالم الرقمي لا تكف عن التطور.
حافظ على فضولك، وواصل صقل منجلك الخاص بكشط الويب، واستمر في التغلب على مشهد استخراج البيانات المتغير باستمرار. إلى أن ننطلق في مغامرتنا الجريئة التالية، أيها المستكشف المقدام، عسى أن تكلل مساعيك المعتمدة على البيانات بالنجاح والمكافآت!